ПЛИС — мои первые шаги
 Недавно я все-таки сделал свой первый шаг к ПЛИС и призвал вас за собой. Мое фанатическое увлечение ПЛИС и идея о том, что ПЛИС является лучшей платформой для создания любых устройств приобрела религиозный характер. Моя секта ПЛИСоводов проповедует полный отказ от микроконтроллеров, а особо экстремистская ветвь проповедует отказ не только от софт процессоров, но и вообще от последовательных вычислений!
Как всегда, постижению истин помогло решение реальных задач. В сегодняшней проповеди я хотел бы рассказать об испытаниях, которые выпадают на долю молодого ПЛИСовода. Преодолевая испытания мы постигаем истину. Но остаются вопросы, на которые я не нашел ответов. Поэтому я бы очень хотел, чтобы братья-хабровчане — ПЛИСоводы с опытом, поучаствовали в обсуждении, протянули руку помощи своим младшим собратьям.
Эта статья для новичков. В ней я опишу типичные проблемы, вопросы, заблуждения, ошибки, которые могут появиться в самом начале обучения (потому что они появились у меня). Однако, контекст статьи ограничен тем, что разработка ведется на ПЛИС от Altera в среде Quartus на языке Verilog.
Трудно жить ничего не делая, но мы не боимся трудностей!
Одна из причин, по которой многие не начинают изучать Verilog вот прямо сейчас — это отсутствие реальной ПЛИС. Кто-то не может заказать, потому что дорого, а кто-то потому, что не знает, что именно взять (вопрос выбора рассмотрен в предыдущей статье). Кому-то ПЛИС пока еще едет по почте.
 Но в своих разработках я пришел к тому, что наличие реальной ПЛИС мне требуется уже на финальном этапе разработки, когда нужно протестировать проект «в железе». Речь о том, что бóльшую часть времени я провожу в отладке своего кода с помощью симуляторов.
Поэтому мой совет: отсутствие ПЛИС — это не повод бездействовать. Пишите и отлаживайте модули для ПЛИС в симуляторах!
Симулятор для Verilog
Итак, чем же развлечь себя скучными длинными рабочими днями (если они таковыми являются)? Конечно же освоеним ПЛИС! Но как же затащить на работу целую среду разработки от Altera, если она весит 3 ежемесячных рабочих лимита интернета? Можно принести на флешке! Но если предметом изучения является Verilog, то можно ограничиться блокнотом, компилятором IcarusVerilog, а результат смотреть в GTK Wave.
Для начала работы в среде Windows, достаточно скачать по ссылке http://bleyer.org/icarus/ файл установки iverilog-20130827_setup.exe (development snapshot) [11.2MB]
Установка трудностей не вызывает. Теперь немного забежим вперед: создадим папку для проекта и в ней пару файлов с пока что не понятным содержимым:
В файле bench.v описан тестовый модуль testbench, в нем создан тестовый источник сигнала clk (меандр). Другие модули будут создаваться в отдельных файлах, либо логику можно протестировать сначала в этом модуле, а потом вынести в отдельный модуль. Потом в модуль testbench будут добавляться экземпляры этих модулей, где мы будем подавать на их входы тестовые сигналы и получать из них результаты. Из модулей мы можем строить иерархию, думаю это понятно всем.
После запуска этого файла мы увидим на экране текст, заданный в $display (это отладочный вывод), значение же сигналов и регистров схемы будут находиться в файле test.vcd. Кликаем по файлу и выбираем программу для просмотра — GTKWave (в моем случае D:\iverilog\gtkwave\bin\gtkwave.exe). Еще пару кликов и мы увидим наш clk.

Практически, каждый свой новый модуль я создаю в блокноте и отлаживаю IcarusVerilog. Следующим этапом после такой отладки идет проверка модулей в Quartus. Хотя в Quartus тоже есть свой симулятор, но я его использую реже. Причина в простоте обновления кода и просмотра результата в IcarusVerilog: сохранил изменения в файле, запустил BAT, нажал кнопку «обновить» в GTKWave — все! В ModelSim для этого требуется чуть больше движений, но он тоже не плох, особенно на данных сложных структур.
После симуляции наступает пора запуска Quartus. Но загружать прошивку в ПЛИС пока еще рано. Нужно убедиться, что божественная вычислительная машина правильно поняла, какую схему мы хотим получить, изложив свои мысли в виде Verilog’а.
Разница между симуляцией и работой в реальном железе
Первое время я, подобно слепому котенку, бился головой об косяки. Казалось бы правильный код, не работает совсем, либо работает не так, как предполагаешь. Либо вот только что работал, а теперь внезапно перестал!
Пытливый котенок, начинает искать взаимосвязь между своими действиями и результатом («голубиное суеверием»).
Самая большая драма
Ниже будет список странностей, но сначала самая большая драма, с которой я столкнулся: не все конструкции Verilog могут быть синтезированы в железе. Это связано с тем, что на Verilog описывается не только аппаратная логика, которая объединяется в модули и работает в железе. На том же Verilog описываются тестовые модули, которые объединяют тестируемые модули, подают на их входы тестовые сигналы и в целом существуют только для проверки на компьютере. Изменение значений сигналов во времени задается конструкциями, содержащим знак «#» в тексте Verilog. Такой знак означает задержку во времени. В примере выше именно так генерируется сигнал CLK. И я грешным делом думал, что таким же образом внутри настоящей ПЛИС можно генерировать, к примеру, последовательность бит для отправки сообщения по RS232. Ведь на вход ПЛИС подан сигнал от генератора 50 МГц! Может быть она как-то на него ориентируется. Как оказалось, я не единственный, кто надеялся на чудо: 1, 2, 3, 4, 5. Реальность как всегда оказывается более суровой: ПЛИС это набор логики и временная задержка в ней может появиться при использовании счетчика, значение которого увеличивается тактами от генератора до заданной величины, либо как-то иначе (но всегда аппаратно).
Список найденных странностей
Удивительные вещи, однако, прочтение книг [1,2] проливает свет на эту бесовщину. Более того, обретается благодать.
Если обозначить reg, то не факт, что он будет создан
Как я пришел к проблеме? Допустим есть один модуль, на вход которого я должен подавать значение (по типу параметра). В перспективе, этот параметр должен будет изменяться во времени в зависимости от каких-то внешних событий. Поэтому значение должно хранится в регистре (reg). Но реализация приема внешних событий пока не реализована, поэтому я регистр не меняю, а просто задаю ему изначальное значение, которое в дальнейшем не меняется.
Казалось бы в чем подвох? В императивных ЯП мы часто задаем переменные в качестве констант и потом ни разу их не меняем и все работает. Что же мы видим в железе? 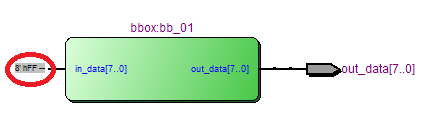
Во-первых, мы не видим регистра. Во-вторых, на вход модуля подано 8’hFF вместо наших 8’d0240! И этого уже достаточно для того, чтобы схема заработала не так, как мы планировали. То, что регистра нет — это нормально. В Verilog можно описывать логику разными способами, в то же время, синтезатор всегда оптимизирует аппаратную реализацию. Даже если написать блок always и в нем работать с регистрами, но при этом выходное значение всегда будет определяться входными, то применение регистра тут окажется лишним и синтезатор его не поставит. И наоборот, если при каких то значениях входных данных выходное значение не меняется, то тут никак не обойтись без регистра-защелки и синтезатор его создаст. (Книга 1 стр. 88-89). Что из этого следует? Если мы начнем менять значение регистра, например, в зависимости от нажатии кнопок, то геристр уже будет создан и все будет работать так, как нужно. Если же окажется, что кнопки ничего не меняют, то синтезатор его опять же выкинет и опять все поломается. Что же делать с константой? Нужно подать ее напрямую на вход модуля:
Теперь на входе модуля мы имеем правильное значение: 
Остается загадкой, почему при сокращении регистра, его значение в initial не подставляется на вход модуля.
Размерность wire лучше задавать самому.
При разработке в среде Quartus, допускается не задавать линии wire заранее. В этом случае они будут созданы автоматически, но об этом будет выдано предупреждение (warning). Проблема заключается в том, что разрядность wire будет 1-бит, а если порты будут иметь разрядность больше 1 бита, то значение не будет передано.
Результат: 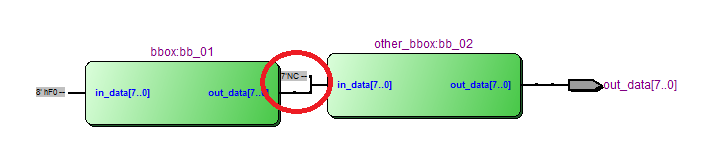
Как видим, один бит подключен, а остальные 7 бит получаются не подключены (NC). Чтобы такой проблемы не было — нужно создать wire самостоятельно. Не зря компилятор IcarusVerilog выдает не warning, а ошибку, если wire не задан заранее.

Компьютер не будет лазать по модулям, смотреть, какая разрядность портов. К тому же, разрядность может оказаться разной, а на вход модуля или с выхода берутся не все биты, а какие-то определенные.
Нельзя использовать выход логической функции, в качестве тактового сигнала
Иногда в проекте требуется снизить тактовую частоту, либо ввести временную задержку в N тактов. Новичёк может применить счетчик и дополнительную схему определения достижения счетчиком определенного значения (схема сравнения). Однако, если напрямую использовать выход со схемы сравнения в качестве тактового, то могут возникнуть проблемы. Это связано с тем, что логической схеме требуется некоторое время для установки стабильного значения на выходе. Эта задержка смещает фронт сигнала, проходящего через разные части логической схемы относительно тактового, в итоге получаются гонки, метастабильность, асинхронщина. Даже довелось однажды услышать реплику об этом в качестве критики ПЛИС: «с ПЛИС постоянные проблемы — гонки сигналов».
то становится ясно, каким образом разрабатываются устройства на ПЛИС: вся задача делится на аппаратные блоки, а данные между ними движутся по конвеерам, синхронно защелкиваясь в регистрах по тактовому сигналу. Таким образом, зная общую тактовую частоту, синтезатор рассчитывает максимальную частоту работы всех комбинаторных схем, определяет, укладывается ли их скорость к период такта и делает вывод — будет или не будет работать схема в ПЛИС. Все это происходит на этапе синтеза. Если схемы укладываются в параметры, то можно прошивать ПЛИС.
Для полного понимания, стоит прочитать Altera handbook на предмет «clock domains», а так же разобраться с тем, как задавать параметры рассчета TimeQuest для проекта.
Таким образом, для разработчиков устройств на базе ПЛИС созданы все необходимые методологии, и если их придерживаться, то проблем не будет.
А что, если я хочу пойти против системы?
Порядок разработки и поведение синтезатора схем подводит нас к выводу о том, что же такое ПЛИС на аппаратном уровне. Это синхронные схемы. Поэтому, среди целей синтезатора — уложиться во временные интервалы. Для этого он, к примеру, упрощает логические выражения, выбрасывает из синтеза части схем, которые не используются другими схемами и не привязаны к физическим выводам ПЛИС. Асинхронные решения и аналоговые трюки не приветствуются, потому что их работа может быть непредсказуемой и зависеть от чего угодно (напряжение, температура, техпроцесс, партия, поколение ПЛИС), а поэтому не дает гарантированного, повторяемого, переносимого результата. А всем же нужен стабильный результат и общие подходы к проектированию!
Но что же делать, если вы не согласны с мнением синтезатора о том, что нужно выкидывать неизменяемые регистры, сокращать логические схемы? Как быть, если хотите делать схемы с асинхронной логикой? Нужна тонкая настройка? А может быть вы сами хотите собрать схему на низкоуровневых компонентах ПЛИС? Легко! Спасибо разработчикам Altera за такую возможность и подробную документацию!
Как это сделать? Можно попробовать графический редактор схем. Вы, возможно, слышали о том, что Quartus позволяет рисовать схемы? Можно самому выбрать стандартные блоки и соединить их. Но это не решение! Даже нарисованная схема будет оптимизирована синтезатором, если на это будет возможность.
В итоге мы приходим к старой истине: если ничего не помогает — прочитайте инструкцию. А именно «Altera Handbook» часть под названием «Quartus II Synthesis Options».
Начнем с того, что описывая архитектуру на Verilog определенным образом, можно получить определенный результат. Вот примеры кода для получения синхронного и асинхронного RS триггера:
В этом случае получится синхронный триггер. 
Если не брать во внимание тактовый сигнал и переключаться в зависимости от любых изменений r и s, то в результате получится элемент с асинхронной установной значений — защелка (latch).

Но можно пойти еще дальше и самому создать защелку из примитива (примитивы доступны так же, как любой другой модуль Verilog):
В итоге, весь «обвес» на входе защелки, который синтезатор посчитал ненужным, исчезнет и мы получим именно то, что хотели:

Список существующих примитивов можно посмотреть на сайте Altera.
А теперь небольшой пример про асинхронность и сокращение. Задумал я, к примеру, сделать генератор по тому же принципу, как это было принято делать раньше, но только на ПЛИС:
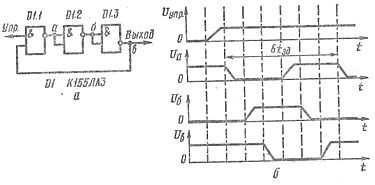
Но для увеличения периода я возьму 4 элемента, но только один из них будет с инверсией:
Но получается сокращение (1 элемент, вместо четырех). Что логично. Но мы то задумывали линию задержки.
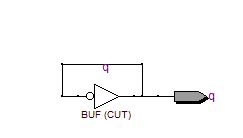

Но если поставить синтезатору условие, что линии a,b,c,d не сокращать, то получится то, что мы задумали. Для подсказки синтезатору применяются директивы. Один из способов указания — это текст в комментарии:
А вот и результат — цепочка из четырех элементов: 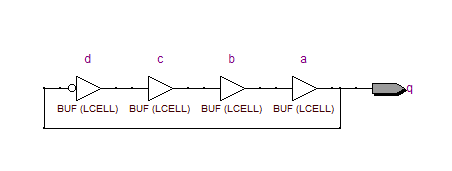
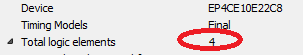
И это далеко не все! Оставлю на радость самостоятельного изучения: работу с case и директиву для реализации его в качестве RAM/ROM или логической схемой; работу со встроенными блоками памяти (RAM/ROM); выбор реализации умножения — аппаратным умножителем или логической схемой.
Выводы
Цитируя статью, хочу сказать, что «ПЛИС-ы / FPGA — не процессоры, «программируя» ПЛИС (заполняя конфигурационную память ПЛИС-а) вы создаете электронную схему (хардвер), в то время как при программировании процессора (фиксированного хардвера) вы подсовываете ему цепочку написанных в память последовательных инструкций программы (софтвер)».
Причем, как бы мне изначально не хотелось сильно не привязываться к конкретной железяке, но иногда, чтобы более эффективно и экономно использовать ресурсы, приходится работать на низком уровне. Часто этого можно избежать, если правильно разрабатывать синхронные схемы. Однако совсем забыть, что это железо — не получается.
Еще хочу сказать, что фанатизма и максимализма со временем поубавилось. Сначала я стремился все действия и рассчеты на ПЛИС выполнять за один такт, потому что ПЛИС это позволяет. Однако, это требуется далеко не всегда. Вычислительные ядра софт процессоров мне пока не довелось использовать, однако применение state machines для работы по определенному алгоритму — стало нормой. Вычисления не за 1 такт, временные задержки в несколько тактов из за применения конвееров — это норма.
Книги, которые мне очень помогли
1. В.В. Соловьев — Основы языка проектирования цифровой аппаратуры Verilog. 2014
2. Altera: Quartus II Handbook
3. Altera: Advanced Synthesis Cookbook
4. Altera: Designing with Low-Level Primitives
Что такое ПЛИС простым языком для начинающих
С чем ассоциируется цифровая электроника? В первую очередь с логическими элементами И, ИЛИ, НЕ. Далее в память приходят сдвиговые регистры, дешифраторы, мультиплексоры и прочее. Однако, по мере роста сложности электронных устройств и тенденции к миниатюризации, создание приборов на базе интегральных микросхем (ИМС) из вышеперечисленных компонентов затруднилось, заказные ИМС нужной топологии и схемотехники оправдывали себя только при крупном тиражировании устройства, в остальных случаях — это было неоправданно дорого.
Выходом из сложившейся ситуации стало развитие программируемых интегральных логических схем (сокращенно — ПЛИС, зарубежная аббревиатура — programmable logic device, PLD). Что это такое и где используется мы расскажем в этой статье.
Содержание статьи
Отличия от микроконтроллеров
При слове «программируемый» у большинства новичков происходит ассоциация с микроконтроллерами. Не смотря на то что их также программируют, ПЛИС — это совершенно другое устройство.
Для разработчиков в микроконтроллерах доступен фиксированный набор решений и средств присущих конкретному чипу, отступить от архитектуры никаким образом не получится. Вам предоставлен набор команд, с помощью которых вы производите операции взаимодействия с окружающей средой, посредством считывания данных с цифровых и аналоговых входов и отправка сигналов исполнительным устройствам с помощью выходов.
Кроме этого вы можете производить вычисления, сохранять данные в регистрах или ПЗУ, а также оперировать данными прошитыми в память микроконтроллера. На этом в сущности и заключается назначение и особенности работы с микроконтроллерами.
Программируемые логические интегральные схемы (ПЛИС) отличаются тем, что, программируя устройство вы сами создаете архитектуру из базовых логических элементов. Таким образом вы получаете высокое быстродействию и гибкость микросхемы. Это даёт возможность, не изменяя одного чипа сделать целый ряд проектов.
Обобщённо внутреннее устройство ПЛИС можно разделить на три основных группы:
1. Массив из логических элементов (макроячеек, логических блоков).
2. Блоки входа-выхода (IO).
3. Линии связи между ними и устройство, которое управляет этими связями.
Однако такое структурирование очень обобщено, немного подробнее мы рассмотрим этот вопрос ниже.
Программируя вы соединяете элементы подобно тому как бы вы это делали, собирая из отдельных элементов устройство и соединяя их входы и выходы проводниками.
Главным отличием ПЛИС от микроконтроллеров является то, что в микроконтроллере вы не можете изменять внутренних связей между простейшими элементами, а в ПЛИС на основе прописывания связей основывается программирование и работа с ними.
Выбор микроконтроллеров происходит на основе множества критериев, таких как:
Быстродействие и тактовая частота;
Объем ПЗУ и ОЗУ;
Количество входов и выходов.
Другие функциональные особенности и периферии, типа поддержки линий связи и протоколов (I2C, one-wire, PWM-сигнал и прочее).
При выборе ПЛИС основным критерием является количество программируемых блоков — их должно хватить для реализации задачи.
В зависимости от конкретного ПЛИС количество блоков может изменяться в широких пределах, соответственно изменяется и стоимость.
Микроконтроллер выполняет последовательно все операции, прописанные в его программе, в то время как блоки ПЛИС выполняют задачу параллельно и независимо друг от друга, поэтому сравнение этих устройств по тактовой частоте нецелесообразно. Слишком различается их принцип работы.
Виды
Актуальными на сегодняшний день являются два основных вида ПЛИС:
1. CPLD (Complex Programmable Logic Device — Программируемая Логическая Интегральная Микросхема, собственно это и есть ПЛИС в её классическом понимании). В ней обычно есть встроенная энергонезависимая памятью, в которую загружается прошивка.
Внутренняя структура строится на матрице макроячеек или логических блоков, а количество элементов в них лежит в пределах сотен и тысяч штук. Благодаря относительной простоте стоят дешевле чем следующий вид программируемой логики. Всё это приводит к тому, что используется CPLD в основном в схемах, где нужна высокая скорость и большое число выводов, при этом выполняют несложные задачи.
2. FPGA (Field-Programmable Gate Array — Программируемая Пользователем Вентильная Матрица, однако её часто относят к ПЛИС) — более развитые и сложные устройства по сравнению с CPLD, строятся на логических блоках с гибкой коммутаций и содержат большее число элементов (десятки или сотни тысяч штук).
Прошивка, как правило, хранится во внешней энергонезависимой памяти. Кроме простейших логических элементов в FPGA могут содержаться готовые блоки для выполнения каких-либо операций, например, блоки обработки сигнала DSP. Всё это позволяет реализовать процессор, устройства обработки сигналов и другие сложные устройства.
Интересно:
Хотя фактически наличие энергонезависимой памяти не делает программируемую логику CPLD. Это частично заблуждение. Главным отличием CPLD от FPGA является внутренняя структура.
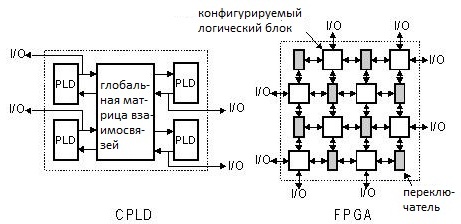
Подробнее внутреннее устройство CPLD изображено на рисунке ниже.
А примерная схема её макроячейки выглядит таким образом:
Макроячейка состоит из программируемых мультиплексоров, триггеров (одного или нескольких) и формирует группу выходных сигналов ФБ в нескольких их вариантах.
Ниже приведен еще один пример – блок-схема CPLD микросхемы семейства MAX II фирмы Altera.
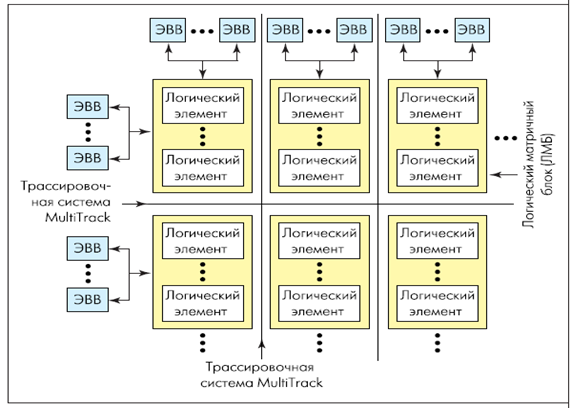
И структурный план микросхем этого же семейства.
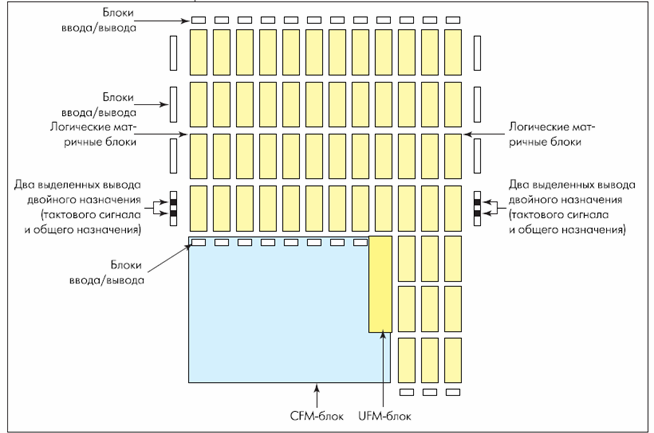
Промежуточные шины макроячейкам назначаются с помощью такого узла, как распределитель, на англ. он звучит как Logic Allocator, что изображено на схеме ниже, на ней же изображена матрица переключений (Global Routing Pool), а у выходных макроячейки (macrocells) имеют по две обратных связи.
Внешние выводы микросхемы соединяются с выходами макроячеек через еще один блок (матрицу) – ORP (Output Routing Pool), обратите внимание, что через неё же происходит соединение ВХОДНОЙ логики с GRP, что изображено на иллюстрации ниже.
В некоторых CPLD есть т.н. прямые входы (Direct Input) – они соединены со входами ячеек напрямую, что уменьшает задержки.
У FPGA структура имеет вид:
L – логический конфигурируемый блок;
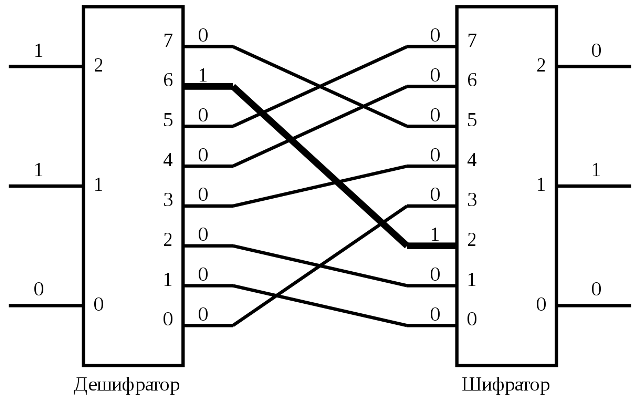
S (substitution block) – блок подстановок, он получает на ход определенное число бит, преобразует, по определенному алгоритму, а на выходе выдаёт другое число бит. Другими словами – дешифратор, шифратор и коммутатор.
C (connection block) – блок соединений.
Программирование
HDL (Hardware Description Language, рус. Язык описания аппаратуры) — так называется язык с помощью которого программируются ПЛИС. Популярными и универсальными являются Verilog HDL и VHDL. Существуют и другие языки, например, присущие конкретным производителям, как AHDL для изделий компании ALTERA.
Разработчикам, которые работают с ПЛИС доступно графическое программирование. То есть вы можете просто рисовать логические схемы или комбинировать код с графикой. Последнее называют модульным методом разработки, когда конкретные модули прописываются, а верхний модуль, в котором всё объединяется программируется графическим способом.
Подборка полезных статей про микроконтроллеры:
Примеры популярных производителей и серий ПЛИС
На момент написания статьи наиболее известными являются изделия двух производителей.
FPGA. Разбираемся, как устроены программируемые логические схемы и чем они хороши
Может быть, ты умеешь взламывать устройства на другом конце света или кодить крутые веб-приложения, но понимаешь ли ты, как работает твой компьютер? И речь не о том, что делает операционка, как функционирует garbage collector в Java или как устроен компилятор C++. Я говорю о самом низком, аппаратном уровне, ниже ассемблера: как работает железо.
Что происходит в микросхеме сетевой карты, когда приходит пакет Ethernet? Как этот пакет передается дальше в оперативную память компьютера через шину PCI Express? Как работают самые быстрые системы распознавания изображений на аппаратном уровне?
Для ответа на эти вопросы надо немного разбираться в цифровой логике работы микросхем ASIC, но начинать с них очень сложно и дорого, и вместо этого лучше начать с FPGA.
FPGA расшифровывается как field-programmable gate array, по-русски — программируемые пользователем вентильные матрицы, ППВМ. В более общем случае они называются ПЛИС — программируемые логические интегральные схемы.
С помощью FPGA можно в буквальном смысле проектировать цифровые микросхемы, сидя у себя дома с доступной отладочной платой на столе и софтом разработчика за пару килобаксов. Впрочем, есть и бесплатные варианты. Заметь: именно проектировать, а не программировать, потому что на выходе получается физическая цифровая схема, выполняющая определенный алгоритм на аппаратном уровне, а не программа для процессора.
Работает это примерно так. Есть готовая печатная плата с набором интерфейсов, которые подключены к установленной на плате микросхеме FPGA, вроде крутой платы для дата-центра или отладочной платы для обучения.
Пока мы не сконфигурируем FPGA, внутри микросхемы просто нет логики для обработки данных с интерфейсов, и потому работать ничего, очевидно, не будет. Но в результате проектирования будет создана прошивка, которая после загрузки в FPGA создаст нужную нам цифровую схему. Например, так можно создать контроллер 100G Ethernet, который будет принимать и обрабатывать сетевые пакеты.
Важная особенность FPGA — возможность реконфигурации. Сегодня нам нужен контроллер 100G Ethernet, а завтра эта же плата может быть использована для реализации независимых четырех интерфейсов 25G Ethernet.
Существуют два крупных производителя FPGA-чипов: Xilinx и Intel, которые контролируют 58 и 42% рынка соответственно. Основатели Xilinx изобрели первый чип FPGA в далеком 1985 году. Intel пришла на рынок недавно — в 2015 году, поглотив компанию Altera, которая была основана в то же время, что и Xilinx. Технологии Xilinx и Altera во многом схожи, как и среды разработки. Чаще я работал с продуктами компании Xilinx, поэтому не удивляйся ее постоянному упоминанию.
FPGA широко применяются в разных устройствах: потребительской электронике, оборудовании телекома, платах-ускорителях для применения в дата-центрах, различной робототехнике, а также при прототипировании микросхем ASIC. Пару примеров я разберу чуть ниже.
Также рассмотрим технологию, которая обеспечивает аппаратную реконфигурацию, познакомимся с процессом проектирования и разберем простой пример реализации аппаратного счетчика на языке Verilog. Если у тебя есть любая отладочная плата FPGA, ты сможешь повторить это самостоятельно. Если платы нет, то все равно сможешь познакомиться с Verilog, смоделировав работу схемы на своем компе.
Принцип работы
Микросхема FPGA — это та же заказная микросхема ASIC, состоящая из таких же транзисторов, из которых собираются триггеры, регистры, мультиплексоры и другие логические элементы для обычных схем. Изменить порядок соединения этих транзисторов, конечно, нельзя. Но архитектурно микросхема построена таким хитрым образом, что можно изменять коммутацию сигналов между более крупными блоками: их называют CLB — программируемые логические блоки.
Также можно изменять логическую функцию, которую выполняет CLB. Достигается это за счет того, что вся микросхема пронизана ячейками конфигурационной памяти Static RAM. Каждый бит этой памяти либо управляет каким-то ключом коммутации сигналов, либо является частью таблицы истинности логической функции, которую реализует CLB.
Так как конфигурационная память построена по технологии Static RAM, то, во-первых, при включении питания FPGA микросхему обязательно надо сконфигурировать, а во-вторых, микросхему можно реконфигурировать практически бесконечное количество раз.

Очень упрощенная 2D-структура микросхемы без конфигурационной памяти
Другие статьи в выпуске: 
Xakep #236. FPGA
Блоки CLB находятся в коммутационной матрице, которая задает соединения входов и выходов блоков CLB.
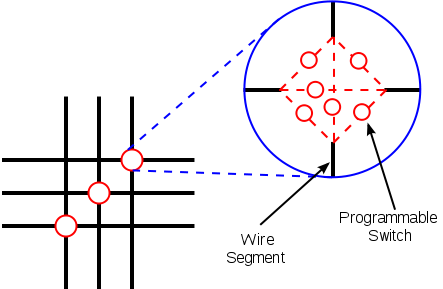
Схема коммутационной матрицы
На каждом пересечении проводников находится шесть переключающих ключей, управляемых своими ячейками конфигурационной памяти. Открывая одни и закрывая другие, можно обеспечить разную коммутацию сигналов между CLB.
CLB очень упрощенно состоит из блока, задающего булеву функцию от нескольких аргументов (она называется таблицей соответствия — Look Up Table, LUT) и триггера (flip-flop, FF). В современных FPGA LUT имеет шесть входов, но на рисунке для простоты показаны три. Выход LUT подается на выход CLB либо асинхронно (напрямую), либо синхронно (через триггер FF, работающий на системной тактовой частоте).
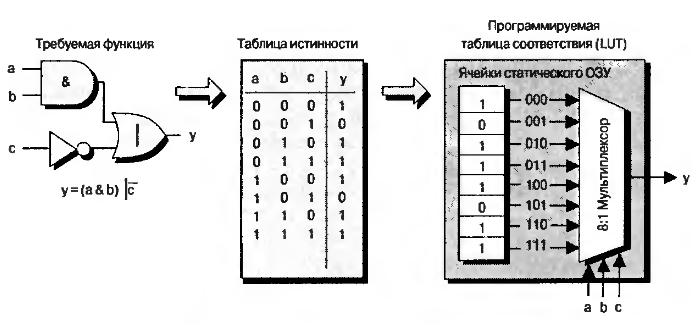
Принцип реализации LUT
Интересно посмотреть на принцип реализации LUT. Пусть у нас есть некоторая булева функция y = (a & b) |
c . Ее схемотехническое представление и таблица истинности показаны на рисунке. У функции три аргумента, поэтому она принимает 2^3 = 8 значений. Каждое из них соответствует своей комбинации входных сигналов. Эти значения вычисляются программой для разработки прошивки ПЛИС и записываются в специальные ячейки конфигурационной памяти.
Значение каждой из ячеек подается на свой вход выходного мультиплексора LUT, а входные аргументы булевой функции используются для выбора того или иного значения функции. CLB — важнейший аппаратный ресурс FPGA. Количество CLB в современных кристаллах FPGA может быть разным и зависит от типа и емкости кристалла. У Xilinx есть кристаллы с количеством CLB в пределах примерно от четырех тысяч до трех миллионов.
Помимо CLB, внутри FPGA есть еще ряд важных аппаратных ресурсов. Например, аппаратные блоки умножения с накоплением или блоки DSP. Каждый из них может делать операции умножения и сложения 18-битных чисел каждый такт. В топовых кристаллах количество блоков DSP может превышать 6000.
Другой ресурс — это блоки внутренней памяти (Block RAM, BRAM). Каждый блок может хранить 2 Кбайт. Полная емкость такой памяти в зависимости от кристалла может достигать от 20 Кбайт до 20 Мбайт. Как и CLB, BRAM и DSP-блоки связаны коммутационной матрицей и пронизывают весь кристалл. Связывая блоки CLB, DSP и BRAM, можно получать весьма эффективные схемы обработки данных.
Применение и преимущества FPGA
Первый чип FPGA, созданный Xilinx в 1985 году, содержал всего 64 CLB. В то время интеграция транзисторов на микросхемах была намного ниже, чем сейчас, и в цифровых устройствах часто использовались микросхемы «рассыпной логики». Были отдельно микросхемы регистров, счетчиков, мультиплексоров, умножителей. Под конкретное устройство создавалась своя печатная плата, на которой устанавливались эти микросхемы низкой интеграции.
Использование FPGA позволило отказаться от такого подхода. Даже FPGA на 64 CLB значительно экономит место на печатной плате, а доступность реконфигурации добавила возможность обновлять функциональность устройств уже после изготовления во время эксплуатации, как говорят «in the field» (отсюда и название — field-programmable gate array).
За счет того, что внутри FPGA можно создать любую аппаратную цифровую схему (главное, чтобы хватило ресурсов), одно из важных применений ПЛИС — это прототипирование микросхем ASIC.
Разработка ASIC очень сложна и затратна, цена ошибки очень высока, и вопрос тестирования логики критичен. Поэтому одним из этапов разработки еще до начала работы над физической топологией схемы стало ее прототипирование на одном или нескольких кристаллах FPGA.
Для разработки ASIC выпускают специальные платы, содержащие много FPGA, соединенных между собой. Прототип микросхемы работает на значительно меньших частотах (может быть, десятки мегагерц), но позволяет сэкономить на выявлении проблем и багов.
Однако, на мой взгляд, существуют более интересные применения ПЛИС. Гибкая структура FPGA позволяет реализовывать аппаратные схемы для высокоскоростной и параллельной обработки данных с возможностью изменить алгоритм.
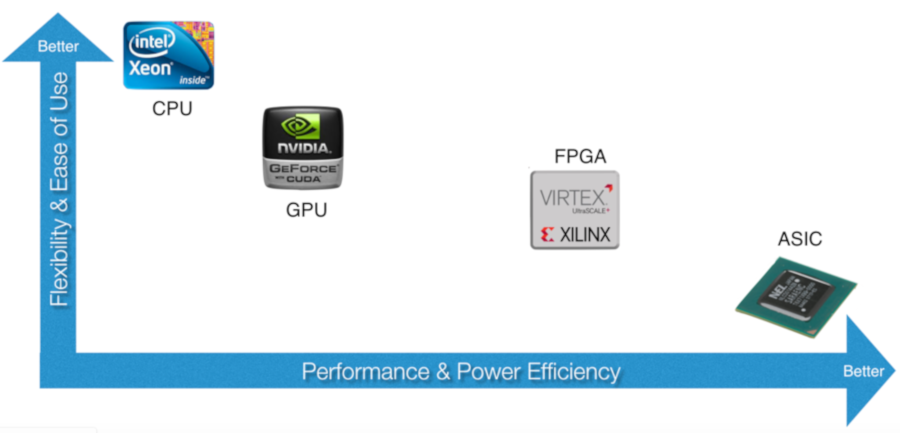
Сравнение аппаратных платформ
Давай подумаем, чем принципиально отличаются CPU, GPU, FPGA и ASIC. CPU универсален, на нем можно запустить любой алгоритм, он наиболее гибок, и использовать его легче всего благодаря огромному количеству языков программирования и сред разработки.
При этом из-за универсальности и последовательного выполнения инструкций CPU снижается производительность и повышается энергопотребление схемы. Происходит это потому, что на каждую полезную арифметическую операцию CPU совершает много дополнительных операций, связанных с чтением инструкций, перемещением данных между регистрами и кешем, и другие телодвижения.
На другой стороне находится ASIC. На этой платформе требуемый алгоритм реализуется аппаратно за счет прямого соединения транзисторов, все операции связаны только с выполнением алгоритма и нет никакой возможности изменить его. Отсюда максимальная производительность и наименьшее энергопотребление платформы. А вот перепрограммировать ASIC невозможно.
Справа от CPU находится GPU. Изначально эти микросхемы были разработаны для обработки графики, но сейчас используются и для майнинга вычислений общего назначения. Они состоят из тысяч небольших вычислительных ядер и выполняют параллельные операции над массивом данных.
Если алгоритм можно распараллелить, то на GPU получится добиться значительного ускорения по сравнению с CPU. С другой стороны, последовательные алгоритмы будут реализовываться хуже, поэтому платформа оказывается менее гибкой, чем CPU. Также для разработки под GPU надо иметь специальные навыки, знать OpenCL или CUDA.
Наконец, FPGA. Эта платформа сочетает эффективность ASIC с возможностью менять программу. ПЛИС не универсальны, но существует класс алгоритмов и задач, которые на них будут показывать лучшую производительность, чем на CPU и даже GPU. Сложность разработки под FPGA выше, однако новые средства разработки делают этот разрыв меньше.
Решающее же преимущество FPGA — это способность обрабатывать данные в темпе их поступления с минимальной задержкой реакции. В качестве примера можешь вообразить умный сетевой маршрутизатор с большим количеством портов: при поступлении пакета Ethernet на один из его портов необходимо проверить множество правил, прежде чем выбрать выходной порт. Возможно, потребуется изменение некоторых полей пакета или добавление новых.
Использование FPGA позволяет решать эту задачу мгновенно: байты пакета еще только начали поступать в микросхему из сетевого интерфейса, а его заголовок уже анализируется. Использование процессоров тут может существенно замедлить скорость обработки сетевого трафика. Ясно, что для маршрутизаторов можно сделать заказную микросхему ASIC, которая будет работать наиболее эффективно, но что, если правила обработки пакетов должны меняться? Достичь требуемой гибкости в сочетании с высокой производительностью поможет только FPGA.
Таким образом, FPGA используются там, где нужна высокая производительность обработки данных, наименьшее время реакции, а также низкое энергопотребление.
FPGA in the cloud
В облачных вычислениях FPGA применяются для быстрого счета, ускорения сетевого трафика и осуществления доступа к массивам данных. Сюда же можно отнести использование FPGA для высокочастотной торговли на биржах. В серверы вставляются платы FPGA с PCI Express и оптическим сетевым интерфейсом производства Intel (Altera) или Xilinx.
На FPGA отлично ложатся криптографические алгоритмы, сравнение последовательностей ДНК и научные задачи вроде молекулярной динамики. В Microsoft давно используют FPGA для ускорения поискового сервиса Bing, а также для организации Software Defined Networking внутри облака Azure.
Бум машинного обучения тоже не обошел стороной FPGA. Компании Xilinx и Intel предлагают средства на основе FPGA для работы с глубокими нейросетями. Они позволяют получать прошивки FPGA, которые реализуют ту или иную сеть напрямую из фреймворков вроде Caffe и TensorFlow.
Причем это все можно попробовать, не выходя из дома и используя облачные сервисы. Например, в Amazon можно арендовать виртуальную машину с доступом к плате FPGA и любым средствам разработки, в том числе и machine learning.
FPGA on the edge
Что еще интересное делают на FPGA? Да чего только не делают! Робототехника, беспилотные автомобили, дроны, научные приборы, медицинская техника, пользовательские мобильные устройства, умные камеры видеонаблюдения и так далее.
Традиционно FPGA применялись для цифровой обработки одномерных сигналов (и конкурировали с процессорами DSP) в устройствах радиолокации, приемопередатчиках радиосигналов. С ростом интеграции микросхем и увеличением производительности платформы FPGA стали все больше применяться для высокопроизводительных вычислений, например для обработки двумерных сигналов «на краю облака» (edge computing).
Эту концепцию легче всего понять на примере видеокамеры для анализа автомобильного трафика с функцией распознавания номеров машин. Можно взять камеру с возможностью передачи видео через Ethernet и обрабатывать поток на удаленном сервере. С ростом числа камер будет расти и нагрузка на сеть, что может привести к сбоям системы.
Вместо этого лучше реализовать распознавание номеров на вычислителе, установленном прямо в корпус видеокамеры, и передавать в облако номера машин в формате текста. Для этого даже можно взять сравнительно недорогие FPGA с низким энергопотреблением, чтобы обойтись аккумулятором. При этом остается возможность изменять логику работы FPGA, например, при изменении стандарта автомобильных номеров.
Что до робототехники и дронов, то в этой сфере как раз особенно важно выполнять два условия — высокая производительность и низкое энергопотребление. Платформа FPGA подходит как нельзя лучше и может использоваться, в частности, для создания полетных контроллеров для беспилотников. Уже сейчас делают БПЛА, которые могут принимать решения на лету.
Как разрабатывать проект на FPGA?
Существуют разные уровни проектирования: низкий, блочный и высокий. Низкий уровень предполагает использование языков типа Verilog или VHDL, на которых ты управляешь разработкой на уровне регистровых передач (RTL — register transfer level). В этом случае ты формируешь регистры, как в процессоре, и определяешь логические функции, изменяющие данные между ними.
Схемы FPGA всегда работают на определенных тактовых частотах (обычно 100–300 МГц), и на уровне RTL ты определяешь поведение схемы с точностью до такта системной частоты. Эта кропотливая работа приводит к созданию максимально эффективных схем с точки зрения производительности, потребления ресурсов кристалла FPGA и энергопотребления. Но тут требуются серьезные скиллы в схемотехнике, да и с ними процесс небыстрый.
На блочном уровне ты занимаешься в основном соединением уже готовых крупных блоков, которые выполняют определенные функции, для получения нужной тебе функциональности системы на кристалле (system-on-chip).
На высоком уровне проектирования ты уже не будешь контролировать данные на каждом такте, вместо этого сконцентрируешься на алгоритме. Существуют компиляторы или трансляторы с языков C и C++ на уровень RTL, например Vivado HLS. Он довольно умный и позволяет транслировать на аппаратный уровень широкий класс алгоритмов.
Главное преимущество такого подхода перед языками RTL — ускорение разработки и особенно тестирования алгоритма: код на C++ можно запустить и верифицировать на компьютере, и это будет намного быстрее, чем тестировать изменения алгоритма на уровне RTL. За удобство, конечно, придется заплатить — схема может получиться не такой быстрой и займет больше аппаратных ресурсов.
Часто мы готовы платить эту цену: если грамотно использовать транслятор, то эффективность не сильно пострадает, а ресурсов в современных FPGA достаточно. В нашем мире с критичным показателем time to market это оказывается оправданным.
Часто в одном дизайне нужно совместить все три стиля разработки. Допустим, нам нужно сделать устройство, которое мы могли бы встроить в робота и наделить его способностью распознавать объекты в видеопотоке — например, дорожные знаки. Возьмем микросхему видеосенсора и подключим ее напрямую к FPGA. Для отладки можем использовать монитор HDMI, тоже подключенный к FPGA.
Кадры с камеры будут передаваться в FPGA по интерфейсу, который заведомо определен производителем сенсора (USB тут не катит), обрабатываться и выводиться на монитор. Для обработки кадров понадобится фреймбуфер, который обычно находится во внешней памяти DDR, установленной на печатной плате рядом с микросхемой FPGA.
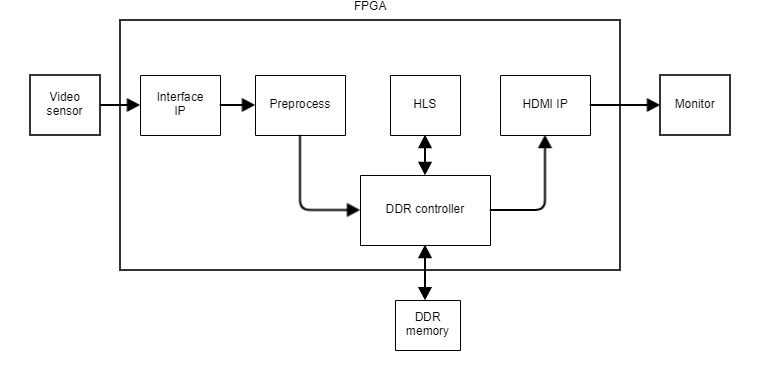
Типичная блок-схема проекта FPGA
Если производитель видеосенсора не предоставляет Interface IP для нашей микросхемы FPGA, то нам придется писать его самостоятельно на языке RTL, считая такты, биты и байты в соответствии со спецификацией протокола передачи данных. Блоки Preprocess, DDR Controller и HDMI IP мы, скорее всего, возьмем готовые и просто соединим их интерфейсы. А блок HLS, который выполняет поиск и обработку поступающих данных, мы можем написать на C++ и транслировать при помощи Vivado HLS.
Скорее всего, нам еще потребуется какая-то готовая библиотека детектора и классификатора дорожных знаков, адаптированная для использования в FPGA. В этом примере я, конечно, привожу сильно упрощенную блок-схему дизайна, но логику работы она отражает корректно.
Рассмотрим путь проектирования от написания кода RTL до получения конфигурационного файла для загрузки в FPGA.
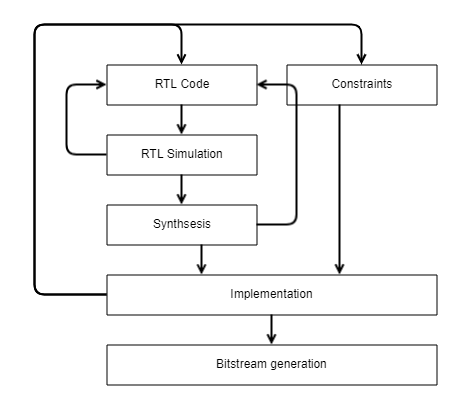
Путь проектирования
Итак, ты пишешь код RTL, который реализует нужную тебе схему. Прежде чем его проверять на реальном железе, надо убедиться, что он верный и корректно решает требуемую задачу. Для этого используется RTL-моделирование в симуляторе на компьютере.
Ты берешь свою схему, представленную пока только в коде RTL, и помещаешь ее на виртуальный стенд, где подаешь последовательности цифровых сигналов на входы схемы, регистрируешь выходные диаграммы, зависимости от времени выходных сигналов и сравниваешь с ожидаемыми результатами. Обычно ты находишь ошибки и возвращаешься к написанию RTL.
Далее логически верифицированный код подается на вход программе-синтезатору. Она преобразует текстовое описание схемы в связанный список цифровых элементов из библиотеки, доступной для данного кристалла FPGA. В этом списке будут отображены такие элементы, как LUT, триггеры, и связи между ними. На этой стадии элементы пока никак не привязаны к конкретным аппаратным ресурсам. Чтобы это сделать, требуется наложить на схему ограничения (Constraints) — в частности, указать, с какими физическими контактами ввода-вывода микросхемы FPGA связаны логические входы и выходы твоей схемы.
В этих ограничениях также требуется указать, на каких тактовых частотах должна работать схема. Выход синтезатора и файл ограничений отдаются процессору Implementation, который, помимо прочего, занимается размещением и трассировкой (Place and Route).
Процесс Place каждый пока еще обезличенный элемент из netlist привязывает к конкретному элементу внутри микросхемы FPGA. Далее начинает работу процесс Route, который пытается найти оптимальное соединение этих элементов для соответствующей конфигурации коммутационной матрицы ПЛИС.
Place и Route действуют, исходя из ограничений, наложенных нами на схему: контактами ввода-вывода и тактовой частотой. Период тактовой частоты очень сильно влияет на Implementation: он не должен быть меньше, чем временная задержка на логических элементах в критической цепи между двумя последовательными триггерами.
Часто сразу удовлетворить это требование не удается, и тогда надо вернуться на начальный этап и изменить код RTL: например, попытаться сократить логику в критической цепи. После успешного завершения Implementation нам известно, какие элементы где находятся и как они связаны.
Только после этого запускается процесс создания бинарного файла прошивки FPGA. Остается его загрузить в реальное железо и проверить, работает ли оно так, как ожидалось. Если на этом этапе возникают проблемы, значит, моделирование было неполным и на этом этапе не были устранены все ошибки и недочеты.
Можно вернуться на стадию симуляции и смоделировать нештатную ситуацию, а если и это не сработает, на крайний случай предусмотрен механизм отладки непосредственно в работающем железе. Ты можешь указать, какие сигналы хочешь отслеживать во времени, и среда разработки сгенерирует дополнительную схему логического анализатора, которая размещается на кристалле рядом с твоей разрабатываемой схемой, подключается к интересующим тебя сигналам и сохраняет их значения во времени. Сохраненные временные диаграммы нужных сигналов можно выгрузить на компьютер и проанализировать.
Существуют и высокоуровневые средства разработки (HLS, High-level synthesis), и даже готовые фреймворки для создания нейросетей в ПЛИС. Эти средства на выходе генерят код RTL на языках VHDL или Verilog, который дальше спускается по цепочке Synthesis → Implementation → Bitstream generation. Ими вполне можно пользоваться, но, чтобы использовать их эффективно, надо иметь хотя бы минимальное представление о языках уровня RTL.
Продолжение следует
Надеюсь, теория тебя не слишком загрузила! В следующей статье я расскажу о практике: мы посмотрим, что конкретно нужно делать, чтобы запрограммировать FPGA.
Значение слова «плис»
ПЛИС, -а, м. Ткань из грубой пряжи с ворсом, похожая на бархат; хлопчатобумажный бархат. Ситцы есть у нас богатые, Есть миткаль, кумач и плис. Н. Некрасов, Коробейники. На ногах у него были теплые сапоги, обшитые плисом. Короленко, Сон Макара.
[Швед. plys от лат. pilus — волос]
Источник (печатная версия): Словарь русского языка: В 4-х т. / РАН, Ин-т лингвистич. исследований; Под ред. А. П. Евгеньевой. — 4-е изд., стер. — М.: Рус. яз.; Полиграфресурсы, 1999; (электронная версия): Фундаментальная электронная библиотека
- Программи́руемая логи́ческая интегра́льная схе́ма (ПЛИС, англ. programmable logic device, PLD) — электронный компонент, используемый для создания цифровых интегральных схем. В отличие от обычных цифровых микросхем, логика работы ПЛИС не определяется при изготовлении, а задаётся посредством программирования (проектирования). Для программирования используются программатор и IDE (отладочная среда), позволяющие задать желаемую структуру цифрового устройства в виде принципиальной электрической схемы или программы на специальных языках описания аппаратуры: Verilog, VHDL, AHDL и др. Альтернативой ПЛИС являются:
программируемые логические контроллеры (ПЛК);
базовые матричные кристаллы (БМК), требующие заводского производственного процесса для программирования;
ASIC — специализированные заказные большие интегральные схемы (БИС), которые при мелкосерийном и единичном производстве существенно дороже;
специализированные компьютеры, процессоры (например, цифровой сигнальный процессор) или микроконтроллеры, которые из‑за программного способа реализации алгоритмов в работе медленнее ПЛИС.
Некоторые производители для своих ПЛИС предлагают программные процессоры, которые можно модифицировать под конкретную задачу, а затем встроить в ПЛИС. Тем самым:
обеспечивается увеличение свободного места на печатной плате (возможность уменьшения размеров платы);
упрощается проектирование самой ПЛИС;
Плис (швед. plys от лат. pilus — «волос») — хлопчатобумажная ткань из грубой пряжи, с ворсом, похожим на бархатный, род хлопчатобумажного бархата.
ПЛИС, а, м. [шведск. plys от латин. pilus — волос]. Хлопчатобумажная ткань из грубой пряжи, с ворсом, похожим на бархатный, род хлопчатобумажного бархата.
Источник: «Толковый словарь русского языка» под редакцией Д. Н. Ушакова (1935-1940); (электронная версия): Фундаментальная электронная библиотека
1. текст. хлопчатобумажная ворсистая ткань; хлопчатобумажный бархат
2. разг. изделия из такой ткани
Делаем Карту слов лучше вместе
/>Привет! Меня зовут Лампобот, я компьютерная программа, которая помогает делать Карту слов. Я отлично умею считать, но пока плохо понимаю, как устроен ваш мир. Помоги мне разобраться!
Спасибо! Я стал чуточку лучше понимать мир эмоций.
Вопрос: арнаутский — это что-то нейтральное, положительное или отрицательное?