Rops tmus что это
Необходимость узнать характеристики видеокарты может возникнуть в различных ситуациях. Например, характеристики видеокарты могут потребоваться перед установкой драйверов или новой компьютерной игры.
Если вам нужно узнать характеристики видеокарты, то для этого лучше всего воспользоваться программой GPU-Z. Это небольшая бесплатная программа, которая не требует установки. Программа отлично работает на Windows 7 и Windows 10, поэтому с ее запуском не должно возникнуть никаких проблем. Скачать программу можно на сайте разработчика по адресу https://www.techpowerup.com/gpuz/.
Скачав и запустив данную программу на на Windows 7 или Windows 10 вы увидите небольшое окно с тремя вкладками. Первая вкладка называется « Graphics Card ». Здесь сосредоточена вся информация о технических характеристиках видеокарты.
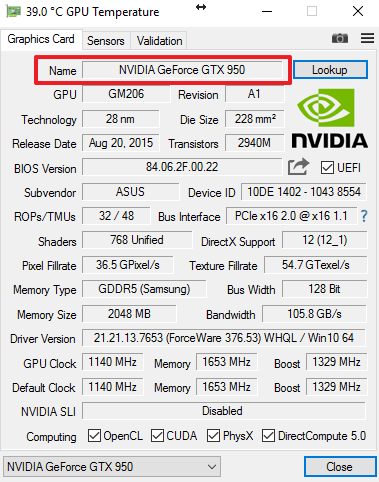
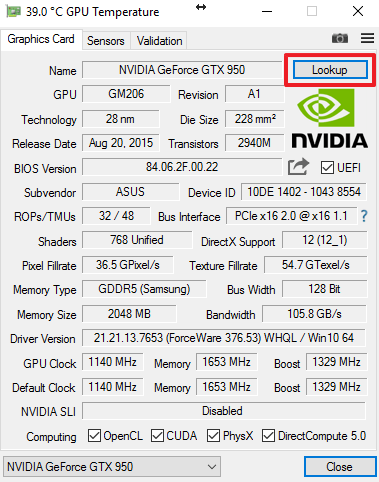
В самом верху, в поле указывается название видеокарты.
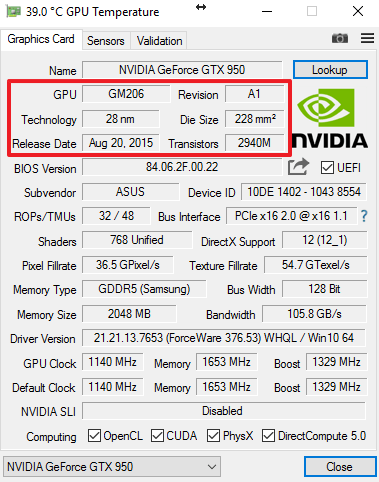
Чуть ниже название графического чипа (GPU), а также его основные характеристики (ревизия, техпроцесс, размер кристалла, дата выхода, количество транзисторов).
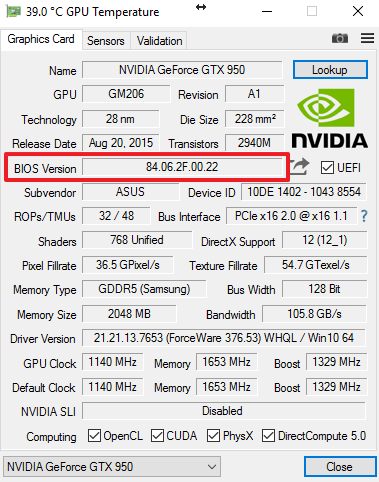
Дальше указывается версия BIOS видеокарты. Нужно отметить, что BIOS видеокарты это не тоже самое что BIOS материнской платы. У видеокарт есть свой собственный BIOS, никак не зависящий от BIOS материнской платы.
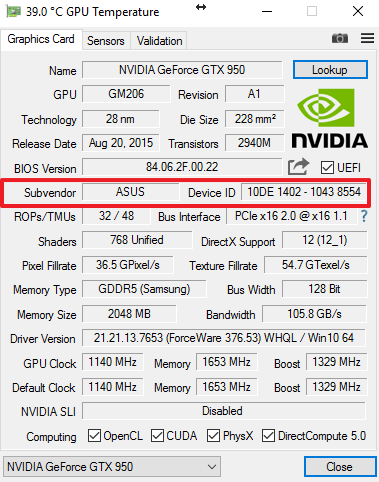
Дальше название производителя видеокарты и ее Device ID. С помощью Device ID можно определить полное название видеокарты и найти драйверы для нее.
Нужно понимать, что производитель видеокарты и производитель чипов это не одно и тоже. Компании AMD и NVIDIA производят чипы для видеокарт и разрабатывают референсные видеокарты. Тогда как производителя видеокарт (такие как MSI, ASUS, GIGABUTE и другие) используют эти чипы и референсные видеокарты для разработки и производства уже готовых к использованию массовых видеокарт.
В правом верхнем углу окна есть кнопка « Lookup ». Если нажать на нее, то откроется веб-страница с характеристиками видеокарты на сайте https://www.techpowerup.com. Таким образом можно быстро узнать полное название видеокарты, которая установлена в компьютере.
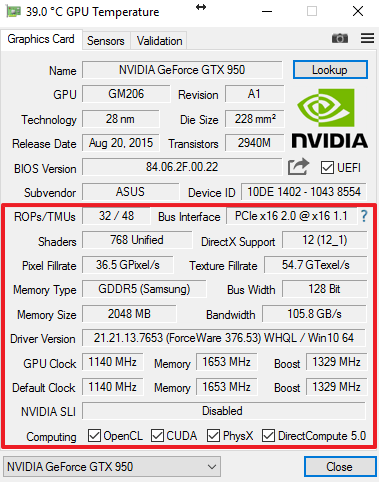
В нижней части окна расположен целый блок характеристик видеокарты.
- ROPs/TMUs – количество блоков растеризации (ROP) и текстурирования (TMU).
- Bus Interface – характеристики интерфейса PCI-express, который используется для подключения видеокарты. Эти характеристики зависят от материнской платы, количества установленных видеокарт, а также режима их работы.
- Shaders – количество шейдерных процессоров.
- DirectX Support – версия DirectX, которую поддерживает данная видеокарта.
- Pixel Fillrate – скорость пиксельного заполнения.
- Texture Flillrate – скорость заполнения текстурами.
- Memory Type – тип памяти, который используется на видеокарте. В некоторых случаях, здесь также указывается производитель чипов памяти.
- Bus Width – ширина шины межу видео памятью и графическим процессором видеокарты.
- Memory Size – объем видео памяти, который установлен на видеокарте.
- Bandwidth – пропускная способность канала, между видео памятью и графическим процессором видеокарты.
- Driver Version – версия драйвера видеокарты, который установлен в операционной системе.
- GPU Clock – тактовая частота графического процессора (с разгоном).
- Memory – частота видео памяти (с разгоном).
- Boost – тактовая частота графического процессора в Boost режиме (с разгоном).
- Default Clock – стандартная тактовая частота графического процессора (без разгона).
- Default Memory – стандартная частота видео памяти (без разгона).
- Default Boost – стандартная тактовая частота графического процессора в Boost режиме (без разгона).
- ATI CrossFire или Nvidia SLI – характеристика видеокарты, указывающая на использование связки из нескольких видеокарт.
- Computing – поддержка технологий, ускоряющих обработку некоторых процессов в компьютерных играх и профессиональных программах.
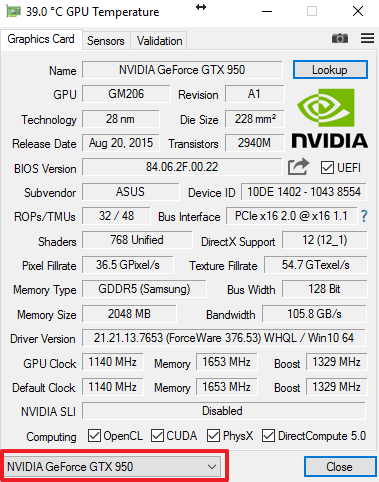
В самом низу есть выпадающий список видеокарт. Если в системе используется больше одной видеокарты, то с помощью данного выпадающего списка можно переключаться между разными видеокартами и просматривать их характеристики.
Если вы хотите узнать не только технические характеристики видеокарты, но и текущие параметры ее работы. То для этого перейти на вкладку « Sensors ».
Здесь можно получить следующую информацию:
- GPU Core Clock – текущая тактовая частота графического процессора видеокарты.
- GPU Memory Clock – текущая тактовая частота видео памяти видеокарты.
- GPU Temperature – текущая температура графического чипа видеокарты.
- Fan Speed (%) – текущая скорость вращения вентиляторов на видеокарте (в процентах от максимальной скорости).
- Fan speed (rpm) – текущая скорость вращения вентиляторов на видеокарте (в оборотах за минуту).
- Memory Used – используемая видео память.
- GPU Load – загрузка графического процессора видеокарты.
- Memory Controller Load – загрузка контроллера видео памяти.
- Video Engine Load – загрузка видео движка.
- Bus Interface Load – загрузка шины памяти.
- Power Consumption – уровень тепловыделения.
- VDDC – напряжение на графический процессор видеокарты.
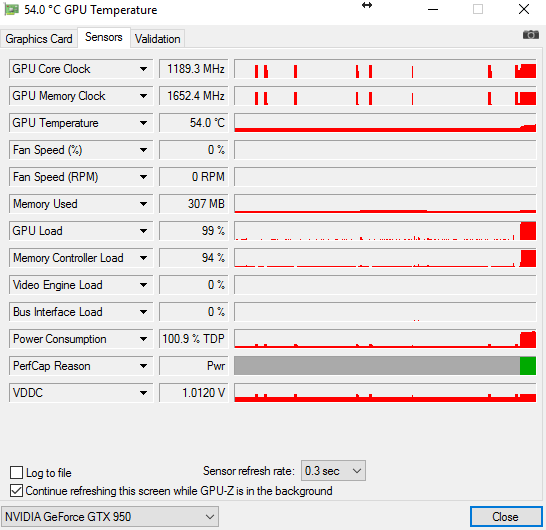
При необходимости характеристики видеокарты из вкладки «Sensors» можно сохранить в текстовый файл. Для этого нужно активировать функцию «Log to file».
Последнее обновление от 28.09.2012
Основные характеристики видеокарт
Современные графические процессоры содержат множество функциональных блоков, от количества и характеристик которых зависит и итоговая скорость рендеринга, влияющая на комфортность игры. По сравнительному количеству этих блоков в разных видеочипах можно примерно оценить, насколько быстр тот или иной GPU. Характеристик у видеочипов довольно много, в этом разделе мы рассмотрим лишь самые важные из них.
Тактовая частота видеочипа
Рабочая частота GPU обычно измеряется в мегагерцах, т. е. миллионах тактов в секунду. Эта характеристика прямо влияет на производительность видеочипа — чем она выше, тем больший объем работы GPU может выполнить в единицу времени, обработать большее количество вершин и пикселей. Пример из реальной жизни: частота видеочипа, установленного на плате Radeon HD 6670 равна 840 МГц, а точно такой же чип в модели Radeon HD 6570 работает на частоте в 650 МГц. Соответственно будут отличаться и все основные характеристики производительности. Но далеко не только рабочая частота чипа определяет производительность, на его скорость сильно влияет и сама графическая архитектура: устройство и количество исполнительных блоков, их характеристики и т. п.
В некоторых случаях тактовая частота отдельных блоков GPU отличается от частоты работы остального чипа. То есть, разные части GPU работают на разных частотах, и сделано это для увеличения эффективности, ведь некоторые блоки способны работать на повышенных частотах, а другие — нет. Такими GPU комплектуется большинство видеокарт GeForce от NVIDIA. Из свежих примеров приведём видеочип в модели GTX 580, большая часть которого работает на частоте 772 МГц, а универсальные вычислительные блоки чипа имеют повышенную вдвое частоту — 1544 МГц.
Скорость заполнения (филлрейт)
Скорость заполнения показывает, с какой скоростью видеочип способен отрисовывать пиксели. Различают два типа филлрейта: пиксельный (pixel fill rate) и текстурный (texel rate). Пиксельная скорость заполнения показывает скорость отрисовки пикселей на экране и зависит от рабочей частоты и количества блоков ROP (блоков операций растеризации и блендинга), а текстурная — это скорость выборки текстурных данных, которая зависит от частоты работы и количества текстурных блоков.
Например, пиковый пиксельный филлрейт у GeForce GTX 560 Ti равен 822 (частота чипа) × 32 (количество блоков ROP) = 26304 мегапикселей в секунду, а текстурный — 822 × 64 (кол-во блоков текстурирования) = 52608 мегатекселей/с. Упрощённо дело обстоит так — чем больше первое число — тем быстрее видеокарта может отрисовывать готовые пиксели, а чем больше второе — тем быстрее производится выборка текстурных данных.
Хотя важность "чистого" филлрейта в последнее время заметно снизилась, уступив скорости вычислений, эти параметры всё ещё остаются весьма важными, особенно для игр с несложной геометрией и сравнительно простыми пиксельными и вершинными вычислениями. Так что оба параметра остаются важными и для современных игр, но они должны быть сбалансированы. Поэтому количество блоков ROP в современных видеочипах обычно меньше количества текстурных блоков.
Количество вычислительных (шейдерных) блоков или процессоров
Пожалуй, сейчас эти блоки — главные части видеочипа. Они выполняют специальные программы, известные как шейдеры. Причём, если раньше пиксельные шейдеры выполняли блоки пиксельных шейдеров, а вершинные — вершинные блоки, то с некоторого времени графические архитектуры были унифицированы, и эти универсальные вычислительные блоки стали заниматься различными расчётами: вершинными, пиксельными, геометрическими и даже универсальными вычислениями.
Впервые унифицированная архитектура была применена в видеочипе игровой консоли Microsoft Xbox 360, этот графический процессор был разработан компанией ATI (впоследствии купленной AMD). А в видеочипах для персональных компьютеров унифицированные шейдерные блоки появились ещё в плате NVIDIA GeForce 8800. И с тех пор все новые видеочипы основаны на унифицированной архитектуре, которая имеет универсальный код для разных шейдерных программ (вершинных, пиксельных, геометрических и пр.), и соответствующие унифицированные процессоры могут выполнить любые программы.
По числу вычислительных блоков и их частоте можно сравнивать математическую производительность разных видеокарт. Большая часть игр сейчас ограничена производительностью исполнения пиксельных шейдеров, поэтому количество этих блоков весьма важно. К примеру, если одна модель видеокарты основана на GPU с 384 вычислительными процессорами в его составе, а другая из той же линейки имеет GPU с 192 вычислительными блоками, то при равной частоте вторая будет вдвое медленнее обрабатывать любой тип шейдеров, и в целом будет настолько же производительнее.
Хотя, исключительно на основании одного лишь количества вычислительных блоков делать однозначные выводы о производительности нельзя, обязательно нужно учесть и тактовую частоту и разную архитектуру блоков разных поколений и производителей чипов. Только по этим цифрам можно сравнивать чипы только в пределах одной линейки одного производителя: AMD или NVIDIA. В других же случаях нужно обращать внимание на тесты производительности в интересующих играх или приложениях.
Блоки текстурирования (TMU)
Эти блоки GPU работают совместно с вычислительными процессорами, ими осуществляется выборка и фильтрация текстурных и прочих данных, необходимых для построения сцены и универсальных вычислений. Число текстурных блоков в видеочипе определяет текстурную производительность — то есть скорость выборки текселей из текстур.
Хотя в последнее время больший упор делается на математические расчеты, а часть текстур заменяется процедурными, нагрузка на блоки TMU и сейчас довольно велика, так как кроме основных текстур, выборки необходимо делать и из карт нормалей и смещений, а также внеэкранных буферов рендеринга render target.
С учётом упора многих игр в том числе и в производительность блоков текстурирования, можно сказать, что количество блоков TMU и соответствующая высокая текстурная производительность также являются одними из важнейших параметров для видеочипов. Особенное влияние этот параметр оказывает на скорость рендеринга картинки при использовании анизотропной фильтрации, требующие дополнительных текстурных выборок, а также при сложных алгоритмах мягких теней и новомодных алгоритмах вроде Screen Space Ambient Occlusion.
Блоки операций растеризации (ROP)
Блоки растеризации осуществляют операции записи рассчитанных видеокартой пикселей в буферы и операции их смешивания (блендинга). Как мы уже отмечали выше, производительность блоков ROP влияет на филлрейт и это — одна из основных характеристик видеокарт всех времён. И хотя в последнее время её значение также несколько снизилось, всё ещё попадаются случаи, когда производительность приложений зависит от скорости и количества блоков ROP. Чаще всего это объясняется активным использованием фильтров постобработки и включенным антиалиасингом при высоких игровых настройках.
Ещё раз отметим, что современные видеочипы нельзя оценивать только числом разнообразных блоков и их частотой. Каждая серия GPU использует новую архитектуру, в которой исполнительные блоки сильно отличаются от старых, да и соотношение количества разных блоков может отличаться. Так, блоки ROP компании AMD в некоторых решениях могут выполнять за такт больше работы, чем блоки в решениях NVIDIA, и наоборот. То же самое касается и способностей текстурных блоков TMU — они разные в разных поколениях GPU разных производителей, и это нужно учитывать при сравнении.
Вплоть до последнего времени, количество блоков обработки геометрии было не особенно важным. Одного блока на GPU хватало для большинства задач, так как геометрия в играх была довольно простой и основным упором производительности были математические вычисления. Важность параллельной обработки геометрии и количества соответствующих блоков резко выросли при появлении в DirectX 11 поддержки тесселяции геометрии. Компания NVIDIA первой распараллелила обработку геометрических данных, когда в её чипах семейства GF1xx появилось по несколько соответстующих блоков. Затем, похожее решение выпустила и AMD (только в топовых решениях линейки Radeon HD 6700 на базе чипов Cayman).
В рамках этого материала мы не будем вдаваться в подробности, их можно прочитать в базовых материалах нашего сайта, посвященных DirectX 11-совместимым графическим процессорам. В данном случае для нас важно то, что количество блоков обработки геометрии очень сильно влияет на общую производительность в самых новых играх, использующих тесселяцию, вроде Metro 2033, HAWX 2 и Crysis 2 (с последними патчами). И при выборе современной игровой видеокарты очень важно обращать внимание и на геометрическую производительность.
Собственная память используется видеочипами для хранения необходимых данных: текстур, вершин, данных буферов и т. п. Казалось бы, что чем её больше — тем всегда лучше. Но не всё так просто, оценка мощности видеокарты по объему видеопамяти — это наиболее распространенная ошибка! Значение объёма видеопамяти неопытные пользователи переоценивают чаще всего, до сих пор используя именно его для сравнения разных моделей видеокарт. Оно и понятно — этот параметр указывается в списках характеристик готовых систем одним из первых, да и на коробках видеокарт его пишут крупным шрифтом. Поэтому неискушённому покупателю кажется, что раз памяти в два раза больше, то и скорость у такого решения должна быть в два раза выше. Реальность же от этого мифа отличается тем, что память бывает разных типов и характеристик, а рост производительности растёт лишь до определенного объёма, а после его достижения попросту останавливается.
Так, в каждой игре и при определённых настройках и игровых сценах есть некий объём видеопамяти, которого хватит для всех данных. И хоть ты 4 ГБ видеопамяти туда поставь — у неё не появится причин для ускорения рендеринга, скорость будут ограничивать исполнительные блоки, о которых речь шла выше, а памяти просто будет достаточно. Именно поэтому во многих случаях видеокарта с 1,5 ГБ видеопамяти работает с той же скоростью, что и карта с 3 ГБ (при прочих равных условиях).
Ситуации, когда больший объём памяти приводит к видимому увеличению производительности, существуют — это очень требовательные игры, особенно в сверхвысоких разрешениях и при максимальных настройках качества. Но такие случаи встречаются не всегда и объём памяти учитывать нужно, не забывая о том, что выше определённого объема производительность просто уже не вырастет. Есть у чипов памяти и более важные параметры, такие как ширина шины памяти и её рабочая частота. Эта тема настолько обширна, что подробнее о выборе объёма видеопамяти мы ещё остановимся в шестой части нашего материала.
Ширина шины памяти
Ширина шины памяти является важнейшей характеристикой, влияющей на пропускную способность памяти (ПСП). Большая ширина позволяет передавать большее количество информации из видеопамяти в GPU и обратно в единицу времени, что положительно влияет на производительность в большинстве случаев. Теоретически, по 256-битной шине можно передать в два раза больше данных за такт, чем по 128-битной. На практике разница в скорости рендеринга хоть и не достигает двух раз, но весьма близка к этому во многих случаях с упором в пропускную способность видеопамяти.
Современные игровые видеокарты используют разную ширину шины: от 64 до 384 бит (ранее были чипы и с 512-битной шиной), в зависимости от ценового диапазона и времени выпуска конкретной модели GPU. Для самых дешёвых видеокарт уровня low-end чаще всего используется 64 и реже 128 бит, для среднего уровня от 128 до 256 бит, ну а видеокарты из верхнего ценового диапазона используют шины от 256 до 384 бит шириной. Ширина шины уже не может расти чисто из-за физических ограничений — размер кристалла GPU недостаточен для разводки более чем 512-битной шины, и это обходится слишком дорого. Поэтому наращивание ПСП сейчас осуществляется при помощи использования новых типов памяти (см. далее).
Ещё одним параметром, влияющим на пропускную способность памяти, является её тактовая частота. А повышение ПСП часто напрямую влияет на производительность видеокарты в 3D-приложениях. Частота шины памяти на современных видеокартах бывает от 533(1066, с учётом удвоения) МГц до 1375(5500, с учётом учетверения) МГц, то есть, может отличаться более чем в пять раз! И так как ПСП зависит и от частоты памяти, и от ширины ее шины, то память с 256-битной шиной, работающая на частоте 800(3200) МГц, будет иметь бо́льшую пропускную способность по сравнению с памятью, работающей на 1000(4000) МГц со 128-битной шиной.
Особенное внимание на параметры ширины шины памяти, её типа и частоты работы следует уделять при покупке сравнительно недорогих видеокарт, на многие из которых ставят лишь 128-битные или даже 64-битные интерфейсы, что крайне негативно сказывается на их производительности. Вообще, покупка видеокарты с использованием 64-битной шины видеопамяти для игрового ПК нами не рекомендуется вовсе. Желательно отдать предпочтение хотя бы среднему уровню минимум со 128- или 192-битной шиной.
На современные видеокарты устанавливается сразу несколько различных типов памяти. Старую SDR-память с одинарной скоростью передачи уже нигде не встретишь, но и современные типы памяти DDR и GDDR имеют значительно отличающиеся характеристики. Различные типы DDR и GDDR позволяют передавать в два или четыре раза большее количество данных на той же тактовой частоте за единицу времени, и поэтому цифру рабочей частоты зачастую указывают удвоенной или учетверённой, умножая на 2 или 4. Так, если для DDR-памяти указана частота 1400 МГц, то эта память работает на физической частоте в 700 МГц, но указывают так называемую «эффективную» частоту, то есть ту, на которой должна работать SDR-память, чтобы обеспечить такую же пропускную способность. То же самое с GDDR5, но частоту тут даже учетверяют.
Основное преимущество новых типов памяти заключается в возможности работы на больших тактовых частотах, а соответственно — в увеличении пропускной способности по сравнению с предыдущими технологиями. Это достигается за счет увеличенных задержек, которые, впрочем, не так важны для видеокарт. Первой платой, использующей память DDR2, стала NVIDIA GeForce FX 5800 Ultra. С тех пор технологии графической памяти значительно продвинулись, был разработан стандарт GDDR3, который близок к спецификациям DDR2, с некоторыми изменениями специально для видеокарт.
GDDR3 — это специально предназначенная для видеокарт память, с теми же технологиями, что и DDR2, но с улучшенными характеристиками потребления и тепловыделения, что позволило создать микросхемы, работающие на более высоких тактовых частотах. Несмотря на то, что стандарт был разработан в компании ATI, первой видеокартой, её использующей, стала вторая модификация NVIDIA GeForce FX 5700 Ultra, а следующей стала GeForce 6800 Ultra.
GDDR4 — это дальнейшее развитие «графической» памяти, работающее почти в два раза быстрее, чем GDDR3. Основными отличиями GDDR4 от GDDR3, существенными для пользователей, являются в очередной раз повышенные рабочие частоты и сниженное энергопотребление. Технически, память GDDR4 не сильно отличается от GDDR3, это дальнейшее развитие тех же идей. Первыми видеокартами с чипами GDDR4 на борту стали ATI Radeon X1950 XTX, а у компании NVIDIA продукты на базе этого типа памяти не выходили вовсе. Преимущества новых микросхем памяти перед GDDR3 в том, что энергопотребление модулей может быть примерно на треть ниже. Это достигается за счет более низкого номинального напряжения для GDDR4.
Впрочем, GDDR4 не получила широкого распространения даже в решениях AMD. Начиная с GPU семейства RV7x0, контроллерами памяти видеокарт поддерживается новый тип памяти GDDR5, работающий на эффективной учетверённой частоте до 5,5 ГГц и выше (теоретически возможны частоты до 7 ГГц), что даёт пропускную способность до 176 ГБ/с с применением 256-битного интерфейса. Если для повышения ПСП у памяти GDDR3/GDDR4 приходилось использовать 512-битную шину, то переход на использование GDDR5 позволил увеличить производительность вдвое при меньших размерах кристаллов и меньшем потреблении энергии.
Видеопамять самых современных типов — это GDDR3 и GDDR5, она отличается от DDR некоторыми деталями и также работает с удвоенной/учетверённой передачей данных. В этих типах памяти применяются некоторые специальные технологии, позволяющие поднять частоту работы. Так, память GDDR2 обычно работает на более высоких частотах по сравнению с DDR, GDDR3 — на еще более высоких, а GDDR5 обеспечивает максимальную частоту и пропускную способность на данный момент. Но на недорогие модели до сих пор ставят «неграфическую» память DDR3 со значительно меньшей частотой, поэтому нужно выбирать видеокарту внимательнее.
Что нужно знать о видеокартах? Руководство THG для начинающих пользователей, часть II
Архитектура графического процессора: функции
Реализм 3D-графики очень сильно зависит от производительности видеокарты. Чем больше блоков пиксельных шейдеров содержит процессор и чем выше частота, тем больше эффектов можно наложить на 3D-сцену, чтобы улучшить её визуальное восприятие.
Графический процессор содержит много различных функциональных блоков. По количеству некоторых компонентов можно оценить, насколько графический процессор мощный. Перед тем, как двигаться дальше, позвольте рассмотреть самые важные функциональные блоки.
Вершинные процессоры (блоки вершинных шейдеров)
Как и блоки пиксельных шейдеров, вершинные процессоры выполняют код программ-шейдеров, которые касаются вершин. Поскольку больший бюджет вершин позволяет создавать более сложные 3D-объекты, производительность вершинных процессоров очень важна в 3D-сценах со сложными объектами или с большим их количеством. Впрочем, блоки вершинных шейдеров всё же не так очевидно влияют на производительность, как пиксельные процессоры.
Пиксельные процессоры (блоки пиксельных шейдеров)
Пиксельный процессор – это компонент графического чипа, выделенный на обработку пиксельных программ-шейдеров. Эти процессоры выполняют вычисления, касающиеся только пикселей. Поскольку пиксели содержат информацию о цвете, пиксельные шейдеры позволяют достичь впечатляющих графических эффектов. Например, большинство эффектов воды, которые вы видели в играх, создаётся с помощью пиксельных шейдеров. Обычно число пиксельных процессоров используется для сравнения пиксельной производительности видеокарт. Если одна карта оснащена восемью блоками пиксельных шейдеров, а другая – 16 блоками, то вполне логично предположить, что видеокарта с 16 блоками будет быстрее обрабатывать сложные пиксельные программы. Также следует учитывать и тактовую частоту, но сегодня удвоение числа пиксельных процессоров эффективнее по энергопотреблению, чем удвоение частоты графического чипа.
Унифицированные шейдеры
Унифицированные (единые) шейдеры ещё не пришли в мир ПК, но грядущий стандарт DirectX 10 как раз опирается на подобную архитектуру. То есть структура кода вершинных, геометрических и пиксельных программ будет единая, хотя шейдеры будут выполнять разную работу. Новую спецификацию можно посмотреть в Xbox 360, где графический процессор был специально разработан ATi для Microsoft. Будет весьма интересно увидеть, какой потенциал несёт новый DirectX 10.
Блоки наложения текстур (Texture Mapping Unit, TMU)
Текстуры следует выбрать и отфильтровать. Эта работа выполняется блоками наложения текстур, которые работают совместно с блоками пиксельных и вершинных шейдеров. Работа TMU заключается в применении текстурных операций над пикселями. Число текстурных блоков в графическом процессоре часто используется для сравнения текстурной производительности видеокарт. Вполне разумно предположить, что видеокарта с большим числом TMU даст более высокую текстурную производительность.
Блоки растровых операций (Raster Operator Unit, ROP)
Процессоры растровых операций отвечают за запись пиксельных данных в память. Скорость, с которой выполняется эта операция, является скоростью заполнения (fill rate). В ранние дни 3D-ускорителей число ROP и скорость заполнения являлись очень важными характеристиками видеокарт. Сегодня работа ROP по-прежнему важна, но производительность видеокарты уже не упирается в эти блоки, как было раньше. Поэтому производительность (и число) ROP уже редко используется для оценки скорости видеокарты.
Конвейеры
Конвейеры используются для описания архитектуры видеокарт и дают вполне наглядное представление о производительности графического процессора.
Конвейер нельзя считать строгим техническим термином. В графическом процессоре используются разные конвейеры, которые выполняют отличающиеся друг от друга функции. Исторически под конвейером понимали пиксельный процессор, который был подключён к своему блоку наложения текстур (TMU). Например, у видеокарты Radeon 9700 используется восемь пиксельных процессоров, каждый из которых подключён к своему TMU, поэтому считают, что у карты восемь конвейеров.
Но современные процессоры описать числом конвейеров весьма сложно. По сравнению с предыдущими дизайнами, новые процессоры используют модульную, фрагментированную структуру. Новатором в этой сфере можно считать ATi, которая с линейкой видеокарт X1000 перешла на модульную структуру, что позволило достичь прироста производительности через внутреннюю оптимизацию. Некоторые блоки процессора используются больше, чем другие, и для повышения производительности графического процессора ATi постаралась найти компромисс между числом нужных блоков и площадью кристалла (её нельзя очень сильно увеличивать). В данной архитектуре термин "пиксельный конвейер" уже потерял своё значение, поскольку пиксельные процессоры уже не подключены к собственным блокам TMU. Например, у графического процессора ATi Radeon X1600 есть 12 блоков пиксельных шейдеров и всего четыре блока наложения текстур TMU. Поэтому нельзя говорить, что в архитектуре этого процессора есть 12 пиксельных конвейеров, как и говорить, что их всего четыре. Впрочем, по традиции пиксельные конвейеры всё ещё упоминают.
Что важнее ROP,TMU или потоковые процессоры на видеокарте?А также еще есть унифицированные шейдерные блоки.
В нете ищу но и тут тоже собираю информациюю.
Пока узнал что филрейт (скорость заполнения пикселов) зависит от числа ROP помноженых на тактовую частотту GPU.
ROP отвечают за запись пикселей в память.
TMU отвечают за скорость наложения текстур.Понятно что ето важно и чем больше тем быстрее они наложатся.
Универсальные процессоры что то обьединяют (называется T&L).Как бе заполнения вершын и текстур?
Лично моя практика показывает что: 1 идут ROPs, 2 TMUs и 3 Шейдеры унифицированные (они кстати в основном важны в рендеринге видео), а ROP и TMU больше для игр важны и желательно что бы их было примерно одинаковое колличество, а не так как у меня 16 ROPs и 96 TMUs. В итоге моим TMU не на что накладывать текстуры 🙂
P.S. А вообще, я бы лучше не на ROPs и TMUs смотрел а на Pixel и Texture Fillrate. У меня PF 16, TF 96 и этого маловата, если TF еще нормально (желательно выше 100 сейчас, для 1920×1080 разрешения) то PF не менее 20 это точно.
ROPs and TMUs What is it?
im assuming You wanted more than just the full name , so
A texture mapping unit (TMU) is a component in modern graphics processing units (GPUs), historically it was a separate physical processor. A TMU is able to rotate, resize, and distort a bitmap image (performing texture sampling), to be placed onto an arbitrary plane of a given 3D model as a texture. This process is called texture mapping. In modern graphics cards it is implemented as a discrete stage in a graphics pipeline,[1] whereas when first introduced it was implemented as a separate processor, e.g. as seen on the Voodoo2 graphics card.
The render output unit, often abbreviated as "ROP", and sometimes called (perhaps more properly) raster operations pipeline, is a hardware component in modern graphics processing units (GPUs) and one of the final steps in the rendering process of modern 3D accelerator boards. The pixel pipelines take pixel and texel information and process it, via specific matrix and vector operations, into a final pixel or depth value. This process is called rasterization. The ROPs perform the transactions between the relevant buffers in the local memory – this includes writing or reading values, as well as blending them together. Dedicated antialiasing hardware used to perform hardware-based antialiasing methods like MSAA is contained in ROPs.
if you really only wanted to know what the acronym stood for , google would have been a Lot easier, it literally gives what i posted above as the 1st result. but ill give you the benefit of the doubt, and assume you wanted the full definition.
all the answers in the world are between these arrows. >>> HERE <<<
remember to fill out your spec’s when you get a minute, and welcome to TPU.
What are ROPs & TMUs?

The ROP is the unit that performs the final procedure in displaying your screen. When pixels are computed, for example, via shader, they must be blended according to their associated depth and associated blend functions. It’s the ROP’s job to perform this blending and then place the pixel value at its location «on the screen» (which is actually just a place in memory effectively).
TMUs I know about are Texture Mapping Units, and they’re fairly old technology. I can’t find anything on Texture Memory Units. I can tell you that nowadays textures are loaded into GPU memory instead of RAM. Otherwise, I’m not sure what you’re asking about.
But then, something that I don’t understand is what is the purpose of having more Pixel Shader Units that ROPs, as you won’t be able to write the results because the ROPs are going to be a bottleneck. For example if you have 24 pixel shaders (in a non unified architecture) and 8 ROPs, you can produce 24 pixels per clock, but only write 8, so the pixel shaders will need to wait for the ROPs to became available. What I am missing?
From Xenos GPU wikipedia page:
Maybe then TFs and TAs are just specialiced TMUs? Maybe TFs are the ones able to perform bilinear, trilinear and anisotropic reads, and TAs the ones that perform unfiltered reads (POINT,NEAREST).
Because the most complex operation ROPs can do is read ‘A’ from target output, read B» from shaders output, and compute (A * D + B * E) (where D & E may be any value, i.e. alpha blending), and the most simple operation they can do is not to do anything (pixel was discarded), second to that comes writing «B», that is just writing what the shader computed.
In other words, ROP’s operations aren’t complex. One or two additions, and two multiplications as maximum.
In the other hand, pixel shaders units can be VERY busy because there’s nearly no limit to what they can do (usually around 30-50 instructions, many texture lookups, and a couple of special instructions like log pow or sqrt).
Suppose the following example:
* 16 Shader units (let’s call it SU) & 8 ROPs
* ROPs are idle. SU are computing lots of square roots, additions, multiplications.
* The 16 SUs finished their job. Go to next 16 pixels. ROPs start their job
* 16 SUs are working on pixels 16. 31, ROPs are working on pixels 0. 7
* 16 SUs are working on pixels 16. 31, ROPs are working on pixels 8. 15
* ROPs are idle again, 16 SUs still busy
* The 16 SUs finished their job. Go to next 16 pixels. ROPs start their job again.
See? You have 16 SUs, 8 ROPs and yet the bottleneck is in the SUs.
Ideally, the shader operations are balanced enough so that as soon as the SUs are done, the ROPs just finished with the last group of pixels; so that all components are never idle.
The reverse situation would happen when your Pixel shader is completely trivial, something like returning a constant colour, doing a texture lookup without applying lighting.