ФП vs ООП
Не так давно на хабре появилось несколько постов противопоставляющих функциональный и объектный подход, породивших в комментариях бурное обсуждение того, что вообще это такое — объектно ориентированное программирование и чем оно отличается от функционального. Я, пусть и с некоторым опозданием, хочу поделиться с окружающими тем, что думает по этому поводу Роберт Мартин, также известный, как Дядюшка Боб.
За последние несколько лет мне неоднократно доводилось программировать в паре с людьми, изучающими Функциональное Программирование, которые были предвзято настроены по отношению к ООП. Обычно это выражалось в формe утверждений типа: “Ну это слишком похоже на что-то объектное.”
Я думаю это происходит из убеждения, что ФП и ООП взаимно исключают друг друга. Многие похоже думают, что если программа функциональная, то она не объектно ориентированная. Полагаю, формирование такого мнения — логичное следствие изучения чего-то нового.
Когда мы берёмся за новую технику, мы часто начинаем избегать старых техник, которые использовали раньше. Это естественно, потому что мы верим, что новая техника “лучше” и следовательно старая техника наверное “хуже”.
В этом посте я обосную мнение, что хотя ООП и ФП ортогональны, это не взаимно исключающие понятия. Что хорошая функциональная программа может (и должна) быть объектно ориентированной. И что хорошая объектно ориентированная программа может (и должна) быть функциональной. Но для того, чтобы это сделать, нам придётся определиться с терминами.
Что такое ООП?
Я подойду к вопросу с редукционистских позиций. Есть много правильных определений ООП которые покрывают множество концепций, принципов, техник, паттернов и философий. Я намерен проигнорировать их и сосредоточиться на самой соли. Редукционизм тут нужен из-за того, что всё это богатство возможностей, окружающее ООП на самом деле не является чем-то специфичным для ООП; это просто часть богатства возможностей встречающихся в разработке программного обеспечения в целом. Тут я сосредоточусь на части ООП, которая является определяющей и неустранимой.
Посмотрите на два выражения:
Никакой семантической разницы явно нет. Вся разница целиком и полностью в синтаксисе. Но одно выглядит процедурным, а другое объектно ориентированным. Это потому что мы привыкли к тому, что для выражения 2. неявно подразумевается особая семантика поведения, которой нет у выражения 1. Эта особая семантика поведения — полиморфизм.
Когда мы видим выражение 1. мы видим функцию f, которая вызывается в которую передаётся объект o. При этом подразумевается, что есть только одна функция с именем f, и не факт, что она является членом стандартной когорты функций, окружающих o.
С другой стороны, когда мы видим выражение 2. мы видим объект с именем o которому посылают сообщение с именем f. Мы ожидаем, что могут быть другие виды объектов, котоые принимают сообщение f и поэтому мы не знаем, какого конкретно поведения ожидать от f после вызова. Поведение зависит от типа o. то есть f — полиморфен.
Вот этот факт, что мы ожидаем от методов полиморфного поведения — суть объектно ориентированного программирования. Это редукционистское определение и это свойство неустранимо из ООП. ООП без полиморфизма это не ООП. Все другие свойства ООП, такие как инкапсуляция данных и методы привязанные к этим данным и даже наследование имеют больше отношения к выражению 1. чем к выражению 2.
Программисты, использующие Си и Паскаль (и до некоторой степени даже Фортран и Кобол) всегда создавали системы инкапсулированных функций и структур. Чтобы создать такие структуры даже не нужен объектно ориентированный язык программирования. Инкапсуляция и даже простое наследование в таких языках очевидны и естественны. (В Си и Паскале более естественно, чем в других)
Поэтому то, что действительно отличает ООП программы от не ООП программ это полиморфизм.
Возможно вы захотите возразить, что полифорфизм можно сделать просто используя внутри f switch или длинные цепочки if/else. Это правда, поэтому мне нужно задать для ООП ещё одно ограничение.
Использование полиморфизма не должно создавать зависимости вызывающего от вызываемого.
Чтобы это объяснить, давайте ещё раз посмотрим на выражения. Выражение 1: f(o), похоже зависит от функции f на уровне исходного кода. Мы делаем такой вывод потому что мы также предполагаем, что f только одна и что поэтому вызывающий должен знать о вызываемом.
Однако, когда мы смотрим на Выражение 2. o.f() мы предполагаем что-то другое. Мы знаем, что может быть много реализаций f и мы не знаем какая из этих функций f будет вызвана на самом деле. Следовательно исходный код, содержащий выражение 2 не зависит от вызываемой функции на уровне исходного кода.
Если конкретнее, то это означает, что модули (файлы с исходным кодом), которые содержат полиморфные вызовы функций не должны ссылаться на модули (файлы с исходным кодом), которые содержат реализацию этих функций. Не может быть никаких include или use или require или каких-то других ключевых слов, которые создают зависимость одних файлов с исходным кодом от других.
Итак, наше редукционистское определение ООП это:
Что такое ФП?
И опять я буду использовать редукционистский подход. У ФП есть богатые традиции и история, корни которых глубже, чем само программирование. Существуют принципы, техники, теоремы, философии и концепции, которыми пронизана эта парадигма. Я всё это проигнорирую и перейду сразу к самой сути, к неотъемлемому свойству которое отделяет ФП от других стилей. Вот оно:
f(a) == f(b) если a == b.
В функциональной программе вызов функции с тем же аргументом даёт тот же результат независимо от того, как долго работала программа. Это иногда называют референциальной прозрачностью.
Из сказанного выше вытекает следствие, что f не должна менять части глобального состояния, которые влияют на поведение f. Более того, если мы скажем, что f представляет все функции в системе — то есть все функции в системе должны быть референциально прозрачными — тогда ни одна функция в системе не может изменить глобальное состояние. Ни одна функция не может сделать ничего, что может привести к тому, что другая функция из системы вернёт другое значение при тех же аргументах.
У этого есть и более глубокое следствие — ни одно именованное значение нельзя менять. То есть оператора присваивания нет.
Если тщательно обдумать это утверждение, то можно прийти к заключению, что программа, состоящая только из референциально прозрачных функций ничего не может сделать — так как любое полезное поведение системы меняет состояние чего-нибудь; даже если это просто состояние принтера или дисплея. Однако, если из требований к референциальной прозрачности исключить железо и все элементы окружающего мира оказывается, что мы можем создавать очень полезные системы.
Фокус, конечно, в рекурсии. Рассмотрим функцию которая принимает структуру с состоянием в качестве аргумента. Этот аргумент состоит из всей информации о состоянии, которая нужна функции для работы. Когда работа окончена, функция создаёт новую структуру с состоянием, содержимое которой отличается от предыдущей. И последним действием функция вызывает саму себя с новой структурой в качестве аргумента.
Это только один из простых трюков, которые фукциональная программа может использовать чтобы хранить изменения состояния без необходимости изменять состояние [1].
Итак, редукционистское определение функционального программирования:
ФП против ООП
К этому моменту и сторонники ООП и сторонники ФП уже смотрят на меня через оптические прицелы. Редукционизм не лучший способ завести друзей. Но иногда он полезен. В данном случае, я думаю что полезно пролить свет на никак не утихающий холивар ФП против ООП.
Ясно, что два редукционистских определения, которые я выбрал, совершенно ортогональны. Полиморфизм и Референциальная Прозрачность не имеют никакого отношения друг к другу. Они никак не пересекаются.
Но ортогональность не подразумевает взаимного исключения (спросите Джеймса Клерка Максвелла). Вполне можно создать систему, которая использует и динамический полиморфизм и референциальную прозрачность. Это не только возможно, это правильно и хорошо!
Почему эта комбинация хороша? По точно тем же причинам, что оба её компонента! Системы построенные на динамическом полиморфизме хороши, потому что они обладают низкой связностью. Зависимости можно инвертировать и расположить по разные стороны архитектурных границ. Эти системы можно тестировать используя Моки и Фейки и другие виды Тестовых Дублей. Модули можно модифицировать не внося изменения в другие модули. Поэтому такие системы проще изменять и улучшать.
Системы, построенные на референциальной прозрачности тоже хороши, потому что они предсказуемы. Неизменяемость состояния делает такие системы проще для понимания, изменения и улучшения. Это значительно уменьшает вероятность возникновения гонок и других проблем, связанных с многопоточностью.
Главная мысль тут такая:
ФП и ООП хорошо работают вместе. И то и другое хорошо и правильно использовать в современных системах. Система, которая построена на комбинации принципов ООП и ФП максимизирует гибкость, поддерживаемость, тестируемость, простоту и прочность. Если убрать одно ради добавления другого это только ухудшит структуру системы.
[1] Так как мы используем машины с архитектурой Фон Неймана мы предполагаем, что в них есть ячейки памяти, состояние которых на самом деле изменяется. В механизме рекурсии, который я описал, оптимизация хвостовой рекурсии не даст создавать новые стекфреймы и будет использоваться первоначальный стекфрейм. Но это нарушение референциальной прозрачности (обычно) скрыто от программиста и ни на что не влияет.
⚒️ Зачем использовать функциональное программирование, если есть ООП?

Функциональное программирование — достаточно актуальная тема. В опросе разработчиков 2021 года, проведенном Stack Overflow, функциональные языки были признаны одними из самых востребованных. Популярные библиотеки JavaScript, такие как React и Angular, позволяют использовать функциональные концепции в ваших компонентах, классические объектно-ориентированные языки добавили поддержку функционального программирования. но все же возникла некоторая путаница в отношении того, что на самом деле означает функциональное программирование.
Обычно люди считаются, что это концепция, которую нужно изучить при переходе на более продвинутый уровень разработки, но это не обязательно так!
Если вы к этому готовы, давайте углубимся в то, что такое функциональное программирование, чем оно отличается от других парадигм, зачем его использовать и с чего начать!
Что такое функциональное программирование?
Есть три «типа» программирования, которые вы можете знать или не знать: процедурное программирование, объектно-ориентированное программирование и функциональное программирование. Я сосредоточусь на последних двух.
В объектно-ориентированном программировании (ООП) вы создаете «объекты» (отсюда и название), которые представляют собой структуры, содержащие данные и методы. В функциональном программировании все является функцией. Функциональное программирование пытается разделить данные и поведение, а ООП объединяет эти концепции.
Каковы правила функционального программирования?
Есть два основных положения, которые вам нужно знать, чтобы понять концепцию:
- Данные неизменны: если вы хотите изменить данные, например, массив, вы возвращаете новый массив с изменениями, а не исходный.
- Функции не сохраняют текущее состояния: функции всегда действуют так, как будто в первый раз! Другими словами, функция всегда возвращает одно и то же значение для одних и тех же аргументов.
Есть три рекомендации, которым вы обычно должны следовать:
- Ваши функции должны принимать по крайней мере один аргумент.
- Ваши функции должны возвращать данные или другую функцию.
- Не используйте циклы!
Некоторые из этих вещей могут происходить и в объектно-ориентированном программировании. Некоторые языки также позволяют вам смешивать концепции, например, JavaScript.
Пример для демонстрации разницы между ООП и функциональным программированием
Допустим, у вас есть школа и у нас есть записи каждого из учеников в какой-то базе данных. Допустим, у них у всех есть имя и средний балл (GPA). В объектно-ориентированном программировании вы могли бы написать что-то вроде этого:
Если вы хотите инициализировать ученика, вы можете сделать что-то вроде этого:
Теперь предположим, что вы хотите изменить средний балл группы студентов. С ООП у вас может быть массив учеников:
Для изменения среднего балла каждого студента, вы можете написать цикл и повысить оценки:
… или что-то ещё. Затем вы можете снова выполнить цикл, чтобы вывести результаты на экран, или просто поработать с объектами по своему усмотрению.
Теперь если бы вы хотели решить задачу того же типа с помощью функционального программирования, вы бы сделали это немного по-другому. Вот как вы можете проинициализировать студентов:
Студенты хранятся в виде простых массивов, а не объектов. Функциональное программирование предпочитает простые структуры данных, такие как массивы, списки и хэши (и т. д.), чтобы не «усложнять» данные и поведение. Итак, вместо того, чтобы писать только одну функцию changeGPA() , которую вы зацикливаете, у вас будет функции changeGPAs() и changeGPA() .
Функция changeGPAs() будет принимать на вход массив студентов. Затем она вызовет changeGPA() для каждого значения в массиве студентов и вернет результат в виде нового массива. Задача changeGPA() состоит в том, чтобы вернуть копию переданного учащегося с обновленным средним баллом.
Дело в том, что функциональное программирование предпочитает крошечные модульные функции, которые выполняют одну часть более крупной задачи! Работа changeGPAs() заключается в обработке массива студентов, а работа changeGPA() — в обработке каждого отдельного студента. Также обратите внимание, что исходный массив не изменяется, потому что мы рассматриваем данные как неизменяемые в функциональном программировании. Мы создаем новые наборы данных вместо изменения существующих.
Зачем мне использовать функциональное программирование?
Как выглядит хорошо структурированное программное обеспечение? Его легко написать, легко отлаживать и можно использовать повторно? Это функциональное программирование в двух словах! Конечно, кто-то может возразить, что это не так просто написать, но давайте коснемся двух других моментов, пока вы размышляете о функциональной парадигме.
Отладка
Отладка функционального программирования, возможно, значительно проще, чем другие парадигмы программирования, из-за его модульности и отсутствия побочных эффектов.
Если что-то пойдет не так в вашем программном обеспечении, использующем ООП, вам придется подумать о том, что другие части вашей программы могли сделать ранее, что могло повлиять на состояние вашей программы. С помощью функционального программирования вы можете указать точную функцию, в которой что-то пошло не так, потому что определенные вещи могут произойти только в одном месте.
Например, предположим, что у нас есть счетчик, который пропускает число 5.
В этой программе, если вы захотите протестировать ее, вам придется отслеживать глобальное состояние счетчика и запускать функцию increment() 5 раз, чтобы убедиться, что она работает, каждый раз. increment() возвращает что-то новое при каждом вызове, поэтому вам нужно использовать отладчик для выполнения программы.
Между тем, если вы написали эту функцию функциональным стилем:
Нам не нужно запускать pureIncrement() несколько раз для проверки. Вы можете легко выполнить модульное тестирование функции, потому что она всегда будет возвращать одно и то же с одними и теми же входными данными, и никакая переменная не будет изменена (помните, неизменность)!
Это не означает, что вы никогда не будете использовать отладчик (я не буду вдаваться в подробности в этой статье), но, если все будет записано в более мелкие фрагменты и не будет иметь побочных эффектов, вы намного быстрее исправите и точнее определите ошибки, а также не будете зависеть от среды, в которой они возникают.
Возможность повторного использования
Как вы уже видели в примере со студентом, мы разбили функции на более мелкие. В каждой функциональной программе, которую вы пишете, вы разбиваете функции на настолько маленькие, насколько это возможно. Это похоже на разбиение сложной математической задачи на скобки.
Допустим, вы хотите решить математическую задачу, например:
Если бы вы делали это вручную, вы могли бы решить задачу, добавив/умножив все числа, объединив то, что в скобках, а затем разделив результаты.
На функциональном языке, например, Лисп, это было бы похоже на:
Вот почему функциональное программирование часто называют «чистым программированием»! Функции выполняются так, как если бы они вычисляли математические функции, без непреднамеренных побочных эффектов.
 «Purity » от xkcd распространяется под лицензией CC BY-NC 2.5.
Когда у вас есть такие маленькие, «чистые» функции, то использовать их повторно намного проще, чем вашу традиционную объектно-ориентированную программу. Это спорный подход (если вы посмотрите «повторное использование в функциональном программировании», вы найдете много дискуссий и подкастов на эту тему), так что, я думаю, вы согласитесь со мной в том, что когда вы хотите повторно использовать класс в ООП и добавить функцию, вы добавляете условия и параметры, и ваши функции становятся больше. Ваши абстрактные классы и интерфейсы становятся довольно надежными. Вы должны уделять пристальное внимание более крупной архитектуре приложения из-за побочных эффектов и других факторов, которые повлияют на вашу программу (как мы говорили ранее).
В функциональном программировании все наоборот: ваши функции становятся меньше и гораздо более подходят для того, что вы хотите получить. Каждая функция делает что-то одно, и всякий раз, когда вы захотите сделать что-то одно, вы будете использовать конкретную функцию.
Конечно, в каждой системе есть исключения, но обычно это то, что вы видите в различных базах исходного кода во всем мире!
Ладно, ладно, я заинтригован. Как начать?
Если вы уже хорошо разбираетесь в JavaScript или Python, вы можете сразу приступить к изучению концепций функционального программирования, о которых мы говорили здесь. Если вы хотите больше узнать о «чистых» языках, предназначенных для функционального программирования, вы можете попробовать семейство Lisp (включая Common Lisp, Scheme и Clojure), семейство ML (включая OCaml и F#), Erlang, Elixir, Elm или Haskell.
Функциональное программирование может немного сбивать с толку, пока вы не привыкнете к нему. Но если вы дадите ему шанс и попробуете, ваше программное обеспечение будет надежным, его будет легче отлаживать, и вы будете наслаждаться гарантиями, которые дает прочная основа функционального программирования!
Функциональное и Объектно-Ориентированное Программирование

Достоинства функционального программирования (ФП) и объектно-ориентированного программирования (ООП) — предмет нескончаемых дебатов на любом техническом онлайн форуме. Хоть и трудно однозначно сказать, какое программирование лучше, их всегда можно сравнить и понять, который из двух больше подходит для разработки ваших приложений.
Объектно-ориентированное программирование и функциональное программирование преследуют одну и ту же цель — разработка программ, которые просты для понимания и не содержат ошибок. Однако в их основе лежит разный подход.
Объектно-ориентированное программирование
ООП — это парадигма, в основе которой лежит идея “объектов”. Объекты содержат данные в виде полей и код. Поля также известны под названием «атрибуты», а код в форме процедур, часто называют «методами». Объединяя данные и связанное с ними поведение в один «объект», объектно-ориентированное программирование облегчает понимание того, как работает программа.
Объектно-ориентированное программирование основывается на четырех ключевых принципах:
- абстракция — когда основное внимание сосредотачивается на наиболее значимых характеристиках предмета и скрываются ненужные детали;
- наследование — определение нового класса в терминах уже существующего;
- полиморфизм — объединение элементов для создания новой сущности;
- инкапсуляция — позволяет скрывать несвязанные пользовательские данные и предотвращает несанкционированный к ним доступ.
Объектно-ориентированное программирование — эффективная методология программирования, если у вас есть фиксированный набор операций над объектами, и по мере добавления новых объектов ваш код развивается. Однако вы не сможете легко определить, есть ли у объекта вызванная для него функция, если не отследили этот момент с самого начала.
Функциональное программирование
ФП — это процесс создания программного обеспечения путем использования чистых функций. Все объекты в ФП неизменяемы. Это означает, что как только что-то создано, оно не может быть изменено. В функциональном программировании данные и поведение — это разные сущности. Следовательно, они должны храниться отдельно друг от друга для ясности кода.
ФП основывается на шести концепциях:
- функции высшего порядка (HOF);
- чистая функция;
- рекурсия;
- ссылочная прозрачность.
- строгая и ленивая оценка;
- системы типов.
Плюсы и минусы объектно-ориентированного программирования
Плюсы
Программисты часто выбирают ООП подход. Все потому что он помогает обезопасить программы от несанкционированного доступа. Он скрывает переменные внутри класса и, таким образом, предотвращает доступ извне. Кроме того, в ООП есть возможность использовать модульность (возможность разделения функциональности программы на независимые модули) и управлять общими состояниями кода.
Объекты можно легко повторно задействовать в других приложениях. Создание новых объектов для того же класса не вызывает трудностей, а сам код легко изменять и поддерживать в актуальном состоянии.
Используя ОПП, программисты могут управлять оперативной памятью компьютера при разработке программ. Такая возможность дает большое преимущество при разработке больших программ, т.к. программисты могут разделять крупные части на более мелкие компоненты. Так, становится намного понятнее, что это за компоненты и в каком порядке они должны быть выполнены.
Минусы
ООП нельзя использовать повторно. Поскольку некоторые функции зависят от класса, который их использует и их нельзя применять в другом классе. Кроме того, ООП менее эффективен и с ним сложнее справляться. Многие объектно-ориентированные программы созданы для моделирования массивных архитектур и могут быть сложными.
Плюсы и минусы функционального программирования
Плюсы
У ФП есть такие преимущества, как ленивые вычисления, код без ошибок, вложенные функции, параллельное программирование. В нем используется более декларативный подход. Он фокусируется на том, что нужно сделать, и меньше на том, как это сделать. Акцент в ФП смещается на эффективность и оптимизацию.
В функциональном программировании гораздо проще узнать, какие изменения были внесены в код. Ввиду того, что сам объект теперь является новым объектом с другим именем. ФП эффективен, если у вас есть фиксированный набор операций, и, по мере развития вашего кода, вы добавляете новые операции к уже существующим элементам.
Такой подход хорошо работает, когда границы либо не требуются, либо уже предопределены. Помимо этого, в ФП все переменные финальны и их можно записать только один раз. Программистам не нужно сохранять состояние программы для того, чтобы позже изменить его.
В функциональном программировании легче моделировать реальные процессы, чем объекты. Так как ФП уходит своими корнями в математику, он наиболее подходит для случаев, требующих вычислений, или всего, что включает преобразование методов в математические функции и обработку потоков данных в высоконагруженных системах. ООП в таких случаях будет неэффективным.
Минусы
ФП тесно связан с манипулированием данными, а для написания кода требуется другой подход. При преобразовании реального сценария в код, намного проще мыслить ОО категориями. В ФП, такие преобразования потребуют больше умственных усилий.
Поскольку ФП сложнее в освоении, чем ООП, не каждый программист выберет этот подход. Следовательно, в интернете меньше информации по теме.

Функциональное Программирование или ООП: Что лучше?
Очевидно, что для ООП программистов ООП — это лучший подход к разработке программного обеспечения. Между тем ФП приверженцы отстаивают право ФП в программировании.
В то же время объектно-ориентированное программирование и функциональное программирование являются важными парадигмами, которые преследуют одинаковую цель — разработка понятных программ без ошибок.
ООП объединяет данные и связанное с ними поведение в объект. Это помогает программистам легче понять, как работает программа, хотя код намного длиннее, чем в ФП.
ФП четко различает данные и поведение, не смешивая их в коде. В результате, в ФП коде можно легко и просто находить ошибки, но его труднее прочесть.
Разработчики программного обеспечения любят сравнивать эти две концепции. Например, на Stack Overflow Норман Рэмси, профессор Тафтса и исследователь языков программирования, определил проблему выбора одной концепции в пользу другой следующим образом:
- ООП отлично работает, когда поведение программы четко определено, но типы данных меняются;
- ФП лучше подходит, когда все объекты понятны, но поведение может измениться.
Хотя ООП и ФП — это две совершенно разные концепции, это не означает, что они взаимоисключают друг друга. Эти два метода могут быть эффективно использованы в одном исходном коде разрабатываемого приложения.
Когда разработчики программного обеспечения объединяют ООП и ФП в своих процессах разработки, они могут создавать гибкие, высокопроизводительные, простые в обслуживании и тестировании решения.
Заключение
Как ООП, так и ФП — эффективные парадигмы программирования, но в определенной ситуации. Поэтому разработчики всегда должны выбирать парадигму программирования, которая делает процесс разработки продуктивным и легким.
Если у вас есть какие-либо вопросы относительно любой из двух парадигм программирования, обращайтесь к нам за советом.
Функциональное программирование или ООП?
Часто встречаю статьи и доклады от функциональщиков, что функциональное программирование рулит, а объекты это треш. Не будем здесь говорить о процедурщиках, которые думают, что они функциональщики. Не будем их разочаровывать, что ни к кому из вышеперечисленных они порой не относятся (и по этой причине иногда идут лесом). Разберёмся, чем функциональное программирование отличается от других парадигм и для чего это всё вообще нужно.
Парадигмы придумывают людьми для каких-то специфических целей и для упрощения работы. Да-да, как я и сказал когда-то на форуме:
Архитектуру придумали для упрощения сложного кода, а не для усложнения лёгкого.
Какие же парадигмы придумали? На ассемблере мы пишем нечасто, поэтому в самый низ опускаться не будем. Лапшекод и последующий процедурный подход тоже, так как с ними всё понятно. Остановимся на высокоуровневых парадигмах, призванных структурировать этот лапшекод.
Объектно-ориентированный подход
Когда кода становится много, его нужно как-то разбить по процедурам. Когда процедур становится много, то их нужно как-то сгруппировать по обязанностям и разнести по модулям. Если несколько процедур и функций как-то связаны работой с одними и теми же данными, то их удобнее вместе с этими данными сгруппировать в объект.
Но если просто возьмёте груду кода и просто перенесёте процедуры в классы, как я говорил на итенсиве, то не станете сразу объектно-ориентированным программистом. Это другой подход к компоновке кода. Целый отдельный образ жизни и мыслей.
Настоящее ООП нацелено на разделение обязанностей и сокрытие информации.
Это парадигма, придуманная для моделирования объектов реального мира. Как она это делает? Удобно показывать на метафорах и аналогиях, поэтому рассмотрим ситуацию с тостером или микроволновкой:
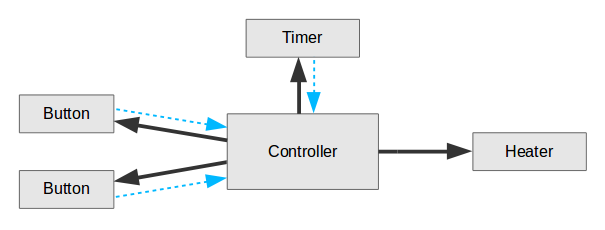
Есть контроллер, управляющий всеми запчастями чёрными стрелками и подписанный на состояние кнопок по голубым проводам. Как этот агрегат работает?
Кнопка включения передаёт сообщение Меня нажали . Контроллер передаёт сообщение Включись нагревателю и Запустись на 10 секунд таймеру, подписываясь при этом на его сигналы. Через указанное время таймер уведомляет Я истёк и контроллер передаёт Выключись печке. А по сигналу с кнопки выключения контроллер передаёт сигналы Выключись нагревателю и Стоп таймеру.
Если вдруг надо будет перепрограммировать логику, то всего лишь доработаем «прошивку» главного контроллера.
А если нужно добавить термометр, дисплей и GSM-модуль для отправки SMS-уведомлений? Запросто подключаем их к контроллеру своими «родными» разъёмами и в обработчике события истечения от таймера мы после остановки печки отправляем SMS о готовности. Или автоматически фотографируем обед и постим в Instagram. Но суть здесь одна:
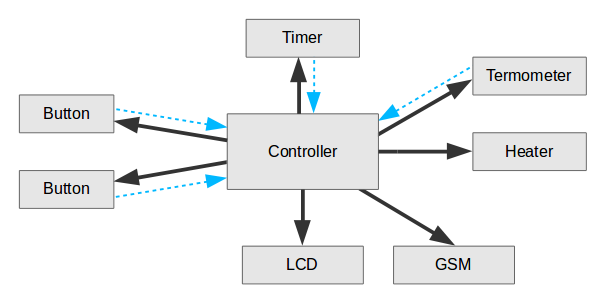
Контроллер при нажатии кнопки включает дисплей и подписывает его на события таймера через себя. Может и напрямую, но тогда дисплей и таймер должны быть совместимы. Что это напоминает?
Это классический подход Model-View-Controller (MVC), часто используемый в оконных приложениях, где есть много кнопок, дисплеев и прочих элементов.
В данном случае все связи идут не хаотически, а от контроллера. Нагреватель, таймер, дисплей и кнопки не знают друг о друге. Кнопки умеют только нажиматься, таймер только считать. Каждый делает только свою работу. Каждую специализированную запчасть легко проверить и поменять.
В такой системе можно вместо нагревателя даже поставить холодильник или шлагбаум. И у контроллера может быть возможность подключить что угодно:
лишь бы это «что угодно» поддерживало указанный интерфейс:
Тогда просто создаём все устройства и закидываем их в контроллер:
И такой контроллер будет всех их включать и отключать по таймеру.
В хозяйстве это вещь весьма полезная. Даже продвинутые варианты таких контроллеров уже есть:
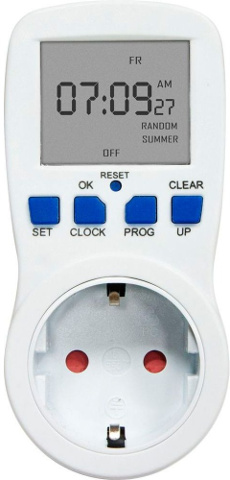
В такой можно включить даже электропилу, реализующую интерфейс ЕвроВилкаInterface .
А что если у нас в хозяйстве появилась бензопила? Она заводится особым образом и имеет свои методы:
Если у бензопилы нет кнопок вкл и выкл как у электропилы, то просто напишем адаптер:
Он снаружи будет выглядеть так, как нужно нашему контроллеру, а внутри себя будет скрывать весь этот сложный процесс. Так можно и для ядерного реактора адаптер написать, если вдруг это понадобится.
В реальности нам пригодился бы скромный набор деталей:
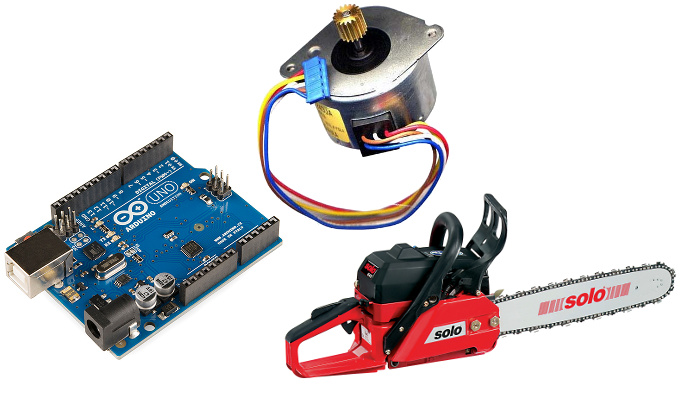
И теперь одним махом включаем бензопилу в разъём контроллера:
Бензопила с Arduino-адаптером теперь ничем не отличается от нагревателя. Мощь полиморфизма 🙂
Всё как в жизни. Абстрагируясь от реализации всего этого, для нас каждый модуль это всего лишь ящик с парой проводов. Груда проводов и транзисторов в виде элементов открытого ассоциативного массива причинит много проблем, так как нечаянно можно замкнуть не тот провод. А закрытый толстым кожухом объект с парой видимых кнопок или разъёмов с этим справится идеально.
Приятно и удобно программировать специализированными ящиками, обменивающимися сообщениями.
Умело разделяя систему на объекты и продумывая сообщения между ними можно достичь нирваны в ООП. А влезая в это кривыми руками можно забыть о структуре и сделать месиво:
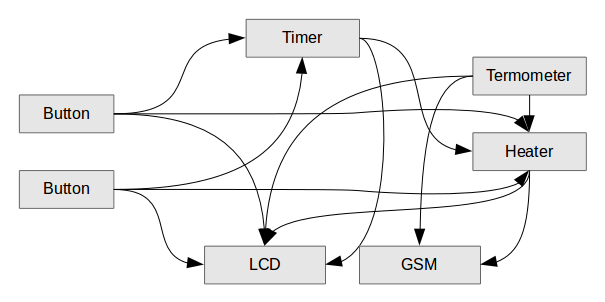
Здесь компоненты соединены кучами проводов и нужно всюду впаивать логику, чтобы термометр умел работать с дисплеем и включать печку. Бензопилу сюда уже так просто не включишь. Мы уже упоминали эту проблему при организации независимых модулей сайта с интересными картинками.
Функциональный подход
Если просто программируете процедурно и ещё не успели изучить хотя бы тот же ООП, то вы не обязательно получите функциональное программирование. ФП тоже о разделении обязанностей и тоже призвано структурировать лапшекод, но немного по-другому. Это так:
Пример: если Вы есть в соцсетях, то вас постоянно парсят маркетологи:
И получим результат:
Можно добавить город вначале:
и фильтры с группировками менять местами. Объекты с методами здесь никуда не впишешь.
Здесь вместо объектов, объединяющих данные с поведением, всё разнесено раздельно на сами данные и на их обработчики. Каждый обработчик представляет из себя функцию, принимающую исходные данные и возвращающую результат.
Здесь идеально подходят ассоциативные массивы и другие примитивные структуры. Они не нагружают оперативку и процессор созданием тысяч и миллионов объектов для каждого элемента. Но что если фильтраций будет много? Дабы не копировать миллионные массивы снова и снова, удобнее передавать все значения по ссылке. Или сделать структуры в виде классов с полями, чтобы все значения хранились в памяти в одном экземпляре и передавались по указателю.
Чем это отличается от обычного процедурного подхода?
Разбиение императивного кода на процедуры и функции в процедурной парадигме служит как инструмент абстракции в руках умелых или только для избавления от копипасты в руках обычных. Функции рассчитывают результат, а процедуры что-то куда-то записывают. Ведь нет смысла вызывать процедуру, которая ничего не возвращает и ничего при этом не делает.
В нашем парсере ничего записывать не надо и императивная пошаговость не нужна. Мы просто в потоке преобразуем одни данные в другие, не перезаписывая старые значения. Поэтому в функциональной парадигме можно выкинуть процедуры и переменные за ненадобностью и оставить лишь константы и функции.
Приятно и удобно работать с данными, прогоняя их через специализированные конвертеры.
Умело разделяя расчёты на данные и функции можно достичь нирваны в ФП. А влезая в это кривыми руками можно забыть о структуре и сделать месиво.
Но как на ФП пишут сайты?
Поток вычислений
Во-первых, не обязательно делать весь сайт на ФП. На сайте с логикой могут быть некие комбинированные расчёты, где ООП неудобен. Именно эти фрагменты можно реализовать функционально.
Например, нам нужно к товарам в корзине начислить скидку на один экземпляр каждого, которого заказали больше трёх. Вместо возни с циклами, методами и прочим низкоуровневым мусором мы просто определяем, какие фильтры и преобразователи нам нужны:
и теперь просто прогоняем массив наших товаров $items поштучно через эти операторы:
Если же работать с коллекциями вместо простых массивов, то можно реализовать и так:
Здесь у объектов класса CartItem скрипт считывает цену и количество. А как собирается результат? Потоком:
По этому примеру придумал скринкаст о подсчёте скидок. За ним ещё будет о написании многопоточного парсера, показывающий пользу неизменяемых данных при распараллеливании процессов. Кто ещё не подписался на вебинары, тот, как обычно, будет в пролёте.
Работа сайта
Во-вторых, можно отследить нить исполнения самого сайта. Он выглядит как сложная функция от запроса:
Теперь вызываем что-то вроде этого:
и видим сгенерированный ответ в виде массива:
или в виде объекта Response.
Вы это могли заметить во входном скрипте проекта web/app.php на Symfony:
в public/index.php в Laravel:
и в методе run() класса приложения yii\base\Application в Yii2:
Та же конвертация константы request в результат response , как и списка профилей в список сообществ.
И аналогично каждое действие контроллера и каждый middleware принимает Request и возвращает Response .
Соответственно, здесь фактически используется функциональный подход с чтением из базы текущих данных, прогоном их через шаблонизатор и возвратом из контроллера результата в виде Response-объекта. Сложности возникают лишь при изменении значений, поэтому сущности вроде User или Product можно оставить обычными объектами с изменяемым состоянием.
Вывод
Если рассматриваем проект как совокупность «ящиков», то удобно использовать ООП. Если как потоки преобразований данных, то удобнее ФП. Если это не подходит, то делаем гибрид или придумываем что-нибудь другое. Весьма забавно выглядят порой попытки спрограммировать «ящики» на функциональном подходе или реализовать гибкие преобразователи данных на ООП. И какой из этого главный вывод?
Чем больше парадигм и фреймворков знаешь (и умеешь), тем адекватнее можешь их сравнивать и выбирать.
Пока на этом всё. А попрактикуемся в функциональном программировании уже на вебинарах. Записывайтесь на эфир, чтобы там задать свои вопросы и раньше всех получить записи скринкастов. И оставляйте комментарии, если хотите что-то сказать или спросить.