Программирование на основе потоков — Flow-based programming
В компьютерном программировании , расход на основе программирования ( FBP ) является парадигмой программирования , которая определяет приложения , как сети «черный ящик» процессы , которые обмениваются данные через предопределенные соединений путем передачу сообщений , где соединение , указанные извне к процессам. Эти процессы черного ящика можно бесконечно повторно подключать для формирования различных приложений без необходимости внутреннего изменения. Таким образом, FBP естественно ориентирован на компоненты .
FBP — это особая форма программирования потока данных, основанная на ограниченных буферах, информационных пакетах с определенным временем жизни, именованных портах и отдельном определении соединений.
СОДЕРЖАНИЕ
Вступление
Программирование на основе потоков определяет приложения, используя метафору «фабрики данных». Он рассматривает приложение не как единый последовательный процесс, который начинается в определенный момент времени, а затем выполняет одно действие за раз, пока не завершится, а как сеть асинхронных процессов, обменивающихся данными посредством потоков структурированных блоков данных, так называемые «информационные пакеты» (IP). В этом представлении основное внимание уделяется данным приложения и преобразованиям, применяемым к ним для получения желаемых результатов. Сеть определяется внешне по отношению к процессам, как список соединений, который интерпретируется программным обеспечением, обычно называемым «планировщиком».
Процессы обмениваются данными посредством соединений с фиксированной пропускной способностью. Соединение присоединяется к процессу через порт , имя которого согласовано между кодом процесса и определением сети. Один и тот же фрагмент кода может выполнять несколько процессов. В любой момент времени данный IP может принадлежать только одному процессу или находиться в пути между двумя процессами. Порты могут быть простыми или массивными, как, например, для входного порта компонента Collate, описанного ниже. Это сочетание портов с асинхронными процессами, которое позволяет поддерживать многие длительные примитивные функции обработки данных, такие как сортировка, слияние, суммирование и т. Д., В виде программных черных ящиков .
Поскольку процессы FBP могут продолжать выполняться до тех пор, пока у них есть данные для работы и место для вывода результатов, приложения FBP обычно работают за меньшее время, чем обычные программы, и оптимально используют все процессоры на машине, без специального программирования. для достижения этой цели.
Определение сети обычно схематично и преобразуется в список соединений на каком-либо языке нижнего уровня или в нотации. FBP часто является визуальным языком программирования на этом уровне. Более сложные определения сетей имеют иерархическую структуру, состоящую из подсетей с «липкими» соединениями. Многие другие потоковые языки / среды выполнения построены на более традиционных языках программирования, наиболее ярким примером является RaftLib, который использует операторы, подобные iostream C ++, для определения потокового графа.
FBP имеет много общего с языком Linda в том смысле, что он, по терминологии Гелернтера и Карриеро, является «координационным языком»: он по существу не зависит от языка. Действительно, при наличии планировщика, написанного на достаточно низкоуровневом языке, компоненты, написанные на разных языках, могут быть связаны вместе в единую сеть. Таким образом, FBP поддается концепции предметно-ориентированных языков или «мини-языков».
FBP демонстрирует «связывание данных», описанное в статье о связывании как наиболее слабый тип связи между компонентами. Концепция слабой связи , в свою очередь, связана с концепцией сервис-ориентированных архитектур , и FBP соответствует ряду критериев для такой архитектуры, хотя и на более детальном уровне, чем большинство примеров этой архитектуры.
FBP продвигает высокоуровневый функциональный стиль спецификаций, который упрощает рассуждения о поведении системы. Примером этого является модель распределенного потока данных для конструктивного определения и анализа семантики распределенных многосторонних протоколов.
История
Программирование на основе потоков было изобретено Дж. Полом Моррисоном в начале 1970-х годов и первоначально реализовано в программном обеспечении для канадского банка. FBP с самого начала находился под сильным влиянием некоторых языков моделирования IBM того периода, в частности GPSS , но его корни уходят корнями в основополагающую статью Конвея о том, что он называл сопрограммами .
FBP претерпел ряд изменений в названии за эти годы: исходная реализация называлась AMPS (Advanced Modular Processing System). Одно крупное приложение в Канаде было запущено в 1975 году, а по состоянию на 2013 год оно находилось в непрерывном производственном использовании, работало ежедневно в течение почти 40 лет. Поскольку IBM сочла идеи, лежащие в основе FBP, «слишком похожи на закон природы», чтобы их можно было запатентовать, они вместо этого поместили базовые концепции FBP в общественное достояние с помощью бюллетеня технического раскрытия информации «Система программирования реагирующих на данные модульных задач с чередованием задач». , в 1971 году. В 1978 году в журнале IBM Research IBM Systems Journal под названием DSLM была опубликована статья с описанием концепции и опыта ее использования . Вторая реализация была осуществлена как совместный проект IBM Canada и IBM Japan под названием «Data Flow Development Manager» (DFDM) и некоторое время продавалась в Японии в конце 80-х годов под названием «Data Flow Programming Manager».
Обычно в IBM эти концепции назывались «потоком данных», но этот термин считался слишком общим, и в конечном итоге было принято название «программирование на основе потоков».
С начала 80-х до 1993 года Дж. Пол Моррисон и архитектор IBM Уэйн Стивенс усовершенствовали и продвигали концепции, лежащие в основе FBP. Стивенс написал несколько статей, описывающих и поддерживающих концепцию FBP, и включил материал об этом в несколько своих книг. В 1994 году Моррисон опубликовал книгу, описывающую FBP и предоставляющую эмпирические доказательства того, что FBP приводит к сокращению времени разработки.
Концепции
На следующей диаграмме показаны основные элементы диаграммы FBP (кроме информационных пакетов). Такая диаграмма может быть преобразована непосредственно в список соединений, который затем может быть выполнен соответствующим механизмом (программным или аппаратным).

A, B и C — это процессы, выполняющие компоненты кода. O1, O2 и два IN — это порты, соединяющие соединения M и N с соответствующими процессами. Процессам B и C разрешено выполнять один и тот же код, поэтому каждый процесс должен иметь свой собственный набор рабочей памяти, блоков управления и т. Д. Независимо от того, используют ли они общий код, B и C могут использовать один и тот же порт. имена, поскольку имена портов имеют значение только в компонентах, которые на них ссылаются (и, конечно, на сетевом уровне).
M и N — это то, что часто называют « ограниченными буферами », и они имеют фиксированную емкость с точки зрения количества IP-адресов, которые они могут удерживать в любой момент времени.
Концепция портов — это то, что позволяет использовать один и тот же компонент в более чем одном месте сети. В сочетании с возможностью параметризации, называемой пакетами начальной информации (IIP), порты предоставляют FBP возможность многократного использования компонентов, что делает FBP компонентной архитектурой. Таким образом, FBP демонстрирует то, что Рауль де Кампо и Нейт Эдвардс из IBM Research назвали настраиваемой модульностью .
Информационные пакеты или IP-адреса выделяются в так называемом «пространстве IP» (так же, как кортежи Линды выделяются в «пространстве кортежей»), и имеют четко определенный срок жизни до тех пор, пока они не будут удалены и их пространство не будет освобождено — в FBP это должно быть явным действием со стороны процесса-владельца. IP-адреса, перемещающиеся по данному соединению (на самом деле, это их «дескрипторы»), составляют «поток», который генерируется и потребляется асинхронно — таким образом, эта концепция имеет сходство с концепцией ленивых минусов, описанной в статье Friedman and Wise 1976 года.
IP-адреса обычно представляют собой структурированные блоки данных — однако некоторые IP-адреса могут не содержать никаких реальных данных, а используются просто как сигналы. Примером этого являются «IP-адреса в скобках», которые можно использовать для группировки IP-адресов данных в последовательные шаблоны в потоке, называемые «субпотоками». Подпотоки, в свою очередь, могут быть вложенными. IP-адреса также могут быть объединены в цепочки для формирования «IP-деревьев», которые перемещаются по сети как отдельные объекты.
Описанная выше система связей и процессов может быть «разветвлена» до любого размера. Во время разработки приложения процессы мониторинга могут быть добавлены между парами процессов, процессы могут быть «разбиты» на подсети, или моделирование процессов может быть заменено логикой реального процесса. Таким образом, FBP позволяет быстро создавать прототипы .
На самом деле это образ обработки данных с конвейера : IP-адреса, перемещающиеся по сети процессов, можно рассматривать как виджеты, перемещающиеся от станции к станции на конвейере. «Машины» можно легко переподключить, вывести в ремонт, заменить и так далее. Как ни странно, это изображение очень похоже на изображение оборудования для записи единиц, которое использовалось для обработки данных до дней компьютеров, за исключением того, что колоды карт приходилось переносить вручную с одной машины на другую.
Реализации FBP могут быть не вытесняющими или вытесняющими — более ранние реализации, как правило, не вытесняли (мэйнфреймы и язык C), тогда как последняя реализация Java (см. Ниже) использует класс Java Thread и является вытесняющей.
Примеры
«Проблема с Telegram»
Компоненты FBP часто образуют дополнительные пары. В этом примере используются две такие пары. Описанная проблема кажется очень простой, если ее описать словами, но на самом деле ее удивительно трудно решить, используя обычную процедурную логику. Задача, названная «Проблема телеграммы», первоначально описанная Питером Науром , состоит в том, чтобы написать программу, которая принимает строки текста и генерирует выходные строки, содержащие как можно больше слов, где количество символов в каждой строке не превышает определенного длина. Слова не могут быть разделены, и мы предполагаем, что ни одно слово не длиннее, чем размер строк вывода. Это аналогично проблеме переноса слов в текстовых редакторах.
В традиционной логике программист быстро обнаруживает, что ни входные, ни выходные структуры не могут использоваться для управления иерархией вызовов потока управления . В FBP, с другой стороны, само описание проблемы предлагает решение:
- «слова» явно упоминаются в описании проблемы, поэтому для разработчика разумно рассматривать слова как информационные пакеты (IP).
- в FBP нет единой иерархии вызовов, поэтому программист не склонен заставлять подшаблон решения быть верхним уровнем.
Вот наиболее естественное решение в FBP (в FBP нет единого «правильного» решения, но оно кажется естественным):

где DC и RC обозначают «DeCompose» и «ReCompose» соответственно.
Как упоминалось выше, пакеты исходной информации (IIP) могут использоваться для указания параметрической информации, такой как желаемая длина выходной записи (требуемая двумя крайними правыми компонентами) или имена файлов. IIP — это блоки данных, связанные с портом в определении сети, которые становятся «обычными» IP-адресами, когда для соответствующего порта выдается «получение».
Пакетное обновление
Этот тип программы включает передачу файла «деталей» (изменений, добавлений и удалений) в «главный файл» и создание (по крайней мере) обновленного главного файла и одного или нескольких отчетов. Программы обновления, как правило, довольно сложно закодировать с использованием синхронного процедурного кода, так как два (иногда больше) входных потока должны синхронизироваться, даже если могут быть мастера без соответствующих деталей, или наоборот.

В FBP компонент многократного использования (Collate), основанный на идее единичной записи Collator, значительно упрощает написание этого типа приложения, поскольку Collate объединяет два потока и вставляет IP-адреса в скобках для обозначения уровней группировки, что значительно упрощает логику нисходящего потока. Предположим, что один поток (в данном случае «мастера») состоит из IP-адресов со значениями ключей 1, 2 и 3, а IP-адреса второго потока («подробности») имеют значения ключей 11, 12, 21, 31, 32, 33. и 41, где первая цифра соответствует значениям главного ключа. Используя символы скобок для представления IP-адресов «в скобках», выходной поток с сортировкой будет выглядеть следующим образом:
Поскольку не было мастера со значением 4, последняя группа состоит из одной детали (плюс скобки).
Структура вышеуказанного потока может быть кратко описана с использованием BNF- подобных обозначений, таких как
Collate — это многоразовый черный ящик, которому нужно только знать, где находятся поля управления в его входящих IP-адресах (даже это не является строго необходимым, поскольку процессы преобразования могут быть вставлены вверх по потоку для размещения полей управления в стандартных местах) и фактически могут быть обобщены к любому количеству входных потоков и любой глубине вложения скобок. Collate использует порт типа массива для ввода, что позволяет изменять количество входных потоков.
Процессы мультиплексирования
Программирование на основе потоков естественным образом поддерживает мультиплексирование процессов. Поскольку компоненты доступны только для чтения, любое количество экземпляров данного компонента («процессов») может выполняться асинхронно друг с другом.

Когда в компьютерах обычно был один процессор, это было полезно при большом количестве операций ввода-вывода; Теперь, когда машины обычно имеют несколько процессоров, это становится полезным, когда процессы также интенсивно загружают процессор. На схеме в этом разделе показан один процесс «Load Balancer», распределяющий данные между тремя процессами, обозначенными S1, S2 и S3, соответственно, которые являются экземплярами одного компонента, которые, в свою очередь, передаются в один процесс в порядке очереди. первому обслуживающему «основанию».
Простая интерактивная сеть

В этой общей схеме запросы (транзакции), поступающие от пользователей, входят в диаграмму в верхнем левом углу, а ответы возвращаются в нижнем левом углу. «Бэк-энды» (справа) взаимодействуют с системами на других сайтах, например, с помощью CORBA , MQSeries и т. Д. Кросс-соединения представляют собой запросы, которые не нужно переходить к бэкэндам, или запросы, которые должны циклически проходить через сеть более одного раза перед возвратом пользователю.
Поскольку разные запросы могут использовать разные серверные части и могут требовать разного количества времени для серверных компонентов (если они используются) для их обработки, необходимо обеспечить связь возвращаемых данных с соответствующими запрашивающими транзакциями, например, хеш-таблицами или кешами.
Приведенная выше диаграмма является схематической в том смысле, что окончательное приложение может содержать намного больше процессов: процессы могут быть вставлены между другими процессами для управления кешами, отображения трафика соединения, контроля пропускной способности и т. Д. Также блоки на диаграмме могут представлять «подсети» — небольшие сети с одним или несколькими открытыми соединениями.
Сравнение с другими парадигмами и методологиями
Структурированное программирование Джексона (JSP) и разработка систем Джексона (JSD)
Эта методология предполагает, что программа должна быть структурирована как единая процедурная иерархия подпрограмм. Его отправной точкой является описание приложения как набора «основных строк» на основе структур входных и выходных данных. Затем одна из этих «основных линий» выбирается для управления всей программой, а остальные требуется «инвертировать», чтобы превратить их в подпрограммы (отсюда и название «инверсия Джексона»). Иногда это приводит к так называемому «конфликту», когда требуется разбить программу на несколько программ или сопрограмм. При использовании FBP этот процесс инверсии не требуется, поскольку каждый компонент FBP можно рассматривать как отдельную «главную линию».
FBP и JSP разделяют концепцию обработки программы (или некоторых компонентов) как парсера входного потока.
В более поздней работе Джексона , Jackson System Development (JSD), идеи получили дальнейшее развитие.
В JSD дизайн сохраняется как дизайн сети до финальной стадии реализации. Затем модель преобразуется в набор последовательных процессов по количеству доступных процессоров. Джексон обсуждает возможность прямого выполнения сетевой модели, существовавшей до этого шага, в разделе 1.3 своей книги (курсив добавлен):
Спецификация, созданная в конце этапа System Timing, в принципе, может быть выполнена напрямую. Необходимая среда будет содержать процессор для каждого процесса, устройство, эквивалентное неограниченному буферу для каждого потока данных, и некоторые устройства ввода и вывода, через которые система подключена к реальному миру. Такая среда, конечно, может быть обеспечена подходящим программным обеспечением, работающим на достаточно мощной машине. Иногда такое прямое выполнение спецификации возможно и даже может быть разумным выбором.
М. А. Джексон признал FBP подходом, который следует его методу «декомпозиции программы на последовательные процессы, взаимодействующие с помощью механизма, подобного сопрограммам».
Аппликативное программирование
WB Ackerman определяет аппликативный язык как язык, который выполняет всю свою обработку с помощью операторов, применяемых к значениям. Самым ранним из известных прикладных языков был LISP.
Компонент FBP можно рассматривать как функцию, преобразующую входной поток (потоки) в выходной поток (потоки). Затем эти функции объединяются для выполнения более сложных преобразований, как показано здесь:

Если мы помечаем потоки, как показано, строчными буквами, то приведенную выше диаграмму можно кратко представить следующим образом:
Так же, как в функциональной нотации F может использоваться дважды, потому что он работает только со значениями и, следовательно, не имеет побочных эффектов, в FBP два экземпляра данного компонента могут работать одновременно друг с другом, и поэтому компоненты FBP не должны иметь побочных эффектов. или. Функциональная нотация может явно использоваться для представления хотя бы части сети FBP.
Тогда возникает вопрос, могут ли сами компоненты FBP быть выражены с использованием функциональной нотации. WH Burge показал, как выражения потока могут быть разработаны с использованием рекурсивного, прикладного стиля программирования, но эта работа была в терминах (потоков) атомарных значений. В FBP необходимо иметь возможность описывать и обрабатывать блоки структурированных данных (IP-адреса FBP).
Более того, большинство прикладных систем предполагают, что все данные доступны в памяти одновременно, тогда как приложения FBP должны иметь возможность обрабатывать длительные потоки данных, по-прежнему используя ограниченные ресурсы. Фридман и Уайз предложили способ сделать это, добавив понятие «ленивых противников» к работе Берджа. Это сняло требование, чтобы оба аргумента «против» были доступны в один и тот же момент времени. «Ленивые минусы» фактически не создают поток, пока не будут реализованы оба его аргумента — до этого он просто записывает «обещание» сделать это. Это позволяет динамически реализовывать поток спереди, но с нереализованным сервером. Конец потока остается нереализованным до самого конца процесса, в то время как начало представляет собой постоянно увеличивающуюся последовательность элементов.
Линда
Многие концепции FBP, кажется, были открыты независимо в разных системах на протяжении многих лет. Упомянутая выше Линда — одна из таких. Разница между этими двумя методами иллюстрируется техникой балансировки нагрузки «школы пираний» Линды — в FBP для этого требуется дополнительный компонент «балансировщик нагрузки», который направляет запросы к компоненту в списке, который имеет наименьшее количество IP-адресов, ожидающих передачи. быть обработанным. Очевидно, что FBP и Linda тесно связаны, и одно можно легко использовать для моделирования другого.
Объектно-ориентированное программирование
Объект в ООП можно описать как полуавтономную единицу, содержащую как информацию, так и поведение. Объекты общаются посредством «вызовов методов», которые, по сути, являются вызовами подпрограмм, выполняемыми косвенно через класс, к которому принадлежит принимающий объект. Доступ к внутренним данным объекта возможен только с помощью вызовов методов, так что это форма сокрытия информации или «инкапсуляции». Однако инкапсуляция предшествует ООП — Дэвид Парнас написал одну из основополагающих статей по ней в начале 70-х годов — и является базовой концепцией в вычислениях. Инкапсуляция — это самая суть компонента FBP, который можно рассматривать как черный ящик , выполняющий некоторое преобразование входных данных в выходные данные. В FBP часть спецификации компонента — это форматы данных и структуры потоков, которые он может принимать и которые он будет генерировать. Это форма проектирования по контракту . Кроме того, данные в IP могут быть доступны напрямую только процессу, владеющему в данный момент. Инкапсуляция также может быть реализована на сетевом уровне, если внешние процессы защищают внутренние.
В статье К. Эллиса и С. Гиббса проводится различие между активными и пассивными объектами. Пассивные объекты включают в себя информацию и поведение, как указано выше, но они не могут определить синхронизацию этого поведения. С другой стороны, активные объекты могут это сделать. В своей статье Эллис и Гиббс утверждают, что активные объекты имеют гораздо больший потенциал для развития обслуживаемых систем, чем пассивные объекты. Приложение FBP можно рассматривать как комбинацию этих двух типов объектов, где процессы FBP будут соответствовать активным объектам, а IP-адреса будут соответствовать пассивным объектам.
Актерская модель
FBP рассматривает Актера Карла Хьюитта как асинхронный процесс с 2 портами: один для входных сообщений и один для управляющих сигналов. Управляющий сигнал испускается самим субъектом после каждого раунда выполнения. Цель этого сигнала — избежать параллельного выполнения тела актера и, таким образом, разрешить доступ к полям объекта актера без синхронизации.
Sorry, you have been blocked
This website is using a security service to protect itself from online attacks. The action you just performed triggered the security solution. There are several actions that could trigger this block including submitting a certain word or phrase, a SQL command or malformed data.
What can I do to resolve this?
You can email the site owner to let them know you were blocked. Please include what you were doing when this page came up and the Cloudflare Ray ID found at the bottom of this page.
Cloudflare Ray ID: 7e932dcf1fa638b4 • Your IP: Click to reveal 178.132.110.2 • Performance & security by Cloudflare
Fbp что это такое
Англо-русский словарь технических аббревиатур . 2011 .
Смотреть что такое «FBP» в других словарях:
FBP — may refer to:*Flow based programming, is a computer programming paradigm that defines applications as networks of processes, exchanging data across predefined connections by message passing.* Fructose 1,6 bisphosphate*FBP 9 submachine gun … Wikipedia
FBP — steht für: Fahrmischerbetonpumpe, eine Kombination aus Betonpumpe und Fahrmischer Ferrovia Bologna Portomagiore, eine italienische Eisenbahngesellschaft Filtered Backprojection, ein Verfahren in der Computertomographie Final Boiling Point, die… … Deutsch Wikipedia
FBP submachine gun — Infobox Weapon name=FBP caption=FBP m/948 origin=flag|Portugal type=Submachine Gun is ranged=yes service=1948 1980s used by=Portugal wars=Portuguese Colonial War designer=Gonçalves Cardoso design date=1948 manufacturer=Fábrica de Braço de Prata… … Wikipedia
FBP m/948 — Пистолет пулемет FBP m/948 (Португалия) Пистолет пулемет FBP m/948 с приливом для крепления штыка на стволе Пистолет пулемет FBP m/948 Характеристики Пистолет пулемет FBP m/948 был разработан португальским оружейным заводом… … Энциклопедия стрелкового оружия
FBP m/976 — Пистолет пулемет FBP m/976 (Португалия) Характеристики Пистолет пулемет FBP m/976 был принят на вооружение португальской армии в 1976 году на замену устаревшему пистолету пулемету FBP m/948. По сравнению с предшественником новый… … Энциклопедия стрелкового оружия
FBP — Fructose 1,6 diphosphate Fructose 1,6 diphosphate Général Nom IUPAC acide [(2R,3S,4R,5R) 2,3,4 trihydroxy 5 (phosphonooxymethyl) … Wikipédia en Français
FBP — Flow Based Programming (Computing » Software) * Foreign Buyer Program (Business » International Business) * First Bancorp of Puerto Rico (Business » NYSE Symbols) … Abbreviations dictionary
FBP PA — First Bancorp of Puerto Rico Preferred A (Business » NYSE Symbols) … Abbreviations dictionary
FBP — femoral blood pressure; fibrin breakdown product; filtered back projection [algorithm]; folate binding protein; fructose 1, 6 biphosphatase … Medical dictionary
FBP — FASTBUS Protcol ( > IEEE Standard Dictionary ) … Acronyms
FBP — FASTBUS Protcol ( > IEEE Standard Dictionary ) … Acronyms von A bis Z
Программирование на основе потоков — Flow-based programming
В компьютерное программирование, программирование на основе потоков (FBP ) — это парадигма программирования, которая определяет приложения как сети «черного ящика» процессов, которые обмениваются данными по предопределенным соединениям посредством передачи сообщений, где соединения указываются извне для процессов. Эти процессы черного ящика можно бесконечно повторно связывать для формирования различных приложений без необходимости внутреннего изменения. Таким образом, FBP, естественно, компонентно-ориентированный.
FBP — это особая форма программирования потока данных, основанная на ограниченных буферах, информационных пакетах с определенным временем жизни, именованных портах и отдельном определении соединений.
Содержание
- 1 Введение
- 2 История
- 3 Концепции
- 4 Примеры
- 4.1 «Проблема Telegram»
- 4.2 Пакетное обновление
- 4.3 Процессы мультиплексирования
- 4.4 Простое интерактивное сеть
- 5.1 Структурированное программирование Джексона (JSP) и разработка систем Джексона (JSD)
- 5.2 Аппликативное программирование
- 5.3 Линда
- 5.4 Объектно-ориентированное программирование
- 5.5 Модель акторов
Введение
Программирование на основе потоков определяет приложения с использованием метафоры «фабрики данных». Он рассматривает приложение не как отдельный последовательный процесс, который начинается в определенный момент времени, а затем выполняет одно действие за раз, пока не завершится, а как сеть асинхронных процессов, взаимодействующих с помощью потоков блоков структурированных данных, называемых «информационными пакетами» (IP). В этом представлении основное внимание уделяется данным приложения и преобразованиям, применяемым к ним для получения желаемых результатов. Сеть определяется внешне по отношению к процессам в виде списка соединений, который интерпретируется программным обеспечением, обычно называемым «планировщиком».
Процессы взаимодействуют посредством соединений с фиксированной пропускной способностью. Соединение подключается к процессу посредством порта , имя которого согласовано между кодом процесса и определением сети. Один и тот же фрагмент кода может выполнять несколько процессов. В любой момент времени данный IP-адрес может принадлежать только одному процессу или находиться в пути между двумя процессами. Порты могут быть простыми или массивными, например, для входного порта компонента Collate, описанного ниже. Это сочетание портов с асинхронными процессами, которое позволяет поддерживать многие длительные примитивные функции обработки данных, такие как сортировка, слияние, суммирование и т. Д., В форме программного обеспечения черные ящики.
Поскольку FBP процессы могут продолжать выполняться до тех пор, пока у них есть данные для работы и где-то для вывода, приложения FBP обычно работают за меньшее время, чем обычные программы, и оптимально используют все процессоры на машине, без специального программирования, необходимого для достижения это.
Определение сети обычно схематично и преобразуется в список соединений на каком-либо языке нижнего уровня или в нотации. FBP часто является языком визуального программирования на этом уровне. Более сложные определения сетей имеют иерархическую структуру, состоящую из подсетей с «липкими» соединениями. Многие другие потоковые языки / среды выполнения построены на более традиционных языках программирования, наиболее ярким примером является RaftLib, который использует операторы C ++, подобные iostream, для указания потокового графа.
FBP имеет много общего с языком Linda в том, что, по терминологии Гелернтера и Карриеро, он является «координационным языком»: он по существу не зависит от языка. Действительно, при наличии планировщика, написанного на достаточно низкоуровневом языке, компоненты, написанные на разных языках, могут быть связаны в единую сеть. Таким образом, FBP поддается концепции предметно-ориентированных языков или «мини-языков».
FBP демонстрирует «связывание данных», описанное в статье о соединении, как наиболее слабый тип связи между компонентами. Концепция слабой связи, в свою очередь, связана с концепцией сервис-ориентированных архитектур, и FBP соответствует ряду критериев для такой архитектуры, хотя и на более детальном уровне. чем большинство примеров этой архитектуры.
FBP продвигает высокоуровневый функциональный стиль спецификаций, который упрощает рассуждения о поведении системы. Примером этого является модель распределенного потока данных для конструктивного определения и анализа семантики распределенных многосторонних протоколов.
История
Программирование на основе потоков было изобретено Дж. Полом Моррисоном в начале 1970-х годов и первоначально реализовано в программном обеспечении для канадского банка. FBP с самого начала находился под сильным влиянием некоторых языков моделирования IBM того периода, в частности, GPSS, но его корни уходят корнями в основополагающую статью Конвея о том, что он назвал сопрограммы.
FBP претерпел ряд изменений названия за прошедшие годы: исходная реализация называлась AMPS (Advanced Modular Processing System). Одно крупное приложение в Канаде было запущено в 1975 году, а по состоянию на 2013 год оно находилось в непрерывном производственном использовании, работало ежедневно в течение почти 40 лет. Поскольку IBM сочла идеи, лежащие в основе FBP, «слишком похожи на закон природы», чтобы их можно было запатентовать, они вместо этого поместили базовые концепции FBP в общественное достояние посредством Бюллетеня технических раскрытий, «Data Responsive Modular, Interleaved Task Programming System », в 1971 году. Статья, описывающая ее концепции и опыт ее использования, была опубликована в 1978 году в журнале IBM Research IBM Systems Journal под названием DSLM. Вторая реализация была осуществлена как совместный проект IBM Canada и IBM Japan под названием «Data Flow Development Manager» (DFDM) и недолго продавалась в Японии в конце 80-х годов под названием «Data Flow Programming Manager».
Обычно в IBM эти концепции назывались «потоком данных», но этот термин считался слишком общим, и в конечном итоге было принято название «программирование на основе потоков».
С начала 80-х до 1993 года Дж. Пол Моррисон и архитектор IBM Уэйн Стивенс усовершенствовали и продвигали концепции, лежащие в основе FBP. Стивенс написал несколько статей, описывающих и поддерживающих концепцию FBP, и включил материалы об этом в несколько своих книг. В 1994 году Моррисон опубликовал книгу, описывающую FBP и предоставляющую эмпирические доказательства того, что FBP приводит к сокращению времени разработки.
Основные понятия
На следующей диаграмме показаны основные элементы диаграммы FBP (кроме информационных пакетов). Такая диаграмма может быть преобразована непосредственно в список соединений, который затем может быть выполнен соответствующим механизмом (программным или аппаратным).
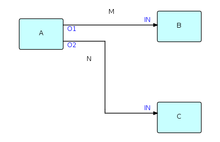 Простая диаграмма FBP
A, B и C — это процессы, выполняющие компоненты кода. O1, O2 и два IN — это порты, соединяющие соединения M и N с соответствующими процессами. Процессам B и C разрешено выполнять один и тот же код, поэтому каждый процесс должен иметь свой собственный набор рабочей памяти, блоков управления и т. Д. Независимо от того, используют ли они общий код, B и C могут использовать один и тот же порт. имена, поскольку имена портов имеют значение только в компонентах, которые на них ссылаются (и, конечно, на уровне сети).
M и N — это то, что часто называют «ограниченными буферами », и они имеют фиксированную емкость с точки зрения количества IP-адресов, которые они могут удерживать в любой момент времени.
Концепция портов — это то, что позволяет использовать один и тот же компонент в более чем одном месте в сети. В сочетании с возможностью параметризации, называемой пакетами начальной информации (IIP), порты предоставляют FBP возможность многократного использования компонентов, что делает FBP компонентной архитектурой. Таким образом, FBP демонстрирует то, что Рауль де Кампо и Нейт Эдвардс из IBM Research назвали настраиваемой модульностью.
Информационные пакеты или IP-адреса распределяются в том, что можно было бы назвать «IP-пространством» (так же, как кортежи Линды выделяются в «пространстве кортежей») и имеют четко определенное время жизни до тех пор, пока они не будут удалены и их пространство не будет освобождено — в FBP это должно быть явным действием со стороны процесса-владельца. IP-адреса, перемещающиеся по данному соединению (на самом деле, это их «дескрипторы») составляют «поток», который генерируется и потребляется асинхронно — таким образом, эта концепция имеет сходство с концепцией lazy cons, описанной в 1976 г. статья Фридмана и Уайза.
IP-адреса обычно представляют собой структурированные блоки данных — однако некоторые IP-адреса могут не содержать никаких реальных данных, а используются просто как сигналы. Примером этого являются «IP-адреса в скобках», которые можно использовать для группировки IP-адресов данных в последовательные шаблоны в потоке, называемые «субпотоками». Подпотоки, в свою очередь, могут быть вложенными. IP-адреса также могут быть объединены в цепочки для формирования «IP-деревьев», которые перемещаются по сети как отдельные объекты.
Описанная выше система связей и процессов может быть «разветвлена» до любого размера. Во время разработки приложения процессы мониторинга могут быть добавлены между парами процессов, процессы могут быть «разбиты» на подсети или моделирование процессов может быть заменено реальной логикой процесса. Таким образом, FBP поддается быстрому прототипированию.
Это на самом деле сборочная линия образ обработки данных: IP-адреса, перемещающиеся через сеть процессов, можно рассматривать как виджеты, перемещающиеся от станции к станции в сборочная линия. «Машины» можно легко переподключить, вывести в ремонт, заменить и так далее. Как ни странно, это изображение очень похоже на изображение записывающего устройства, которое использовалось для обработки данных до дней компьютеров, за исключением того, что колоды карт приходилось переносить вручную с одной машины на другую.
Реализации FBP могут быть не вытесняющими или вытесняющими — более ранние реализации, как правило, не вытесняли (мэйнфреймы и язык C), тогда как последняя реализация Java (см. Ниже) использует класс Java Thread и является вытесняющей.
Примеры
«Проблема с телеграммой»
Компоненты FBP часто образуют дополнительные пары. В этом примере используются две такие пары. Описанная проблема кажется очень простой, если ее описать словами, но на самом деле ее удивительно трудно решить, используя обычную процедурную логику. Задача, названная «Проблема Telegram», первоначально описанная Питером Науром, состоит в том, чтобы написать программу, которая принимает строки текста и генерирует выходные строки, содержащие как можно больше слов, где количество символов в каждом линия не превышает определенной длины. Слова не могут быть разделены, и мы предполагаем, что ни одно слово не длиннее, чем размер строк вывода. Это аналогично проблеме переноса слов в текстовых редакторах.
В традиционной логике программист быстро обнаруживает, что ни входные, ни выходные структуры не могут использоваться для управления иерархией вызовов потока управления. В FBP, с другой стороны, само описание проблемы предлагает решение:
- «слова» явно упоминаются в описании проблемы, поэтому для разработчика разумно рассматривать слова как информационные пакеты (IP)
- в FBP нет единой иерархии вызовов, поэтому у программиста нет соблазна заставить подчиненный шаблон решения быть верхним уровнем.
Это наиболее естественное решение в FBP (единого «правильное» решение в FBP, но оно кажется естественным):
 «Проблема Telegram» Питера Наура
, где DC и RC обозначают «DeCompose» и «ReCompose» соответственно.
Как упоминалось выше, пакеты исходной информации (IIP) могут использоваться для указания параметрической информации, такой как желаемая длина выходной записи (требуемая двумя крайними правыми компонентами) или имена файлов. IIP — это блоки данных, связанные с портом в определении сети, которые становятся «обычными» IP-адресами, когда для соответствующего порта выдается «получение».
Пакетное обновление
Этот тип программы включает в себя передачу файла «деталей» (изменения, добавления и удаления) в «главный файл» и создание (по крайней мере) обновленного главного файла, и один или несколько отчетов. Программы обновления, как правило, довольно сложно кодировать с использованием синхронного процедурного кода, так как два (иногда больше) входных потока должны синхронизироваться, даже если могут быть мастера без соответствующих деталей, или наоборот.
 Каноническая структура «пакетного обновления»
В FBP многократно используемый компонент (Collate), основанный на идее unit record о Collator, значительно упрощает написание этого типа приложения, поскольку Collate объединяет два потока и вставляет IP-адреса в скобки для обозначения уровней группировки, что значительно упрощает логику нисходящего потока. Предположим, что один поток (в данном случае «мастера») состоит из IP-адресов со значениями ключей 1, 2 и 3, а IP-адреса второго потока («подробности») имеют значения ключей 11, 12, 21, 31, 32, 33. и 41, где первая цифра соответствует значениям главного ключа. Используя символы скобок для представления IP-адресов «в квадратных скобках», сортированный выходной поток будет следующим:
Как Мастера со значением 4 не было, последняя группа состоит из одной детали (плюс скобки).
Структура вышеуказанного потока может быть кратко описана с использованием BNF -подобной нотации, такой как
Collate — это многоразовый черный ящик, которому нужно только знать, где находятся поля управления в его входящих IP-адресах (даже это не является строго необходимым, поскольку процессы преобразования могут быть вставлены выше по потоку, чтобы разместить поля управления в стандартных местах.), и фактически может быть обобщен на любое количество входных потоков и любую глубину вложенности в скобки. Collate использует порт типа массива для ввода, что позволяет изменять количество входных потоков.
Процессы мультиплексирования
Потоковое программирование поддерживает мультиплексирование процессов очень естественным образом. Поскольку компоненты доступны только для чтения, любое количество экземпляров данного компонента («процессов») может выполняться асинхронно друг с другом.
 Пример мультиплексирования
Когда в компьютерах обычно был один процессор, это было полезно, когда выполнялось много операций ввода-вывода; Теперь, когда машины обычно имеют несколько процессоров, это становится полезным, когда процессы также интенсивно загружают процессор. На схеме в этом разделе показан один процесс «Load Balancer», распределяющий данные между 3 процессами, обозначенными S1, S2 и S3, соответственно, которые являются экземплярами одного компонента, которые, в свою очередь, передаются в один процесс в порядке очереди. первому обслуживающему «основанию».
Простая интерактивная сеть
Схема общего интерактивного приложенияВ этой общей схеме запросы (транзакции), поступающие от пользователей, входят в диаграмму в верхнем левом углу, а ответы возвращаются в нижнем левом углу. «Серверные части» (справа) взаимодействуют с системами на других сайтах, например с использованием CORBA, MQSeries и т. д. Перекрестные соединения представляют собой запросы, которым не нужно переходить на серверы, или запросы, которые должны проходить через сеть более одного раза, прежде чем они будут вернулся к пользователю.
Поскольку разные запросы могут использовать разные серверы и могут потребовать разное количество времени для серверных частей (если они используются) для их обработки, необходимо предусмотреть связь возвращаемых данных с соответствующими запрашивающими транзакциями, например хеш-таблицы или кеши.
Приведенная выше диаграмма является схематической в том смысле, что конечное приложение может содержать намного больше процессов: процессы могут быть вставлены между другими процессами для управления кешами, отображения трафика соединения, контроля пропускной способности и т. Д. Также блоки на диаграмме может представлять «подсети» — небольшие сети с одним или несколькими открытыми соединениями.
Сравнение с другими парадигмами и методологиями
Структурированное программирование Джексона (JSP) и разработка системы Джексона (JSD)
Эта методология предполагает, что программа должна быть структурирована как единая процедурная иерархия подпрограмм. Его отправной точкой является описание приложения как набора «основных строк» на основе структур входных и выходных данных. Затем одна из этих «главных линий» выбирается для управления всей программой, а остальные требуется «инвертировать», чтобы превратить их в подпрограммы (отсюда и название «инверсия Джексона»). Иногда это приводит к так называемому «конфликту», когда требуется разбить программу на несколько программ или сопрограмм. При использовании FBP этот процесс инверсии не требуется, поскольку каждый компонент FBP может рассматриваться как отдельная «основная линия».
FBP и JSP разделяют концепцию обработки программы (или некоторых компонентов) как анализатора входного потока.
В более поздней работе Джексона, Jackson System Development (JSD), идеи получили дальнейшее развитие.
В JSD дизайн поддерживается как сетевой дизайн до окончательной реализации. этап. Затем модель преобразуется в набор последовательных процессов по количеству доступных процессоров. Джексон обсуждает возможность прямого выполнения сетевой модели, существовавшей до этого шага, в разделе 1.3 своей книги (курсив добавлен):
Спецификация, созданная в конце шага системного времени, в принципе, позволяет исполнение. Необходимая среда будет содержать процессор для каждого процесса, устройство, эквивалентное неограниченному буферу для каждого потока данных, и некоторые устройства ввода и вывода, через которые система подключена к реальному миру. Такая среда, конечно, может быть обеспечена подходящим программным обеспечением, работающим на достаточно мощной машине. Иногда такое прямое выполнение спецификации будет возможным и даже может быть разумным выбором.
FBP был признан М.А. Джексоном как подход, который следует его методу «разложения программы на последовательные процессы, взаимодействующие с помощью механизма, подобного сопрограммам. «
Аппликативное программирование
WB Акерман определяет аппликативный язык как язык, который выполняет всю свою обработку с помощью операторов, применяемых к значениям. Самым ранним известным прикладным языком был LISP.
Компонент FBP можно рассматривать как функцию, преобразующую свой входной поток (потоки) в свой выходной поток (потоки). Затем эти функции объединяются для выполнения более сложных преобразований, как показано здесь:
 Две функции, питающие одну
Если мы помечаем потоки, как показано, строчными буквами, то приведенную выше диаграмму можно кратко представить следующим образом:
Так же, как в функциональной нотации F может использоваться дважды, потому что он работает только со значениями и, следовательно, не имеет побочных эффектов, в FBP два экземпляра данного компонента могут работать одновременно друг с другом, и, следовательно, компоненты FBP также не должно иметь побочных эффектов. Функциональная нотация может использоваться для представления хотя бы части сети FBP.
Тогда возникает вопрос, могут ли сами компоненты FBP быть выражены с использованием функциональной нотации. W.H. Бердж показал, как выражения потока могут быть разработаны с использованием рекурсивного прикладного стиля программирования, но эта работа была в терминах (потоков) атомарных значений. В FBP необходимо иметь возможность описывать и обрабатывать блоки структурированных данных (IP-адреса FBP).
Более того, большинство прикладных систем предполагают, что все данные доступны в памяти одновременно, тогда как приложения FBP должны иметь возможность обрабатывать длительные потоки данных, по-прежнему используя ограниченные ресурсы. Фридман и Уайз предложили способ сделать это, добавив концепцию «ленивых минусов» к работе Берджа. Это устранило требование, чтобы оба аргумента «против» были доступны в один и тот же момент времени. «Lazy cons» фактически не создает поток, пока не будут реализованы оба его аргумента — до этого он просто записывает «обещание» сделать это. Это позволяет динамически реализовывать поток спереди, но с нереализованным сервером. Конец потока остается нереализованным до самого конца процесса, в то время как начало представляет собой постоянно увеличивающуюся последовательность элементов.
Линда
Многие концепции FBP, кажется, были открыты независимо в разных системах на протяжении многих лет. Упомянутая выше Линда — одна из таких. Разница между этими двумя методами проиллюстрирована техникой балансировки нагрузки «школы пираний» Линды — в FBP для этого требуется дополнительный компонент «балансировщик нагрузки», который направляет запросы к компоненту в списке, который имеет наименьшее количество IP-адресов, ожидающих быть обработанным. Очевидно, что FBP и Linda тесно связаны, и одно можно легко использовать для имитации другого.
Объектно-ориентированное программирование
Объект в ООП можно описать как полуавтономный блок, содержащий как информацию, так и поведение. Объекты общаются посредством «вызовов методов», которые по сути являются вызовами подпрограмм, выполняемыми косвенно через класс, к которому принадлежит принимающий объект. Доступ к внутренним данным объекта возможен только с помощью вызовов методов, так что это форма скрытия информации или «инкапсуляции». Однако инкапсуляция предшествовала ООП — Дэвид Парнас написал одну из основополагающих статей по ней в начале 70-х — и является базовой концепцией в вычислениях. Инкапсуляция — это самая суть компонента FBP, который можно представить как черный ящик, выполняющий некоторое преобразование входных данных в выходные данные. В FBP часть спецификации компонента — это форматы данных и структуры потоков, которые он может принимать и которые он будет генерировать. Это представляет собой форму проектирования по контракту. Кроме того, данные в IP могут быть доступны непосредственно только процессу, владеющему в данный момент. Инкапсуляция также может быть реализована на сетевом уровне, если внешние процессы защищают внутренние.
В статье К. Эллиса и С. Гиббса проводится различие между активными объектами и пассивными объектами. Пассивные объекты содержат информацию и поведение, как указано выше, но они не могут определять время этого поведения. С другой стороны, активные объекты могут это сделать. В своей статье Эллис и Гиббс утверждают, что активные объекты имеют гораздо больший потенциал для развития обслуживаемых систем, чем пассивные объекты. Приложение FBP можно рассматривать как комбинацию этих двух типов объектов, где процессы FBP будут соответствовать активным объектам, а IP-адреса будут соответствовать пассивным объектам.
Модель Актера
FBP рассматривает Актера Карла Хьюитта как асинхронные процессы с 2 портами: один для входных сообщений и один для сигналов управления. Управляющий сигнал испускается самим субъектом после каждого раунда выполнения. Цель этого сигнала — избежать параллельного выполнения тела актера и, таким образом, предоставить доступ к полям объекта актера без синхронизации.