Как Работают Популярные Машинные Переводчики Блокчейн
Как работают переводчики — системы искусственного интеллекта
В процессе собственной эволюции системы автоматического машинного перевода прошли несколько этапов. Первые полноценные системы, способные осуществлять перевод, работали на основе морфологии и синтаксиса (а также некоторой семантики) естественных языков. Подобны системы осуществляли полный разбор предложения на исходном языке, а затем из полученной информации выстраивали предложение на результирующем языке в соответствии с его морфологией и синтаксисом. Ресурсозатратность подобных систем затрудняло их массовое использование. Точность перевода также была не высока. Обучение системы каждому новому языку могло занимать годы и не давать результата. С развитием вычислительной техники и последующим появлением огромных объемов текстовых данных в электронном виде стало возможным создавать системы автоматического машинного перевода, работающие на языковых парах слов и словосочетаний. Пример англо-русской пары: . Такой подход позволял ставить в соответствие каждому слову или словосочетанию на исходном языке слово или словосочетание на результирующем языке, а затем из полученных элементов «склеивать» предложение. Сегодня такие системы известны под общим названием Phrase-Based Machine Translation (PBMT). Подобный подход преобладал в мире до тех пор, пока в компании Google не решили попробовать использовать нейросеть типа Seq2Seq для улучшения качества перевода. Так началась эпоха (с 2016-го г.) систем с общим наименованием Neural Machine Translation (NMT), о которых и пойдет речь.
Одним из наиболее существенных результатов технологий искусственного интеллекта являются системы автоматического перевода. Современные технологии машинного перевода функционируют на базе нейронных сетей типа Seq2Seq (от англ. Sequence-to-Sequence), обучаясь на огромных массивах данных с использованием мощных графических вычислителях.
Как выглядят обучающие данные
Как же выглядят данные для обучения нейросети? В качестве источника данных для обучения нейронных сетей типа Seq2Seq для машинного перевода используются двуязычные параллельные корпуса текстов. Данные корпуса представляют собой огромные массивы пар предложений, по одному на каждый язык. Примером является пара: «Меня зовут Алекс» — «My name is Alex».
Откуда берутся данные
Двуязычные параллельные корпуса текстов должны содержать миллионы таких пар. Откуда же берутся данные? Обычно параллельные корпуса текстов формируются вручную или автоматически благодаря статьям, книгам и их переводам. Однако, существует достаточно большое количество готовых параллельных корпусов текстов, в том числе и англо-русских.
В каком виде подаются данные на вход
Как же подать слово на вход нейронной сети? Отличительной особенностью современных технологий ИИ в задачах обработки текста является представление слова не в качестве набора знаков, а в виде векторного представления (от англ. Word Embedding). Обычно векторное представление слова является моделью его дистрибутивной семантики, формируемой на основе Skip-gram или CBOW нейросетей.
Архитектура нейросети Seq2Seq
Что собой представляет Seq2Seq нейросеть? Допустим, мы хотим научить нашу сеть переводить предложения с английского на русский язык. Тогда на вход нейронной сети поступают предложения на английском языке, а на выход — на русском. Поскольку каждое из предложений представляет собой последовательность (в нашем случае, последовательность слов), нейросеть Seq2Seq и получила свое название (дословно, «Последовательность в последовательность»). При обучении весовые коэффициенты связей сети корректируются таким образом, чтобы входная последовательность соответствовала выходной.
Промокоды на Займер на скидки

- ��Сумма: от 2 000 до 30 000 рублей
- ��Срок: от 7 до 30 дней
- ��Первый заём для новых клиентов — 0%, повторный — скидка 500 руб

Поскольку количество слов в каждом предложении различно, нейросеть Seq2Seq относится к классу рекуррентных сетей. Рекуррентными называют нейросети, данные на вход которой подаются последовательно, а выход предыдущей итерации используется при вычислении текущего выхода. Рекуррентные сети бывают статические и динамические. В статических максимальная размерность входной последовательности фиксирована и определяется наперед. В динамических она произвольна. Поскольку длина предложения может составлять от одного до нескольких десятков слов, удобно использовать динамические рекуррентные сети.
Рекуррентные нейросети позволяют отображать зависимость текущего элемента последовательности от предыдущих, однако, в большинстве естественных языков, текущий элемент зависит также и от последующих элементов. Разрешить данную проблему позволяют двунаправленные рекуррентные нейросети. Двунаправленная сеть представляет собой две рекуррентных подсети, первая из которых проходит входную последовательность слева-направо, а вторая — справа-налево. Выходные значения подсетей объединяются.
Перспективные технологии
Несмотря на значительные успехи, задача автоматического машинного перевода не считается полностью решенной, ведь точность перевода лучших систем существенно уступает качеству перевода человеком, особенно для языковых пар типа «английский-китайский», не говоря о языковых парах, для которых нет достаточного объема обучающих данных. Перспективы видятся в моделировании антропоморфных процессов осуществления переводов, иными словами, как перевод осуществляет сам человек, ведь он не обучается переводу на миллионах языковых пар. Таким образом, проблема автоматического машинного перевода с любого языка на любой кроется в проблема создание систем общего искусственного интеллекта, способной, в отличии от Seq2Seq, оперировать знаниями о реальном мире.
Системы RBMT анализируют текст и строят его перевод на базе встроенных словарей и набора грамматических правил для данной языковой пары. ПРОМТ и Systran — самые известные примеры RBMT-систем. Качество таких переводов оставляет желать лучшего, но они до сих пор используются (например, во всеми любимых переводах названий товаров на Aliexpress).
Затем лингвисты превращали набор фотографий в связный литературный текст: чтобы переводить тексты, и оператору, и лингвистам достаточно было знать только свой родной язык.
Системы машинного перевода
Затем лингвисты превращали набор фотографий в связный литературный текст чтобы переводить тексты, и оператору, и лингвистам достаточно было знать только свой родной язык.
Вряд ли среди нас есть хоть один человек, который бы ни разу не пользовался Яндекс- или Google-переводчиком. Однако далеко не все осознают, что эти сервисы есть не что иное, как . Давайте разберемся, что из себя представляет машинный перевод и как он появился.
В системах SMT применяется принцип статистического анализа в программу загружаются огромные объемы текстов на исходном языке и их переводы, выполненные человеком.
В системах SMT применяется принцип статистического анализа: в программу загружаются огромные объемы текстов на исходном языке и их переводы, выполненные человеком. Программа анализирует статистику межъязыковых соответствий, синтаксических конструкций и т. п., затем опирается на нее при выборе вариантов перевода — это и есть самообучение.
Например, вот перевод одного из абзацев из этой статьи: русский — английский — монгольский — венгерский — русский. Было так:
Почему Google Переводчик и аналоги работают неидеально: как устроены их алгоритмы
Количество ошибок в переводе зависит от многих факторов.
Перевод стал лучше, но все еще очень много ошибок. Нейросети не справляются?
Любой специалист по переводу скажет, что чем больше контекста или справочной информации, тем проще обрабатывать текст. Это легко проверить. Когда вы учите язык и начинаете на нем читать книги или смотреть фильмы, то часть слов понимаете просто из контекста. Почему раньше онлайн-переводчиками было невозможно пользоваться без смеха
Чтобы голосовать за варианты перевода и добавлять свои фразы, нажмите на кнопку Сообщество на главной странице Google Translate.
Результат получается близким к натуральным, но даже в такой короткой цепочке могут возникнуть ошибки из-за многозначных слов.
Другими словами, нейросети переводят не так, как надо, а так, как говорит человек. Пока известно только пять компаний, использующих такие гибридные системы: Google и Microsoft начали внедрять их в работу своих сервисов перевода с 2016 года,
Окей, Google! Когда машины заменят синхронных переводчиков
Пока известно только пять компаний, использующих такие гибридные системы Google и Microsoft начали внедрять их в работу своих сервисов перевода с 2016 года, .
Как работает нейронная сеть
Вот почему лингвисты и IT-специалисты так старательно учат искусственный интеллект синхронному переводу. Так как все-таки относиться к автоматизированным синхронным переводчикам?
Так как все-таки относиться к автоматизированным синхронным переводчикам.
Большинство программ машинного перевода до сих пор основано на синтезе этих двух подходов, например, так переводит сервис ПРОМТ. Оставалась какая-то мелочь – совместить эти разработки с программами анализа и синтеза речи, что и попытались сделать такие компании, как Google и Microsoft.
Мы научили машину выбирать лучший вариант»
Блеск и нищета машинного перевода
§ И это принципиально и никак не изменится от совершенствования технологий МТ. Любая такая технология работает только с исходным текстом. МТ не может заглянуть в иллюстрацию к научной статье по теме, чтобы понять, как надо переводить. Ничего понять он, кстати, тоже не может.
Как работает нейронный машинный перевод?
В этой публикации нашего цикла step-by-step статей мы объясним, как работает нейронный машинный перевод и сравним его с другими методами: технологией перевода на базе правил и технологией фреймового перевода (PBMT, наиболее популярным подмножеством которого является статистический машинный перевод — SMT).
Результаты исследования, полученные Neural Machine Translation, удивительны в части того, что касается расшифровки нейросети. Создается впечатление, что сеть на самом деле «понимает» предложение, когда переводит его. В этой статье мы разберем вопрос семантического подхода, который используют нейронные сети для перевода.
Давайте начнем с того, что рассмотрим методы работы всех трех технологий на различных этапах процесса перевода, а также методы, которые используются в каждом из случаев. Далее мы познакомимся с некоторыми примерами и сравним, что каждая из технологий делает для того, чтобы выдать максимально правильный перевод.
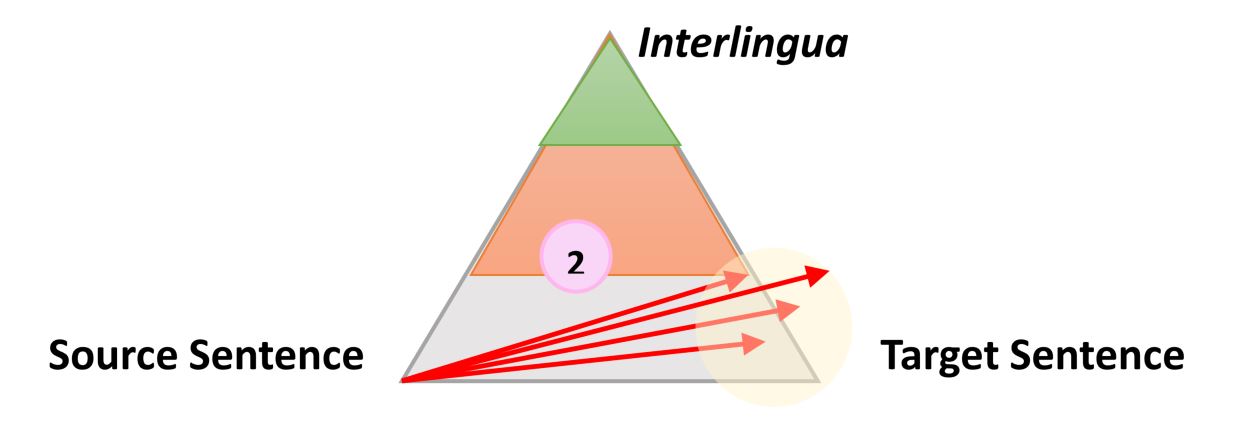
Очень простой, но все же полезной информацией о процессе любого типа автоматического перевода является следующий треугольник, который был сформулирован французским исследователем Бернардом Вокуа (Bernard Vauquois) в 1968 году:
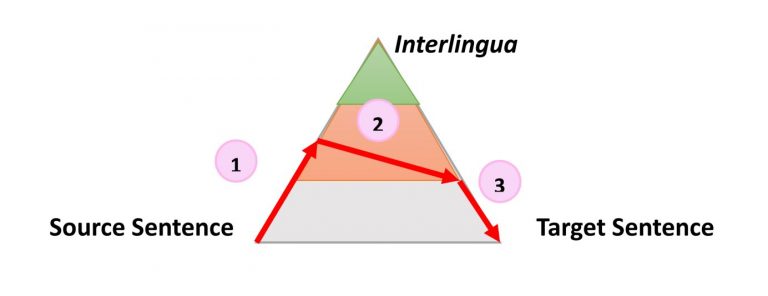
В этом треугольнике отображен процесс преобразования исходного предложения в целевое тремя разными путями.
Левая часть треугольника характеризует исходный язык, когда как правая — целевой. Разница в уровнях внутри треугольника представляет глубину процесса анализа исходного предложения, например синтаксического или семантического. Теперь мы знаем, что не можем отдельно проводить синтаксический или семантический анализ, но теория заключается в том, что мы можем углубиться на каждом из направлений. Первая красная стрелка обозначает анализ предложения на языке оригинала. Из данного нам предложения, которое является просто последовательностью слов, мы сможем получить представление о внутренней структуре и степени возможной глубины анализа.
Например, на одном уровне мы можем определить части речи каждого слова (существительное, глагол и т.д.), а на другом — взаимодействие между ними. Например, какое именно слово или фраза является подлежащим.
Когда анализ завершен, предложение «переносится» вторым процессом с равной или меньшей глубиной анализа на целевой язык. Затем третий процесс, называемый «генерацией», формирует фактическое целевое предложение из этой интерпретации, то есть создает последовательность слов на целевом языке. Идея использования треугольника заключается в том, что чем выше (глубже) вы анализируете исходное предложение, тем проще проходит фаза переноса. В конечном итоге, если бы мы могли преобразовать исходный язык в какой-то универсальный «интерлингвизм» во время этого анализа, нам вообще не нужно было бы выполнять процедуру переноса. Понадобился бы только анализатор и генератор для каждого переводимого языка на любой другой язык (прямой перевод прим. пер.)
Эта общая идея и объясняет промежуточные этапы, когда машина переводит предложения пошагово. Что еще более важно, эта модель описывает характер действий во время перевода. Давайте проиллюстрируем, как эта идея работает для трех разных технологий, используя в качестве примера предложение «The smart mouse plays violin» (Выбранное авторами публикации предложение содержит небольшой подвох, так как слово «Smart» в английском языке, кроме самого распространенного смысла «умный», имеет по словарю в качестве прилагательного еще 17 значений, например «проворный» или «ловкий» прим. пер.)
Машинный перевод на базе правил
Машинный перевод на базе правил является самым старым подходом и охватывает самые разные технологии. Однако, в основе всех их обычно лежат следующие постулаты:
- Процесс строго следует треугольнику Вокуа, анализ очень часто завышен, а процесс генерации сводится к минимальному;
- Все три этапа перевода используют базу данных правил и лексических элементов, на которые распространяются эти правила;
- Правила и лексические элементы заданы однозначно, но могут быть изменены лингвистом.
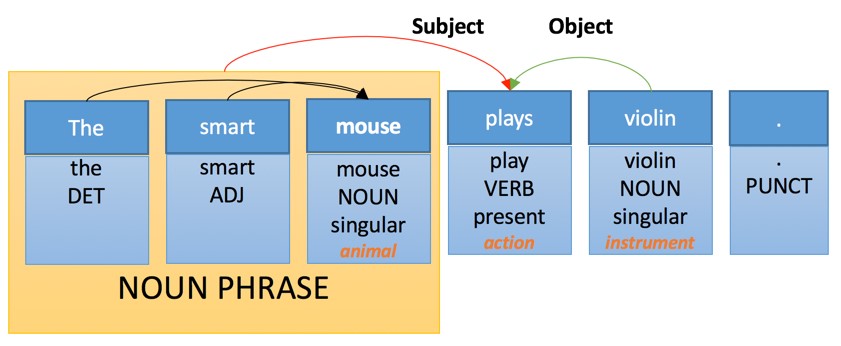
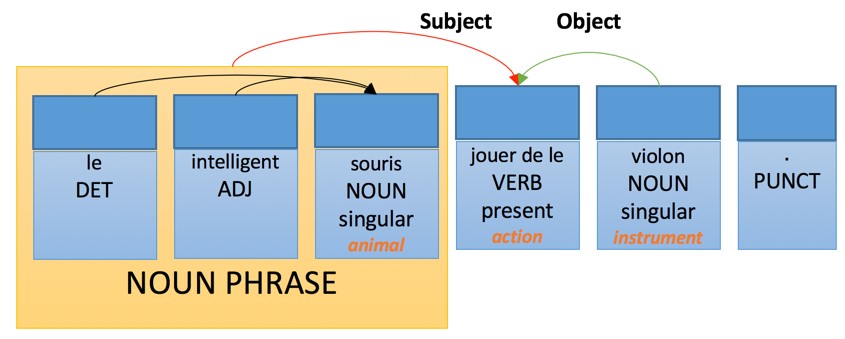
Тут мы видим несколько простых уровней анализа:
- Таргеритование частей речи. Каждому слову присваивается своя «часть речи», которая является грамматической категорией.
- Морфологический анализ: слово «plays» распознается как искажение от третьего лица и представляет форму глагола «Play».
- Семантический анализ: некоторым словам присваивается семантическая категория. Например, «Violin» — инструмент.
- Составной анализ: некоторые слова сгруппированы. «Smart mouse» — это существительное.
- Анализ зависимостей: слова и фразы связаны с «ссылками», при помощи которых происходит идентификация объекта и субъекта действия основного глагола «Plays».
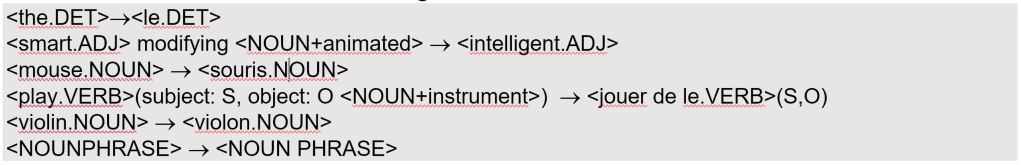
Применение этих правил приведет к следующей интерпретации на целевом языке перевода:
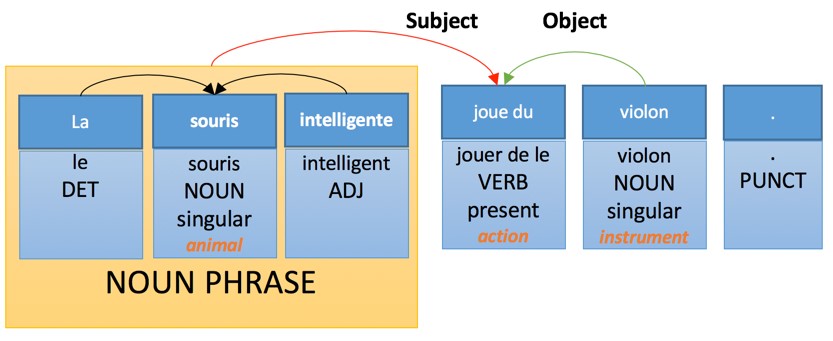
Тогда как правила генерации на французском будут иметь следующий вид:
- Прилагательное, выраженное словосочетанием, следует за существительным — с несколькими перечисленными исключениями.
- Определяющее слово согласованно по числу и роду с существительным, которое оно модифицирует.
- Прилагательное согласовано по числу и полу с существительным, которое оно модифицирует.
- Глагол согласован с подлежащим.
Машинный перевод на базе фраз
Машинный перевод на базе фраз — это самая простая и популярная версия статистического машинного перевода. Сегодня он по-прежнему является основной «рабочей лошадкой» и используется в крупных онлайн-сервисах по переводу.
Выражаясь технически, машинный перевод на базе фраз не следует процессу, сформулированному Вокуа. Мало того, в процессе этого типа машинного перевода не проводится никакого анализа или генерации, но, что более важно, придаточная часть не является детерминированной. Это означает, что технология может генерировать несколько разных переводов одного и того же предложения из одного и того же источника, а суть подхода заключается в выборе наилучшего варианта.
Эта модель перевода основана на трех базовых методах:
- Использование фразы-таблицы, которая дает варианты перевода и вероятность их употребления в этой последовательности на исходном языке.
- Таблица изменения порядка, которая указывает, как могут быть переставлены слова при переносе с исходного на целевой язык.
- Языковая модель, которая показывает вероятность для каждой возможной последовательности слов на целевом языке.
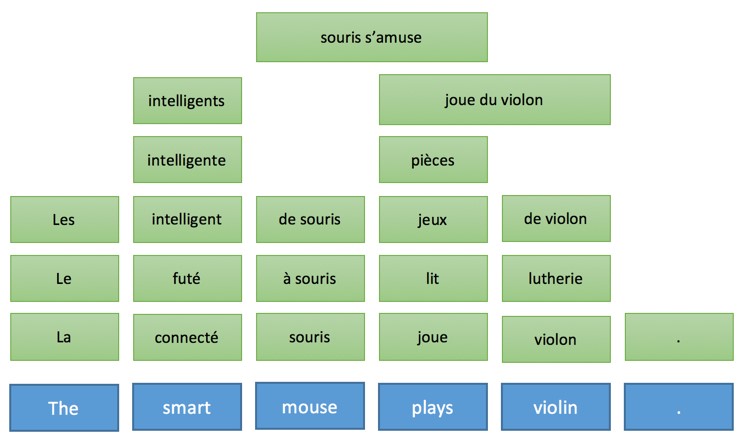
Далее из этой таблицы генерируются тысячи возможных вариантов перевода предложения, например:
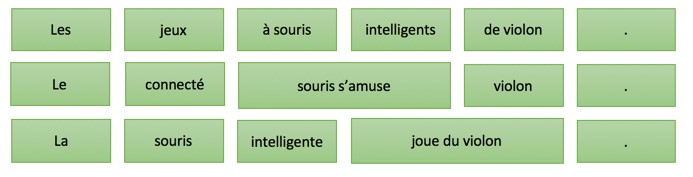
Однако благодаря интеллектуальным вычислениям вероятности и использованию более совершенных алгоритмов поиска, будет рассмотрен только наиболее вероятные варианты перевода, а лучший сохранится в качестве итогового.
В этом подходе целевая языковая модель крайне важна и мы можем получить представление о качестве результата, просто поискав в Интернете:
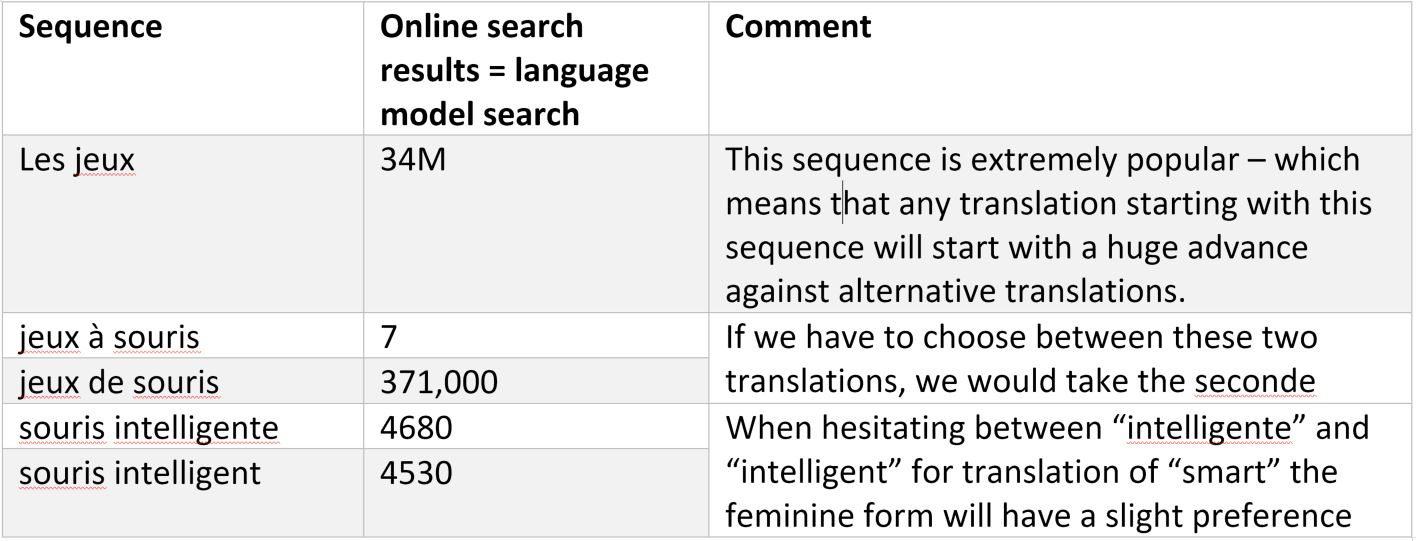
Поисковые алгоритмы интуитивно предпочитают использовать последовательности слов, которые являются наиболее вероятными переводами исходных с учетом таблицы изменения порядка. Это позволяет с высокой точностью генерировать правильную последовательность слов на целевом языке.
В этом подходе нет явного или неявного лингвистического или семантического анализа. Нам было предложено множество вариантов. Некоторые из них лучше, другие — хуже, но, на сколько нам известно, основные онлайн-сервисы перевода используют именно эту технологию.
Нейронный машинный перевод
Подход к организации нейронного машинного перевода кардинально отличается от предыдущего и, опираясь на треугольник Вокуа, его можно описать следующим образом:
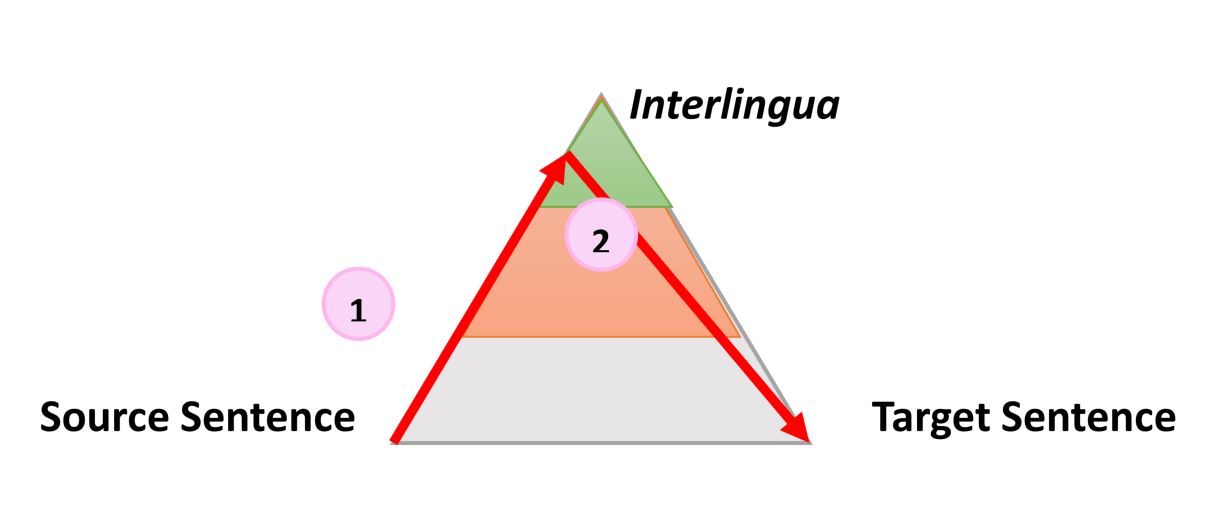
Нейронный машинный перевод имеет следующие особенности:
- «Анализ» называется кодированием, а его результатом является загадочная последовательность векторов.
- «Перенос» называется декодированием и непосредственно генерирует целевую форму без какой-либо фазы генерации. Это не строгое ограничение и, возможно, имеются вариации, но базовая технология работает именно так.
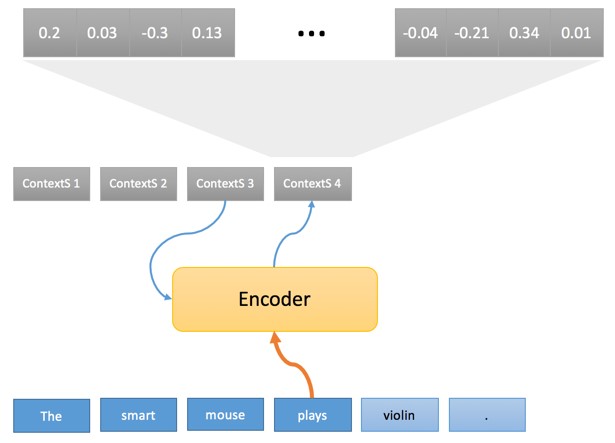
Последовательность исходных контекстов (ContextS 1,… ContextS 5) являет внутренней интерпретацией исходного предложения по треугольнику Вокуа и, как упоминалось выше, представляет из себя последовательность чисел с плавающей запятой (обычно 1000 чисел с плавающей запятой, связанных с каждым исходным словом). Пока мы не будем обсуждать, как кодировщик выполняет это преобразование, но хотелось бы отметить, что особенно любопытным является первоначальное преобразование слов в векторе «float».
На самом деле это технический блок, как и в случае с основанной на правилах системой перевода, где каждое слово сначала сравнивается со словарем, первым шагом кодера является поиск каждого исходного слова внутри таблицы.
Предположим, что вам нужно вообразить разные объекты с вариациями по форме и цвету в двумерном пространстве. При этом объекты, находящиеся ближе всего друг к другу должны быть похожи. Ниже приведен пример:
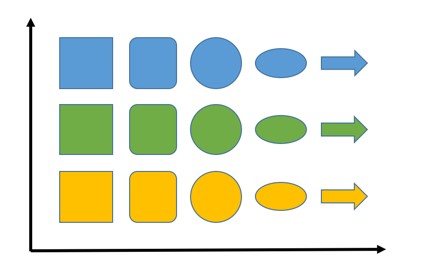
На оси абсцисс представлены фигуры и там мы стараемся поместить наиболее близкие по этому параметру объекты другой формы (нам нужно будет указать, что делает фигуры похожими, но в случае этого примера это кажется интуитивным). По оси ординат располагается цвет — зеленый между желтым и синим (расположено так, потому что зеленый является результатом смешения желтого и синего цветов, прим. пер.) Если бы у наших фигур были разные размеры, мы бы могли добавить этот третий параметр следующим образом:
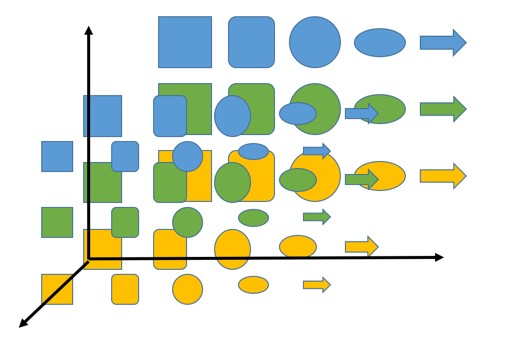
Если мы добавим больше цветов или фигур, мы также сможем увеличить и число измерений, чтобы любая точка могла представлять разные объекты и расстояние между ними, которое отражает степень их сходства.
Основная идея в том, что это работает и в случае размещения слов. Вместо фигур есть слова, пространство намного больше — например, мы используем 800 измерений, но идея заключается в том, что слова могут быть представлены в этих пространствах с теми же свойствами, что и фигуры.
Следовательно, слова, обладающие общими свойствами и признаками будут расположены близко друг к другу. Например, можно представить, что слова определенной части речи — это одно измерение, слова по признаку пола (если таковой имеется) — другое, может быть признак положительности или отрицательности значения и так далее.
Мы точно не знаем, как формируются эти вложения. В другой статье мы будем более подробно анализировать вложения, но сама идея также проста, как и организация фигур в пространстве.
Вернемся к процессу перевода. Второй шаг имеет следующий вид:
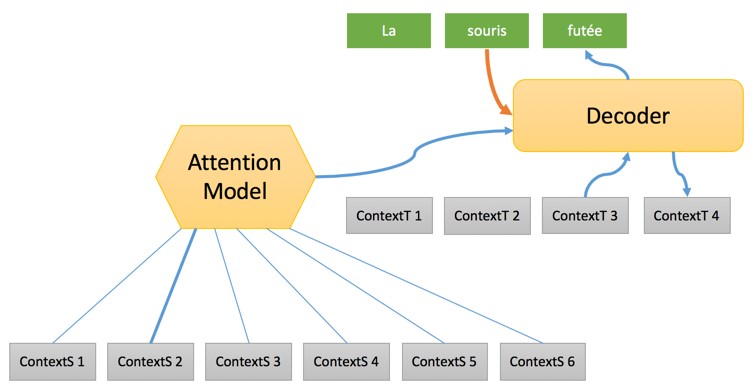
На этом этапе формируется полная последовательность с упором на «исходный контекст», после чего один за другим целевые слова генерируются с использованием:
- «Целевого контекста», сформированного в связке с предыдущим словом и предоставляющего некоторую информацию о состоянии процесса перевода.
- Значимости «контекстного источника», который представляет собой смесь различных «исходных контекстов» опираясь на конкретную модель под названием «Модель внимания» (Attention Model). Что это такое мы разберем в другой статье. Если кратко, то «Модели внимания» выбирают исходное слово для использование в переводе на любом этапе процесса.
- Ранее приведенного слова с использованием вложения слов для преобразования его в вектор, который будет обрабатываться декодером.
Весь процесс, несомненно, весьма загадочен и нам потребуется несколько публикаций, чтобы рассмотреть работу его отдельных частей. Главное, о чем следует помнить — это то, что операции процесса нейронного машинного перевода выстроены в той же последовательности, что и в случае машинного перевода на базе правил, однако характер операций и обработка объектов полностью отличается. И начинаются эти отличия с преобразования слов в векторы через их вложение в таблицы. Понимания этого момента достаточно для того, чтобы осознать, что происходит в следующих примерах.
Примеры перевода для сравнения
Давайте разберем некоторые примеры перевода и обсудим, как и почему некоторые из предложенных вариантов не работают в случае разных технологий. Мы выбрали несколько полисемических (т.е. многозначных, прим. пер.) глаголов английского языка и изучим их перевод на французский.
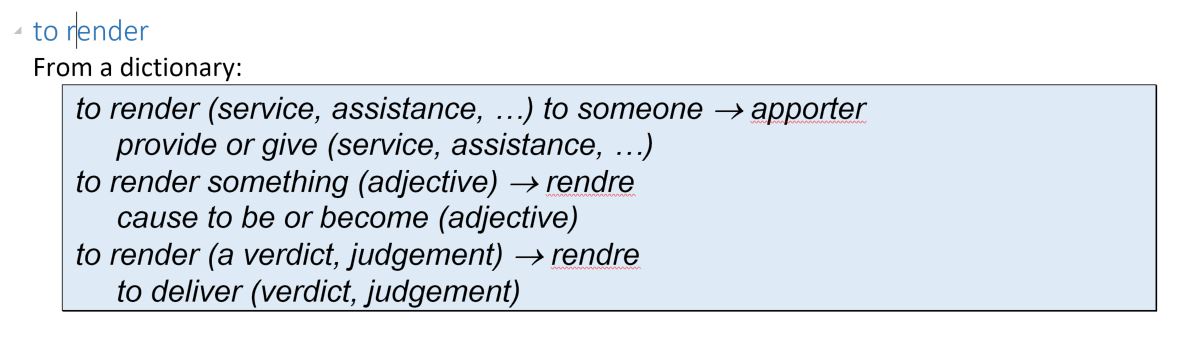
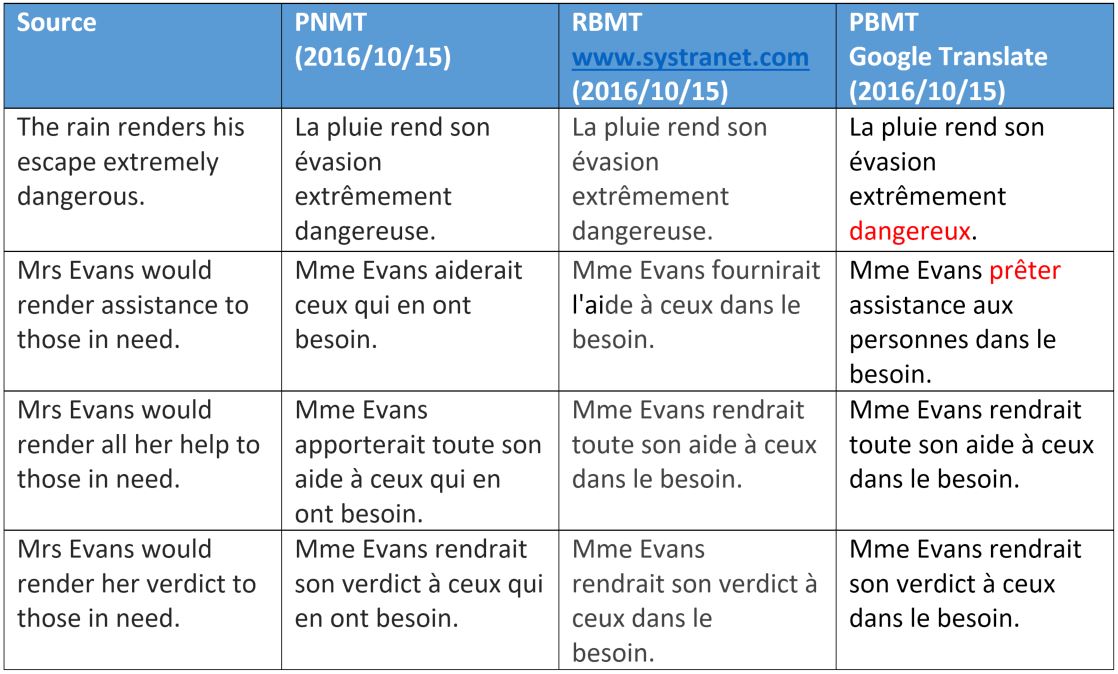
Мы видим, что машинный перевод на базе фраз, интерпретирует «render» как смысл — за исключением очень идиоматического варианта «оказание помощи». Это можно легко объяснить. Выбор значения зависит либо от проверки синтаксического значения структуре предложения, либо от семантической категории объекта.
Для нейронного машинного перевода видно, что слова «help» и «assistance» обрабатываются правильно, что показывает некоторое превосходство, а также очевидную способность этого метода получать синтаксические данные на большом расстоянии между словами, что мы более детально рассмотрим в другой публикации.
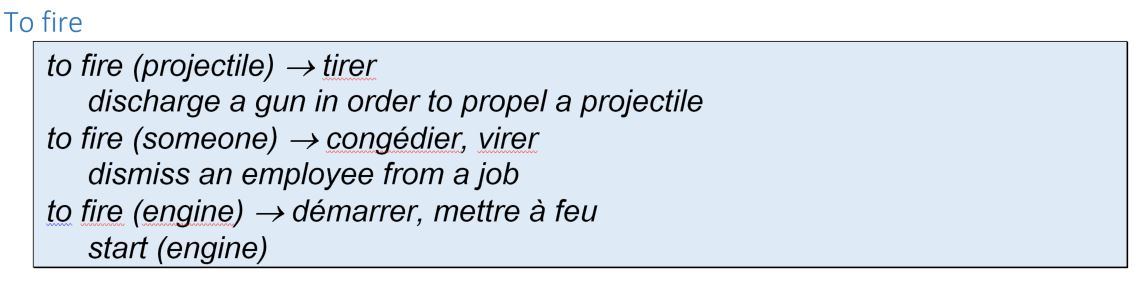
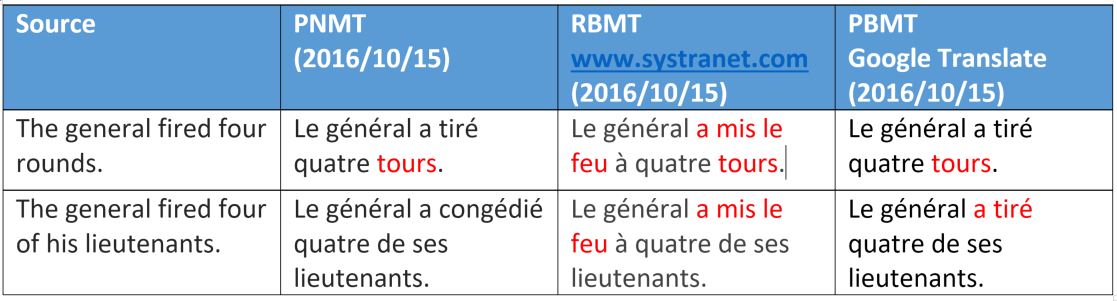
На этом примере опять видно, что нейронный машинный перевод имеет семантические различия с двумя другими способами (в основном они касаются одушевленности, обозначает слово человека или нет).
Однако отметим, что было неправильно переведено слово «rounds», которое в данном контексте имеет значение слова «bullet». Мы объясним этот типа интерпретации в другой статье, посвященной тренировке нейронных сетей. Что касается перевода на базе правил, то он распознал только третий смысл слова «rounds», который применяется в отношении ракет, а не пуль.
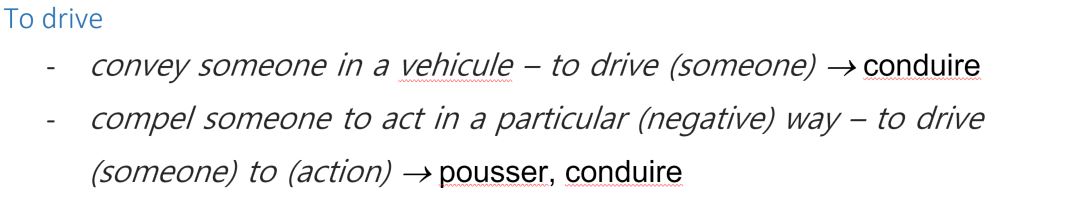
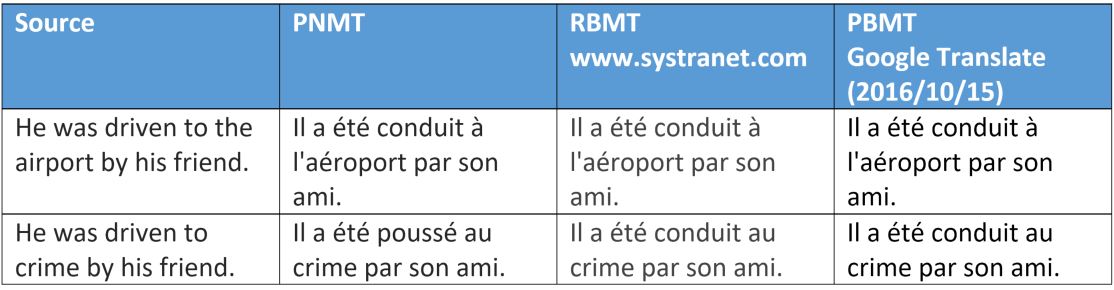
Выше еще один интересный пример того, как смысловые вариации глагола в ходе нейронного перевода взаимодействуют с объектом в случае однозначного употребления предлагаемого к переводу слова (crime или destination).
Другие варианты со словом «crime» показали тот же результат…
Переводчики работающие на базе слов и фраз так же не ошиблись, так как использовали те же глаголы, приемлемые в обоих контекстах.
Блокчейн и перевод: новая сфера и новые технологии

Блокчейн – это выстроенная по определённым правилам непрерывная последовательная цепочка блоков, содержащих информацию. Чаще всего копии цепочек блоков хранятся на множестве разных компьютеров независимо друг от друга.
Но при чем тут перевод?
Блокчейн – новая область для перевода
Перевод в сфере блокчейна, как и во всех других, имеет свои особенности. Он невозможен без знания принципов работы технологии и ее нюансов: основных терминов и понятий, аббревиатур, условных сокращений, криптожаргона и сленга. Если разобраться в этом не составит труда благодаря большому количеству справочников, то при переводе могут возникнуть сложности с подбором эквивалентов на русском языке, поскольку тематика относительно новая.
Сейчас чаще всего используются следующие виды переводов:
1. дословный перевод: wallet – кошелек, vanityaddress – адрес тщеславия, ringsignature – кольцевая подпись, smartcontract – умные контракты и др.
2. транслитерация: altcoin – альткойн, mining – майнинг, masternodes – мастерноды, fork – форк и др.
Аббревиатуры, сокращения, названия технологий/алгоритмов могут оставаться без перевода: ATH (AllTimeHigh — наибольшее значение за всё время, максимальный курс криптовалюты), Coinprizm (приложение (кошелек) и одноименная сеть для цифрового подтверждение прав собственности на произвольные объекты и работы с цветными монетами (Coloredcoins)), CryptoNote (протокол, обеспечивающий обфускацию (запутывание) транзакций с целью увеличения степени анонимности) и др.
При переводе текстов этой тематики может также помочь знание терминологии в области финансов и программирования, поскольку сфера блокчейна тесно с ними связана. Т.к. технологию блокчейна широко используют в финансовой и экономической сферах, а также на предприятиях с применением непрерывного производства, появляется спрос и на переводческие услуги.
Если говорить в общем, блокчейн сейчас активно развивается, создавая новую информацию в больших объемах, что повышает запрос на перевод.
Блокчейн не только для криптовалюты
Блокчейн представляет собой зашифрованную децентрализованную базу данных в безопасной среде. Она устойчива к изменению данных и обеспечивает максимальную защиту передаваемой информации.
Такая технология хранения и использования данных широко используется в области криптовалюты, и поэтому ассоциируется только с ней. Но блокчейн можно применять во многих сферах, в том числе в переводческой. Вопрос – для чего?
Ответ кроется в принципах работы технологии: для лингвистических услуг использование блокчейна может обеспечить более быстрые и защищенные платежи, а также создать более эффективную систему при работе с переводом и с операциями по обработке данных.
Кроме того, блокчейн способен повысить качество перевода: информация об исполнителях может представлять собой метаданные, и любые изменения, сделанные переводчиками, будут фиксироваться в системе распределенных данных. В этом случае информация о внесенных изменениях станет доступной и для менеджеров проекта и для клиента (носителей ключа). Расшифровав ее, можно будет получить информацию об источнике проблем с качеством и о квалификации исполнителя.
Также при помощи технологии можно решить вопросы производительности при обработке больших баз данных, т.к. для сохранения информации в «базе данных» блокчейна создается хеш исходного материала и основных метаданных проекта, таких как исполнитель, языковая пара, идентификатор клиента и т.д. Этот хеш является уникальным идентификатором проекта, поэтому нет необходимости сохранять весь исходный текст и переведенный текст.
И, наконец, блокчейн закрывает все вопросы, связанные с безопасностью и конфиденциальностью обрабатываемой информации.
На сегодняшний день все разработки имеют теоретический и экспериментальный характер. В 2019 г. CSA назвали технологии блокчейн «Future of translation industry». Насколько технология будет применена, каковы ее сильные и слабые стороны, покажет время.

Елизавета Иванова – R&D директор в компании ЭГО Транслейтинг, руководитель программных продуктов Ego Tech. Окончила СПбГУ по специальности лингвист, лексикограф. В переводческой отрасли с 1998 г. С 2006 г. занималась разработкой лексикографического направления в компании ЭГО Транслейтинг, а с 2015 г. там же возглавляла отдел технического развития.
Как работает нейросеть Google Translate
Google Translate по праву считается машинным переводчиком № 1 в мире. Сервис поддерживает работу со 103 языками и каждый день обрабатывает около 500 миллионов запросов.
В 2016 году Google представила систему нейронного машинного перевода (GNMT), которая использует искусственную нейронную сеть для улучшения качества перевода.
Действительно ли перевод стал лучше с её помощью? Давайте узнаем!
Тонкости нейронного перевода: как это работает
Нейронная модель машинного перевода использует иные принципы работы с текстом, чем стандартный статистический метод перевода.
Узнайте, что делают ваши конкуренты в Telegram с сервисом «Анализ конкурентов» MANGO OFFICE
Повышайте эффективность своего маркетинга и оптимизируйте затраты с сервисом анализа рекламных объявлений и органического трафика.
Вся информация о конкурентах собрана в одном окне: анализ сайтов на ключевые слова, рекламные объявления в РСЯ, объем трафика. Теперь и с аналитикой рекламы в Telegram!
Анализируйте рекламу конкурентов, собирайте их лучшие идеи и экономьте свои ресурсы.
До появления нейронных сетей перевод проводился пословно — система переводила отдельные слова и фразы с учётом грамматики. Поэтому при сложных оборотах или длинных предложениях качество перевода оставляло желать лучшего.
GNMT же переводит предложение целиком, учитывая контекст. Система не запоминает сотни вариантов перевода фраз — она оперирует семантикой текста.
При переводе предложение разбивается на словарные сегменты. Затем с помощью специальных декодеров система определяет «вес» каждого сегмента в тексте. Далее вычисляется максимально вероятные значения и перевод сегментов. Последний этап — соединить переведённые сегменты с учётом грамматики.
Отрывок из презентации GNMT, в котором показано, как нейронная сеть переводит предложение с китайского языка, разбивая его на смысловые сегменты
Как действует алгоритм переводчика
Чтобы понять принципы работы нейронного перевода от Google, давайте немного углубимся в технические детали.
В основе Google Neural Machine Translation лежит принцип работы рекуррентных двунаправленных нейронных сетей (Bidirectional Recurrent Neural Networks), работающих с матричными вычислениями вероятности.
Разберём подробнее, что всё это значит.
«Рекуррентный» говорит, что система вычисляет значение слова или фразы на основе предыдущих значений в последовательности. Именно это позволяет системе учитывать контекст и правильно выбирать среди разных вариантов перевода.
К примеру, в словосочетании «лук из красного дерева» слово «лук» система переведёт как «bow», а не «onion».
Двунаправленность означает, что нейросеть разделена на два потока — анализирующий и синтезирующий. Каждый поток состоит из восьми слоёв, которые и проводят векторный анализ.
Первый поток разбивает предложение на смысловые элементы и анализирует их, а второй высчитывает наиболее вероятный вариант перевода, исходя из контекста и модулей внимания.

Обратите внимание, что анализирующая сеть «читает» предложение не только слева направо, но и справа налево — это позволяет в полной мере понять контекст. Отдельно она формирует модуль внимания, с помощью которого второй поток понимает ценность отдельных смысловых фрагментов.
В нейронной системе наименьшим элементом является не слово, а фрагменты слова. Это позволяет сосредоточить вычислительные мощности не на словоформах, а на контексте и смыслах предложения. GNMT использует около 32 000 таких фрагментов. По словам разработчиков, это позволяет обеспечить высокую скорость и точность перевода без потребления чрезмерных вычислительных мощностей.
Анализ фрагментов сильно уменьшает риски неточного перевода слов и словосочетаний с различными суффиксами, префиксами и окончаниями.
Система самообучения позволяет нейронной сети с высокой точностью переводить даже те понятия, которые отсутствуют в общепринятых словарях — сленг, жаргонизмы или неологизмы.
Но это ещё не всё. Нейросеть может работать и побуквенно. К примеру, при транслитерации имен собственных с одного алфавита на другой.
Статистика: действительно ли стало лучше?
С момента запуска системы GNMT прошло 2 года, поэтому можно оценить результаты.
Почему именно сейчас? Дело в том, что нейронная система работает без установленной базы данных, и ей требуется время, чтобы построить и скорректировать методы перевода.
К примеру, настройка машинной модели перевода, которая использует статистические методы, занимает от 1 до 3 дней. При этом построение нейронной модели такого же размера займёт больше 3 недель.
Примечательно, что при увеличении базы время на обработку статистической модели растёт в арифметической прогрессии, а для нейронной сети — в геометрической. Чем больше база, тем больше разрыв во времени.
А если учесть, что Google Translate работает с 10 000 языковых пар (103 языка), то понятно, что адекватные итоги можно подводить только сейчас.
В ноябре 2016 года после полного окончания обучения системы и официального запуска аналитики Google представили подробный анализ результатов GNMT. Из него следует, что улучшения в точности перевода несущественные — в среднем 10%.
Наибольший прирост дали самые популярные языковые пары вроде испанский-английский или французский-английский — с результатом точности в 85–87%.
В 2017 компания Google проводила масштабные опросы пользователей Google Translate: их просили оценить 3 варианта переводов: машинный статистический, нейронный и человеческий. Здесь результаты оказались более интересными. Перевод с помощью нейросетей в некоторых языковых парах оказался очень приближён к человеческому.
| Статистическая модель | Нейронная сеть | Человеческий перевод | |||
|---|---|---|---|---|---|
| Английский — Испанский | 4,885 | 5,428 | 5,550 | ||
| Английский — Французский | 4,932 | 5,295 | 5,496 | ||
| Английский — Китайский | 4,035 | 4,594 | 4,987 | ||
| Испанский — Английский | 4,872 | 5,187 | 5,372 | ||
| Французский — Английский | 5,046 | 5,343 | 5,404 | ||
| Китайский — Английский | 3,694 | 4,263 | 4,636 |
За основу взята 6-балльная система оценивания качества перевода. 6 — максимальная оценка, 0 — минимальная
Как видите, качество перевода в языковых парах «английский-испанский» и «французский-английский» практически соответствует человеческому. Но это и не странно, ведь именно на этих языковых парах происходило глубокое обучение алгоритмов.
Вот те же результаты в графическом отображении, чтобы вы наглядно увидели разницу со стандартным машинным переводом.

С другими языковыми парами ситуация не такая радужная, но масштабного исследования по ним нет. Тем не менее, если со схожими по структуре языками нейронный перевод работает вполне хорошо, то с кардинально разными языковыми системами (например, японский и русский) перевод заметно уступает человеческому.
При этом стоит заметить, что разработчики при запуске нейронной сети не пытались достичь максимальной точности перевода. Всё потому, что он потребовал бы сложных эвристических конструкций, а это сильно снизило бы скорость работы системы. Разработчики постарались найти баланс между точностью и скоростью работы. На наше субъективное мнение, это у них получилось.
И небольшой бонус напоследок
Специалисты утверждают, что если нейронная система Google Translate научится оперировать не только текстами, но также и аудио- и видеофайлами, то в таком случае нужно ожидать резкий скачок в развитии машинного перевода. Первые шаги в этих сферах уже сделаны, активно ведутся разработки новых алгоритмов для анализа видео и аудио. Поэтому пользователи могут уже в ближайшие несколько лет ожидать новых сюрпризов от Google.