Датацентрический и моделецентрический подходы в машинном обучении
Код и данные — фундамент ИИ-системы. Оба эти компонента играют важную роль в разработке надёжной модели, но на каком из них следует сосредоточиться больше? В этой статье мы сравним методики, ставящие в центр данные, либо модель, и посмотрим, какая из них лучше; также мы поговорим о том, как внедрять датацентрическую инфраструктуру.
При моделецентрической методике выполняются экспериментальные исследования для повышения качества модели ML. Из широкого спектра возможностей выбираются наилучшая архитектура модели и процесс обучения.
• При таком подходе данные остаются неизменными, совершенствуется код или архитектура модели.
• Работа над кодом — основная цель этой методики.
На сегодняшний день большинство ИИ-приложений моделецентричны; вероятно, причина этого заключается в том, что сектор разработки ИИ внимательно следит за научными исследованиями моделей. По словам Эндрю Ына, более 90% исследовательских статей в этой предметной области моделецентрично, потому что сложно создать крупные массивы данных, которые могут стать общепринятыми стандартами. Из-за этого сообщество разработчиков ИИ полагает, что моделецентичное машинное обучение более перспективно. Основное внимание уделяется коду, а данные зачастую игнорируются и сбор данных считается единоразовым событием.
В эпоху, когда данные являются основой любого процесса принятия решений, датацентрическая (data-centric) компания может лучше соотносить свою стратегию с интересами партнёров, используя информацию, сгенерированную по итогам их работы. Благодаря этому результаты могут быть более точными, упорядоченными и прозрачными, что позволяет организации функционировать стабильнее.
• При таком подходе массивы данных систематически изменяются/совершенствуются для повышения точности ML-приложений.
• Работа над данными — основная цель такой методики.
Многие люди часто путают методики data-centric и data-driven. Подход data-driven — это методология сбора, анализа и понимания данных. Иногда его называют «аналитикой». Подход data-centric сосредоточен на использовании данных для определения того, что вообще нужно создавать.
• Датацентрическая архитектура — это система, в которой данные являются основным и неотъемлемым ресурсом, а способы их использования меняются.
• Data-driven-архитектура — это создание технологий, навыков и среды при помощи переработки больших объёмов данных.
Давайте теперь поговорим о том, как датацентрический подход отличается от моделецентрического и о том, зачем он вообще нужен.
Дата-саентистам и инженерам машинного обучения моделецентрический подход может казаться более удобным. Это понятно, ведь практические специалисты могут использовать свои знания для решения конкретной задачи. С другой стороны, никто не захочет тратить весь день на разметку данных, потому что это считается скучной работой.
В современном машинном обучении данные критически важны, однако разработчики ИИ их часто игнорируют или относятся к ним неправильно. В результате этого сотни часов тратятся на настройку модели на основе ошибочных данных. Это вполне может быть фундаментальной причиной низкой точности вашей модели, и это никак не связано с оптимизацией модели.
Необязательно полностью переходить на датацентрический подход, иногда важно сосредоточиться на модели и коде. Стоит проводить исследования и совершенствовать модели, но и данные тоже важны. Мы склонны не замечать важность данных и основное внимание уделяем модели. Лучше всего использовать гибридный подход, учитывающий и данные, и модель. В зависимости от способа использования можно уделять больше внимания данным и меньше модели, но учитывать обязательно нужно оба аспекта.
Моделецентрическое ML — это системы машинного обучения, в основном делающие упор на оптимизацию архитектур моделей и их параметров.
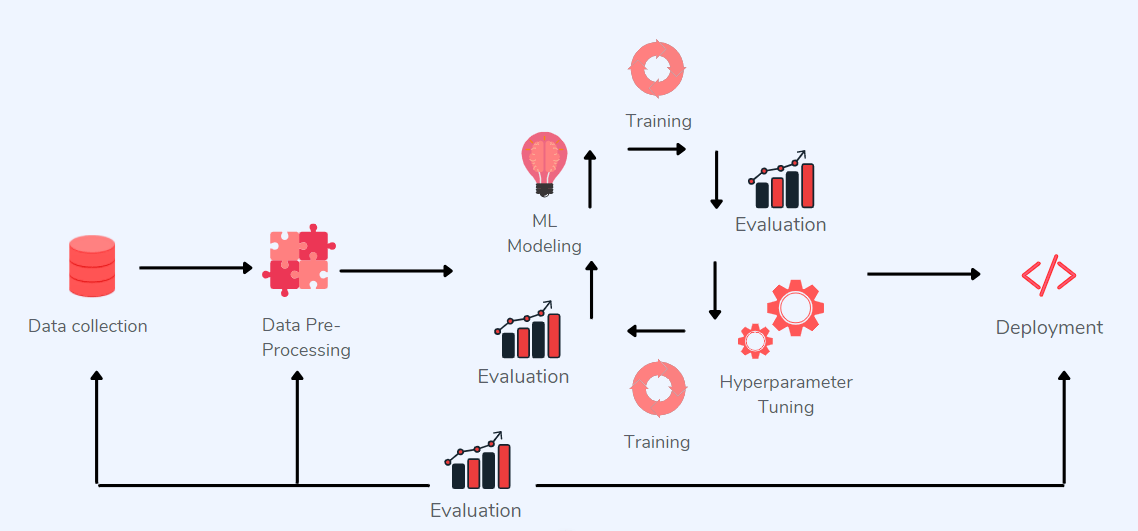
Показанный на рисунке выше моделецентрический процесс подходит для некоторых отраслей, в частности, медиа и рекламного бизнеса, но ситуация меняется, когда дело касается здравоохранения или производства. В них можно столкнуться со следующими трудностями:
1.Потребность в высокоуровневой кастомизации
В отличие от медиа и рекламного бизнеса, производитель множества разных товаров не может использовать одну систему машинного обучения для распознавания брака во всём ассортименте продукции. Каждый изготавливаемый продукт требует отдельно обученной модели ML.
Медиа-компании могут позволить себе иметь свой собственный отдел ML, работающий над каждой задачей оптимизации, однако производственный бизнес, требующий множества ML-решений, не может пойти по тому же пути.
2.Важность больших массивов данных
В большинстве случаев у компаний нет большого количества размечанных данных, с которыми можно работать. Часто они вынуждены иметь дело с крошечными массивами данных, которые при моделецентрическом подходе обеспечивают неудовлетворительные результаты.
Эндрю Ын считает, что датацентрическое ML даёт бОльшую отдачу и продвигает идею революции в сообществе в сторону датацентричности. Он приводит пример задачи обнаружения дефектов в стали, в котором моделецентрическая методика не смогла повысить точность модели, а датацентрическая методика увеличила точность на 16%.
Данные чрезвычайно важны в исследованиях ИИ, а внедрение стратегии, отдающей приоритет получению высококачественных данных, критически необходимо — в конечном итоге, релевантные данные не только редки и шумны, но и процесс их получения очень дорог. Принцип заключается в том, что с ИИ нужно обращаться так же, как при подборе качественных материалов при строительстве дома. Данные нужно оценивать на каждом уровне, а не выбирать их один раз.
При реализации датацентрической архитектуры данные необходимо рассматривать как фундаментальный ресурс, срок жизни которого будет больше, чем у приложений и инфраструктуры. При таком подходе требуется не единая база данных или репозиторий данных, а общее понимание данных и их единообразное описание. Датацентрическое ML упрощает обмен данными и их перемещение.
Так что же включает в себя датацентрическое машинное обучение? Какие существенные факторы следует учитывать при реализации датацентрического подхода?
1.Качество разметки данных
Разметка данных — это процесс присвоения данным одной или нескольких меток. Метки ассоциируются с конкретными значениями, присваиваемыми данным. Если неверно размечено существенное количество изображений, то результаты будут хуже, чем при использовании меньшего количества более точных данных.
В метках содержится подробная информация о содержимом и структуре массива данных, которая может включать в себя такие компоненты, как перечень типов данных, единиц измерения и временных интервалов, представленных в массиве. Наилучшим способом повышения качества данных является поиск несоответствий в метках и работа над инструкциями по разметке. Ниже мы подробнее расскажем о важности качества данных.
2.Аугментация данных
Аугментация данных — это задача анализа данных, включающая в себя создание обучающих примеров при помощи интерполяции, экстраполяции и других средств. Её можно использовать для добавления дополнительных данных обучения для ML или для создания синтетических изображений/кадров видео с различной степенью реализма. Она помогает увеличить количество релевантных данных, например, количества бракованных изделий, создавая данные, которые ваша модель в процессе обучения пока не видела.
Однако добавление данных не всегда является наилучшим вариантом. Устранение шумных данных, приводящих к высокой дисперсии, улучшает способность модели обобщать новые данные.
3.Конструирование признаков
Конструирование признаков (feature engineering) — процесс добавления в модель признаков при помощи изменения входящих данных, предшествующих знаний или алгоритмов. Оно используется в машинном обучении для повышения точности прогнозирующей модели.
Повышение качества данных включает в себя улучшение и входящих данных, и целевых/меток. Конструирование признаков критически важно для добавления признаков, которые могут и не существовать в «сыром» виде, но способны внести существенный вклад в обучение модели.
4.Контроль версий данных
В любом программном приложении важную роль играет контроль версий данных. Разработчикам необходимо устранять ошибки, сравнивая две версии и выявляя аспекты, которые больше не имеют ценности. Или же разработчики могут предотвратить появление бага, повторно внедрив конкретную версию данных. Управление доступом к массивам данных, а также к различным версиям каждого массива данных — это сложная и не защищённая от ошибок задача. Контроль версий данных — один из самых важных этапов в управлении данными, именно он позволяет отслеживать изменения (и добавление, и удаление) в массиве данных. Контроль версий упрощает совместную работу над кодом и управление массивами данных.
Также контроль версий упрощает управление конвейером ML от proof of concept до продакшена, на этом этапе на помощь приходят инструменты MLOps. Вы можете задаться вопросом, почему инструменты MLOps обсуждаются в контексте контроля версий данных? Потому что управление конвейерами данных — очень сложная задача в разработке приложений машинного обучения. Контроль версий обеспечивает воспроизводимость и надёжность. Вот лучшие платформы для контроля версий данных:
Neptune — это хранилище метаданных для MLOps, разработанное для исследовательских и производственных групп. Оно создаёт общий центральный хаб для журналирования, хранения, отображения, упорядочивания, сравнения и запрашивания всех метаданных, сгенерированных на протяжении жизненного цикла машинного обучения. В контексте контроля версий данных при помощи Neptune можно выполнять следующие операции:
• Отслеживать версию массива данных в прогонах машинного обучения при помощи артефактов.
• Запрашивать версию массива данных из предыдущих прогонов, чтобы гарантировать, что вы выполняете обучение на одной версии массива данных.
Датацентрический и моделецентрический подходы в машинном обучении
При моделецентрической методике выполняются экспериментальные исследования для повышения качества модели ML. Из широкого спектра возможностей выбираются наилучшая архитектура модели и процесс обучения.
- При таком подходе данные остаются неизменными, совершенствуется код или архитектура модели.
- Работа над кодом — основная цель этой методики.
Моделецентрические тенденции в мире ИИ
На сегодняшний день большинство ИИ-приложений моделецентричны; вероятно, причина этого заключается в том, что сектор разработки ИИ внимательно следит за научными исследованиями моделей. По словам Эндрю Ына, более 90% исследовательских статей в этой предметной области моделецентрично, потому что сложно создать крупные массивы данных, которые могут стать общепринятыми стандартами. Из-за этого сообщество разработчиков ИИ полагает, что моделецентичное машинное обучение более перспективно. Основное внимание уделяется коду, а данные зачастую игнорируются и сбор данных считается единоразовым событием.
Датацентрическая методика
В эпоху, когда данные являются основой любого процесса принятия решений, датацентрическая (data-centric) компания может лучше соотносить свою стратегию с интересами партнёров, используя информацию, сгенерированную по итогам их работы. Благодаря этому результаты могут быть более точными, упорядоченными и прозрачными, что позволяет организации функционировать стабильнее.
- При таком подходе массивы данных систематически изменяются/совершенствуются для повышения точности ML-приложений.
- Работа над данными — основная цель такой методики.
Различия между data-driven и data-centric

Data-driven и data-centric
Многие люди часто путают методики data-centric и data-driven. Подход data-driven — это методология сбора, анализа и понимания данных. Иногда его называют «аналитикой». Подход data-centric сосредоточен на использовании данных для определения того, что вообще нужно создавать.
- Датацентрическая архитектура — это система, в которой данные являются основным и неотъемлемым ресурсом, а способы их использования меняются.
- Data-driven-архитектура — это создание технологий, навыков и среды при помощи переработки больших объёмов данных.
Датацентрический и моделецентрический подходы
Дата-саентистам и инженерам машинного обучения моделецентрический подход может казаться более удобным. Это понятно, ведь практические специалисты могут использовать свои знания для решения конкретной задачи. С другой стороны, никто не захочет тратить весь день на разметку данных, потому что это считается скучной работой.
В современном машинном обучении данные критически важны, однако разработчики ИИ их часто игнорируют или относятся к ним неправильно. В результате этого сотни часов тратятся на настройку модели на основе ошибочных данных. Это вполне может быть фундаментальной причиной низкой точности вашей модели, и это никак не связано с оптимизацией модели.
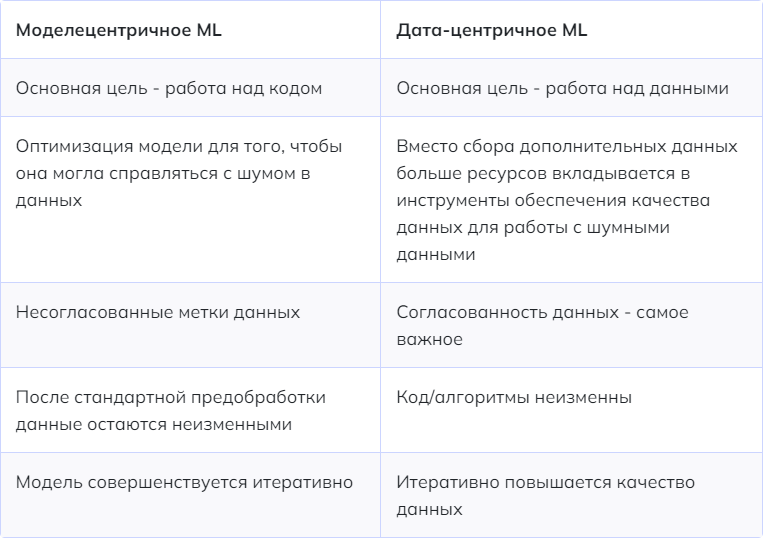
Необязательно полностью переходить на датацентрический подход, иногда важно сосредоточиться на модели и коде. Стоит проводить исследования и совершенствовать модели, но и данные тоже важны. Мы склонны не замечать важность данных и основное внимание уделяем модели. Лучше всего использовать гибридный подход, учитывающий и данные, и модель. В зависимости от способа использования можно уделять больше внимания данным и меньше модели, но учитывать обязательно нужно оба аспекта.
Потребность в датацентрической архитектуре
Моделецентрическое ML — это системы машинного обучения, в основном делающие упор на оптимизацию архитектур моделей и их параметров.

Моделецентрическое применение ML
Показанный на рисунке выше моделецентрический процесс подходит для некоторых отраслей, в частности, медиа и рекламного бизнеса, но ситуация меняется, когда дело касается здравоохранения или производства. В них можно столкнуться со следующими трудностями:
1. Потребность в высокоуровневой кастомизации
В отличие от медиа и рекламного бизнеса, производитель множества разных товаров не может использовать одну систему машинного обучения для распознавания брака во всём ассортименте продукции. Каждый изготавливаемый продукт требует отдельно обученной модели ML.
Медиа-компании могут позволить себе иметь свой собственный отдел ML, работающий над каждой задачей оптимизации, однако производственный бизнес, требующий множества ML-решений, не может пойти по тому же пути.
2. Важность больших массивов данных
В большинстве случаев у компаний нет большого количества размечанных данных, с которыми можно работать. Часто они вынуждены иметь дело с крошечными массивами данных, которые при моделецентрическом подходе обеспечивают неудовлетворительные результаты.
Эндрю Ын считает, что датацентрическое ML даёт бОльшую отдачу и продвигает идею революции в сообществе в сторону датацентричности. Он приводит пример задачи обнаружения дефектов в стали, в котором моделецентрическая методика не смогла повысить точность модели, а датацентрическая методика увеличила точность на 16%.
Данные чрезвычайно важны в исследованиях ИИ, а внедрение стратегии, отдающей приоритет получению высококачественных данных, критически необходимо — в конечном итоге, релевантные данные не только редки и шумны, но и процесс их получения очень дорог. Принцип заключается в том, что с ИИ нужно обращаться так же, как при подборе качественных материалов при строительстве дома. Данные нужно оценивать на каждом уровне, а не выбирать их один раз.
Датацентрический способ применения ML
Внедрение датацентрической инфраструктуры
При реализации датацентрической архитектуры данные необходимо рассматривать как фундаментальный ресурс, срок жизни которого будет больше, чем у приложений и инфраструктуры. При таком подходе требуется не единая база данных или репозиторий данных, а общее понимание данных и их единообразное описание. Датацентрическое ML упрощает обмен данными и их перемещение.
Так что же включает в себя датацентрическое машинное обучение? Какие существенные факторы следует учитывать при реализации датацентрического подхода?
1. Качество разметки данных
Разметка данных — это процесс присвоения данным одной или нескольких меток. Метки ассоциируются с конкретными значениями, присваиваемыми данным. Если неверно размечено существенное количество изображений, то результаты будут хуже, чем при использовании меньшего количества более точных данных.
В метках содержится подробная информация о содержимом и структуре массива данных, которая может включать в себя такие компоненты, как перечень типов данных, единиц измерения и временных интервалов, представленных в массиве. Наилучшим способом повышения качества данных является поиск несоответствий в метках и работа над инструкциями по разметке. Ниже мы подробнее расскажем о важности качества данных.
2. Аугментация данных
Аугментация данных — это задача анализа данных, включающая в себя создание обучающих примеров при помощи интерполяции, экстраполяции и других средств. Её можно использовать для добавления дополнительных данных обучения для ML или для создания синтетических изображений/кадров видео с различной степенью реализма. Она помогает увеличить количество релевантных данных, например, количества бракованных изделий, создавая данные, которые ваша модель в процессе обучения пока не видела.
Однако добавление данных не всегда является наилучшим вариантом. Устранение шумных данных, приводящих к высокой дисперсии, улучшает способность модели обобщать новые данные.
3. Конструирование признаков
Конструирование признаков (feature engineering) — процесс добавления в модель признаков при помощи изменения входящих данных, предшествующих знаний или алгоритмов. Оно используется в машинном обучении для повышения точности прогнозирующей модели.
Повышение качества данных включает в себя улучшение и входящих данных, и целевых/меток. Конструирование признаков критически важно для добавления признаков, которые могут и не существовать в «сыром» виде, но способны внести существенный вклад в обучение модели.
4. Контроль версий данных
В любом программном приложении важную роль играет контроль версий данных. Разработчикам необходимо устранять ошибки, сравнивая две версии и выявляя аспекты, которые больше не имеют ценности. Или же разработчики могут предотвратить появление бага, повторно внедрив конкретную версию данных. Управление доступом к массивам данных, а также к различным версиям каждого массива данных — это сложная и не защищённая от ошибок задача. Контроль версий данных — один из самых важных этапов в управлении данными, именно он позволяет отслеживать изменения (и добавление, и удаление) в массиве данных. Контроль версий упрощает совместную работу над кодом и управление массивами данных.
Также контроль версий упрощает управление конвейером ML от proof of concept до продакшена, на этом этапе на помощь приходят инструменты MLOps. Вы можете задаться вопросом, почему инструменты MLOps обсуждаются в контексте контроля версий данных? Потому что управление конвейерами данных — очень сложная задача в разработке приложений машинного обучения. Контроль версий обеспечивает воспроизводимость и надёжность. Вот лучшие платформы для контроля версий данных:
а) Neptune
Neptune — это хранилище метаданных для MLOps, разработанное для исследовательских и производственных групп. Оно создаёт общий центральный хаб для журналирования, хранения, отображения, упорядочивания, сравнения и запрашивания всех метаданных, сгенерированных на протяжении жизненного цикла машинного обучения. В контексте контроля версий данных при помощи Neptune можно выполнять следующие операции:
- Отслеживать версию массива данных в прогонах машинного обучения при помощи артефактов.
- Запрашивать версию массива данных из предыдущих прогонов, чтобы гарантировать, что вы выполняете обучение на одной версии массива данных.
- Упорядочивать метаданные версий массивов данных в Neptune UI.

Чтобы узнать больше о контроле версий данных в Neptune, см. примеры кода.
б) Weights & Biases
Weights & Biases (WandB) — это платформа, предоставляющая инструменты машинного обучения исследователям и командам, занимающимся глубоким обучением. WandB помогает в контроле экспериментов, контроле версий массивов данных и управлении моделями. При помощи WandB можно выполнять следующие операции:
- Использовать артефакты для контроля версий массивов данных и моделей, а также для отслеживания зависимостей и результатов в конвейерах машинного обучения.
- Хранить полные массивы данных непосредственно в артефактах или использовать ссылки на артефакты для указания на данные в других системах наподобие S3, GCP, или на локальной машине.
в) Data Version Control (DVC)
DVC — это open-source-платформа для проектов машинного обучения. DVC помогает дата-саентистам и разработчикам в контроле версий данных, управлении рабочим процессом и экспериментами. DVC позволяет выполнять следующие операции:
- Записывать версии данных и моделей в коммиты Git, параллельно с хранением их на машинах пользователей или в облачном хранилище.
- Переключаться между различным содержимым данных.
- Создавать метафайлы с описанием того, какие массивы данных и артефакты ML нужно отслеживать.
5. Знание предметной области
При датацентрическом подходе чрезвычайную ценность имеет знание предметной области. Специалисты в предметной области часто способны выявлять мелкие несоответствия, незаметные для инженеров ML, дата-саентистов или разметчиков. Труд специалистов в предметной области по-прежнему не используется в ML-системе. Производительность ML-систем можно улучшить, использовав дополнительные знания предметной области.
Преимущества датацентрического подхода
Переход к датацентрическим методикам имеет множество преимуществ, от повышения скорости и точности до более осознанного принятия решений. Датацентрическая инфраструктура обладает следующими преимуществами:
- Повышает точность; использование данных в качестве стратегического ресурса гарантирует более точные оценки, наблюдения и решения.
- Устраняет необходимость сложных преобразований данных.
- Уменьшает количество ошибок и несоответствий в данных.
- Предоставляет важную информацию о внутренних и внешних трендах, позволяющую принимать более оптимальные решения.
- Снижает расходы.
- Упрощает доступ к данным для руководства.
- Снижает избыточность данных.
- Повышает качество и надёжность данных.
Чему отдавать приоритет: количеству или качеству данных?
Прежде чем двигаться дальше, нам стоит подчеркнуть, что увеличение количества данных не означает автоматически повышение их качества. Разумеется, нейросеть невозможно обучить на малом количестве изображений, но упор нужно делать на качество, а не на количество.
Количество данных
Под этим понятием подразумевается объём доступных данных. Основная задача — собрать максимально возможное количество данных, а затем обучить нейросеть.
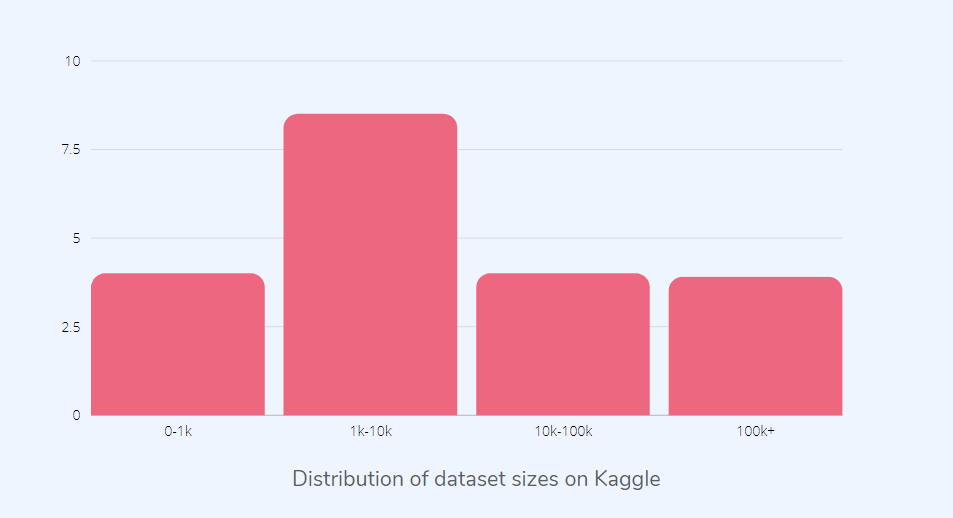
Как видно из рисунка выше, большинство массивов данных Kaggle не очень велико. При датацентрическом подходе размер массива данных не так важен, и многое можно сделать даже с небольшим качественным массивом данных.
Качество данных
Как понятно из названия, здесь важно качество данных. Не важно, есть ли у вас миллионы массивов данных; главное, чтобы они имели высокое качество и были правильно размечены.

Различные подходы к созданию ограничивающих прямоугольников
На рисунке выше показаны различные способы разметки данных; нет ничего плохого в разметке их по отдельности или вместе. Однако если дата-саентист 1 размечает каждый ананас отдельно, а дата-саентист 2 размечает их вместе, то данные будут несовместимыми, из-за чего алгоритм обучения запутается. Основная задача — обеспечение согласованности меток; если вы размечаете объекты по отдельности, сделайте так, чтобы все объекты размечались одинаково.
Согласованность аннотирования данных критически важна, потому что любые несоответствия могут сбить модель с толку и сделать её оценку неточной. Поэтому необходимо тщательно составлять инструкции по аннотированию, чтобы инженеры ML и дата-саентисты размечали данные согласованно. Согласно исследованию, приблизительно 3,4% сэмплов в часто используемых массивах данных имеют ошибочные метки, и ошибок больше в больших моделях.

Важность согласованности в малых массивах данных | Источник
На приведённом выше рисунке Эндрю Ын объясняет важность согласованности малых массивов данных. График иллюстрирует соотношение между напряжением и скоростью дрона. Если ваши массивы данных малы, однако их метки согласованы, то вы сможете с большей уверенностью подобрать кривую и получить более высокую точность.
Из-за низкокачественных данных изъяны и неточности могут без каких-либо последствий постоянно оставаться необнаруженными. Точность моделей зависит от качества данных; если вы хотите принимать хорошие решения, то вам нужна точная информация. Данные с плохими атрибутами подвержены риску наличия ошибок и аномалий, которые при использовании предсказательной аналитики и техник моделирования могут стоить вам очень дорого.
Сколько данных достаточно?
Количество имеющихся данных критически важно; для решения задачи необходимо иметь достаточный объём данных. Глубокие нейросети — это компьютеры с малым смещением и высокой дисперсией, и мы полагаем, что решением проблемы дисперсии является увеличение объёма данных. Но какого количества данных достаточно? Ответить на этот вопрос не так уж просто. Yolov5 даёт следующие рекомендации:
- Минимум 1,5 тысяч изображений на каждый класс.
- Минимум 10 тысяч экземпляров (размеченных объектов) на класс в сумме.
Рекомендации по датацентрическому подходу
При внедрении датацентрического подхода не забывайте о следующих аспектах:
- Обеспечивайте постоянно высокое качество данных на протяжении всего жизненного цикла ML-проекта.
- Поддерживайте согласованность меток.
- Используйте данные из продакшена, чтобы вовремя получать обратную связь.
- Применяйте анализ ошибок, чтобы сосредоточиться на подмножестве данных.
- Избавляйтесь от шумных сэмплов; как говорилось выше, «больше» не всегда означает «лучше».
Где искать качественные массивы данных?
Получение высококачественных массивов данных — важная задача. Такие массивы данных можно получить бесплатно в следующих местах:
Kaggle

Первый источник хорошо известен в сообществе дата-саентистов. В Kaggle вы найдёте весь код и данные для работы в data science. У него есть более 50 тысяч публичных массивов данных и 400 тысяч публичных ноутбуков, что позволяет быстро выполнить любой анализ.
Datahub.io

Datahub — это платформа массивов данных, в основном для сфер бизнеса и финансов. На DataHub доступно множество массивов данных, например, списки государств, населения и географических границ, и новые массивы продолжают разрабатываться.
Graviti Open Datasets

Graviti — это новая платформа данных, предоставляющая высококачественные массивы данных в основном для компьютерного зрения. Разработчики и организации могут получать удобный доступ к большим объёмам открытых данных, легко делиться и управлять ими.
Заключение
В этой статье мы узнали, как датацентрический подход отличается от моделецентрического, и как сделать процесс использования машинного обучения более датацентрическим. Мы не обязаны ограничивать развитие одним направлением, и код, и данные играют важную роль в разработке ИИ. Нет никаких жёстких и простых правил выбора между моделецентрическими и датацентрическими методиками, однако надёжность массива данных не стоит игнорировать.
Качество данных нужно поддерживать и совершенствовать на каждом этапе разработки ИИ, и каждый этап по определению требует различных фреймворков и инструментов. Если вам хочется изучить эту тему глубже, можете прочитать статьи по приведённым ниже ссылкам.
Датацентричный подход что это
Что такое датацентричный подход к строительству? Как девелоперу цифровизовать бизнес, избежав снижения эффективности на текущих проектах? На эти и многие другие вопросы отвечает Роман Митин — директор по продукту компании IYNO:
— Роман, прежде, чем мы подробно поговорим о продукте IYNO (АЙНО), хотелось бы узнать Ваше мнение о состоянии рынка программного обеспечения для стройки? Это хаос или какое-то упорядоченное существование?
— Если говорить о программном обеспечении от идеи до реализации объекта, то на рынке ПО для проектирования — хаос, потому что после ухода западных вендоров все ищут пути, как с этим справиться. Кто-то остается на западном ПО, и это, как минимум, рационально, потому что поменять софт – это не просто новый договор с новым поставщиком, а необходимость переобучить весь персонал, разработать новые процессы. Поэтому все выкручиваются по-разному: кто-то остается на западном софте, кто-то по-тихому работает без лицензии, кто-то переходит на российское ПО.
С рынком софта для управления строительством тоже не все в порядке, потому что и отсюда ушли крупные зарубежные вендоры, так что многие переходят на российские решения. Но в целом рынок сильно пошатнулся и находится в нестабильном состоянии.
— А в целом рынок ПО для строительной отрасли развивается плавно или есть отдельные точки роста, а есть и точки провала?
— Если говорить про предыдущий (2022) год, то появился очень большой провал в САПРе. И если по организации процессов в строительстве, в сметном нормировании и в закупках есть большие российские вендоры типа 1С, есть конкурентноспособные продукты в части проектирования промышленных объектов и дорожной инфраструктуры, то в проектировании социальных объектов, в жилье, в коммерческой недвижимости сейчас имеются определенные сложности, потому что рынок ПО не готов. При этом в 2D-проектировании есть достаточное количество предложений, в том числе от китайских вендоров, но с BIM всё гораздо сложнее.
— Исходя из нынешнего состояния рынка, для чего создавалась компания IYNO? Вы вышли на совершенно неосвоенный сектор рынка или поняли, что для вас есть место среди других компаний?
— Изначально не было идеи создавать какие-либо продукты на рынок. Мы все наши продукты создавали для себя, адаптировали и связывали, например, для того, чтобы обеспечить максимально корректную передачу информации с этапа проектирования на этап строительства, для формирования актов приемки работ с учетом выявленных нарушений в процессе строительства. Также нами были разработаны плагины для ПО Autodesk и дальнейшей передачи информации в базы данных и BI-системы Microsoft. То есть, это был сложный автоматизированный процесс, работавший в рамках одной компании.
Но дальше, когда мы общались на конференциях и семинарах с нашими партнерами и представляли наши наработки, технология вызвала интерес, и нас начали привлекать как консультантов на существующие проекты, пытались внедрять нашу технологию. Однако это «не взлетело» – по одной простой причине: мы прошли большой путь, научились работать в множестве небольших самодельных программ и интеграций, и нам было комфортно. Но приходить в слаженный коллектив и в короткий срок пытаться внедрить комплекс рыночных решений – это очень сложно.
Поэтому постепенно модель сменилась, и нас стали приглашать уже не как консультантов, а как подрядчиков, которые параллельно с существующими процессами осуществляли роль цифрового сопровождения: оцифровывали данные строительства, через BIM-модели фиксировали все, что происходит в реальной жизни. И от этого наши заказчики уже получали достоверную информацию для принятия решений и отчётов перед инвесторами. По сути, мы сократили цикл получения результата от цифровизации. Из подхода «внедрение – результат» мы перешли к «результат – внедрение – результат». Девелопер начинает получать пользу от цифровизации максимум через месяц после старта. Это невероятная скорость по сравнению с традиционным процессом, когда идет сначала внедрение, потом результат.
Именно в этот период мы проверили десятки гипотез, отработали механизмы и процессы, сформировали интересную методологию и поняли, что пора её масштабировать. Запросов на сервисные функции было все больше, и рынок охотно воспринимал новые подходы к управлению строительством. В этот момент мы приняли решение о создании самостоятельной IT-компании, привлекли инвестиции — и вот так стартовал проект IYNO.
— Продукт IYNO (АЙНО) — уникальный в своем роде или существуют какие-то аналоги?
— Да, это совершенно новый продукт. Мы очень хотели бы с кем-то конкурировать, потому что так проще развиваться и можно четко себя позиционировать. Но пока мы не можем найти ту «полочку», на которую нас можно поставить. Эта ниша пока не сформирована, рядом с нами нет ничего подобного. Мы частично пересекаемся с огромным количеством инструментов и продуктов, но идею, аналогичную нашей, мы пока не встречаем нигде. А идея заключается в том, чтобы не автоматизировать конкретные рабочие места, как это сейчас часто предлагается вендорами ПО, а связать все существующие в компании данные воедино.
Можно автоматизировать рабочее место планировщика или инженера, который формирует ведомость объемов работ, или строительный контроль в части фиксации нарушений, но все эти рабочие места, как правило, живут автономно. Причем на каждом рабочем месте могут быть очень хорошие продукты, позволяющие делать очень много – но изолировано. Например, в ПО для строительного контроля можно фиксировать выявленные нарушения, прикладывать фотоотчеты, уведомлять подрядчиков. Но накопленные данные не влияют на дальнейший процесс в части приемки работ при подписании КС-2. Та информация, которая была создана на предыдущем этапе, никак не автоматизирует последующий.
Наша концепция состоит в том, что, связав элементы моделей с работами и сформировав тем самым ведомость объемов работ, мы создаем информационную базу, с которой связаны данные последующих этапов строительства. Единица учёта в нашем случае — это конкретная работа, выполняемая по конкретному элементу, в терминах системы это связь «элемент-работа» (СЭР). СЭР распределяются по лотам, попадают в сметы и договоры, они являются единицами планирования и учёта факта выполнения, по ним фиксируются нарушения и исполнительная документация. То есть, вся информация по управлению строительством связывается даже не через элементы модели, а через работы по каждому элементу — СЭР. Это даёт широчайшие возможности для анализа и исключения лишних, непродуктивных этапов бизнес-процесса, речь идет уже не об автоматизации рабочих мест, а о цифровизации всего проекта строительства или целой компании.
Такой продукт и такой подход на рынке мы не встречали. И это обязывает нас разъяснять и распространять методологию самостоятельно, раскачивать рынок, чтобы изменить устоявшиеся подходы.
— Но готова ли строительная отрасль именно к такому подходу или дело заканчивается именно автоматизацией рабочих мест?
— Если говорить про большие компании, в них действуют две противоположно направленные силы. Одна сила направлена на цифровизацию, и компания тратит на это деньги, у нее есть ресурсы, она вкладывается в развитие собственного ПО и интегрирует различные рыночные решения. Руководство заинтересовано в том, чтобы цифровизоваться и повысить операционную эффективность компании.
Сила, направленная в противоположную сторону, — это потоковое строительство. Компании нужно параллельно строить сотни тысяч квадратных метров недвижимости, и все изменения процессов, трансформации структуры подразделений, комплексная цифровизация только мешают, потому что в любом случае будет временная просадка эффективности. И через эту просадку никто не хочет проходить. Руководители проектов, руководители подразделений часто неосознанно сопротивляются цифровизации. В итоге на местах мы видим большое количество саботажа, причем неумышленного. Цифровизация упирается в поток регулярной работы.
И если у больших девелоперов уживается «два в одном», то средние и небольшие девелоперы делятся полярно. Часть совершенно консервативна, ничего не видит и не слышит, делает свое дело и, на мой взгляд, с таким подходом им не выстроить долгосрочную стратегию существования и развития. Есть и другие, которые смотрят на рынок широко открытыми глазами, они учатся у международных лидеров, пробуют различные стратегии, непрерывно исследуют свой бизнес и формируют собственный подход к «цифре». Надо отметить, что за последние 5 лет доля прогрессивных компаний существенно возросла.
Недавно мы встречались с застройщиком, который сказал: «Мы не хотим организовывать электронный документооборот, мы хотим объединить имеющиеся у нас данные». То есть, они понимают, что во главу угла нужно ставить не автоматизацию прохождения бумажки, и не электронная цифровая подпись даст доверие к информации. Доверие к информации дадут правильно организованные данные и возможность проследить цепочку их создания. И отчет становится правильным документом не тогда, когда его кто-то подписал ЭЦП, а когда мы понимаем, на основании каких данных он собран, что данные в нем взаимосвязаны и достоверны. С такими застройщиками мы говорим на одном языке, и радует, что их все больше.
— То есть, вы предлагаете переход от работы с документами к работе с данными – то, чем у нас умеют заниматься единицы компаний. И при этом, сейчас, как правило, при обсуждении путей цифровизации речь идет не об обороте данных, а о прохождении документов…
— Совершенно верно и нам очень печально это наблюдать. Потому что, когда мы в 2023 году говорим, что нам нужно автоматизировать процесс прохождения pdf-файла с подписанием электронной подписью, и ожидаем радикального повышения эффективности бизнеса – это выглядит очень нелепо. Сейчас нужно говорить о накоплении данных, о больших данных, о понятиях первичных и вторичных данных, о внедрении искусственного интеллекта, а не о том, как быстро провести документ в системе ЭДО.
Кроме того, даже автоматизация рабочих мест ничего не дает, если не сформирована система обмена данными и не подготовлены люди для работы с ней. У нас был один из кейсов, когда мы услышали от компании: «При автоматизации рабочего места строительного контроля ничего не изменилось: был обмен нарушениями в WhatsApp — стал обмен нарушениями в цифровой суперсистеме, но это ни на что не повлияло». Подобное происходит и с BIM-моделью: компания создает BIM-отдел, набирает профессиональных сотрудников, которые должны правильно заказывать и следить за качеством BIM-моделей. Разработанные модели попадают в несколько отделов, которые между собой не связаны, и у них нет никакой мотивации с этой моделью ежедневно работать. В результате требования к моделям не согласованы, не отражают реальные потребности бизнеса, контроль за их соблюдением ведется нерегулярно. Работа с моделями приносит пользу для одних подразделений и добавляет работы другим, но главное, что не происходит ускорения процесса, данные из моделей доходят до лиц, принимающих решения, с существенным опозданием относительно документов, полученных классическим образом.
Тут уже сам заказчик должен понять, что если весь процесс связывается через BIM -модель и данные компании действительно становятся общими, то наступает момент самоорганизации: требования к моделям становятся рациональными, не содержат лишнего, но отражают потребности сквозного процесса, руководители проектов организуют своевременный обмен информацией и отслеживают внесение данных различными участниками. Становится понятно, для чего именно собственники компаний инвестируют средства в цифровизацию и как они возвращаются.
Иногда мы слышим, что фактический процесс в компании выглядит так: сначала построили, потом запроектировали, а потом сделали BIM -модель. Причём преподносится это как нечто вечное, что невозможно изменить. Разве это хорошо? Это означает, что идут процессы, которыми вы не управляете, что подрядчик сначала что-то сделал, а потом вы вынуждены с этим согласиться. Экономия сроков за счёт строительства без проекта мнимая, а финансовые потери могут быть существенными.
— Роман, вы часто встречаетесь с компаниями, с застройщиками – есть ли интерес к вашему продукту?
— Без лишней скромности хочу сказать, что интерес у всех есть сразу. Но не у всех есть решительность сделать первый шаг. Поэтому мы предлагаем следующий подход: мы запускаем легкие пилотные проекты, которые сразу дают результат — и ради этого мы создали IYNO Service. У нас есть команда профессионалов, цифровых строителей, которая подключается к проекту нашего заказчика и начинает своими руками на их базе выполнять то, что впоследствии должны будут выполнять сотрудники заказчика. Это дает возможность быстро показать результаты, проверить гипотезы, развеять скепсис и опасения. Потом пилотные проекты переходят в статус регулярных — то есть, заказчики, получив первые результаты, поняли, поверили и приняли решение идти дальше. Этапность нашей работы — один месяц, и за это время уже можно показать первые результаты, например, что застройщик перерасходовал средства, не учёл часть работ в бюджете, либо у него есть какие-то искажения в календарном плане, которые можно исправить и улучшить контроль за проектом, начать связывать данные. Тем самым мы не заставляем застройщика или подрядчика ждать несколько месяцев, учить сотрудников, чтобы они когда-то потом начали работать и получили результат – мы готовы быстро зайти с нашими продуктами и постепенно передавать их в руки сотрудников заказчика.
— Что в итоге такой работы получает заказчик?
— Во-первых, мы никогда не говорим заказчику: отказывайся от своих инструментов, теперь будешь использовать наши. Мы стараемся интегрироваться практически со всеми инструментами, которые есть в различных подразделениях. И если у заказчика есть ERP-система, то ведомость объемов работ, созданная в IYNO, будет связана с управлением складскими ресурсами, закупками и прочими процессами. Если у заказчика есть система строительного контроля, мы интегрируемся с ней, чтобы забирать информацию о нарушениях и, связав её, использовать при формировании или проверке акта выполнения работ. Если же в компании ничего нет, кроме условного Excel, — а так часто бывает – мы предоставим пользователям собственные модули по строительному контролю или управлением исполнительной документацией, и с этим может справляться только IYNO. То есть, первый результат – это настроенная инфраструктура, которая может развиваться и достраиваться новыми продуктами.
Второе – это перестроенные бизнес-процессы, когда поступление и передача информации идут последовательно и вовремя. И третье – это обученный персонал, который, переняв опыт от специалистов IYNO, может дальше работать самостоятельно.
— Что с собой приносит IYNO? Это некий программный продукт, который встает над всеми действующими продуктами и начинает их связывать?
— Скорее, IYNO формирует некий фундамент данных и заполняет пустоты, позволяет другим инструментам и процессам связываться между собой. Это многопользовательское облачное решение, которое способно нормализовать и объединить данные, может как самостоятельно автоматизировать бизнес-процессы, так и связать действующие процессы, заполнив те зазоры, где раньше информация переносилась вручную.
— Это принципиальный момент, потому что многие вендоры, предлагая свой пакет программ, требуют убрать все старое. Понятно, что компания начинает оценивать, во что ей обойдется снос старого софта, покупка нового и обучение персонала. То есть, в вашем случае ничего не нужно сносить?
— Да, совершенно верно. Мы понимаем, что в любой компании есть инструменты, в которые она вложилась. Она не только их купила, она обучила коллектив, настроила процессы, что-то доработала самостоятельно в купленном пакете программ. И сносить все это, по умолчанию доверившись какому-то новому вендору, — это крайне нецелесообразно. Поэтому мы сразу выстраиваем такую архитектуру, чтобы можно было не конкурировать с готовыми имеющимися решениями, а дополнять их.
— Я вижу, что ваш подход, с одной стороны, передовой, а с другой стороны, более прагматичный. Потому что за эти годы компании натащили к себе всего, что смогли – с разными лицензиями от разных вендоров. И ваш продукт, гораздо более щадящий в этом смысле, нежели замена всего, что уже работает. Вы не оценивали, насколько экономически выгоден ваш подход, нежели снос старого и покупка нового ПО?
— Речь в этом вопросе точно не идет о стоимости ПО – она примерно у всех одинаковая, если смотреть общую картину. Тут речь идет о трансформации компании, и именно это, как правило, стоит больших денег: чем масштабнее трансформация, тем глубже тот самый провал в эффективности компании и тот мучительный выход из «ямы». Чем радикальнее изменения были затеяны, тем глубже провал.
В случае с IYNO мы органично добавляем сервисы и постепенно передаем их действующим сотрудникам компании. Провал получается минимальным. По сути, стоимость перехода на цифру измеряется именно глубиной этого провала, а мы пытаемся эту глубину минимизировать. И самое главное – IYNO обеспечивает поток достоверных данных со всех участков строительства в реальном времени. И это тоже огромное экономическое преимущество.
Датацентричный подход что это

Развитие ИТ (информационных технологий), а также растущая популярность так называемой «науки о данных» (data science) связана с эффективностью деятельности организаций, которая только возрастает при грамотных сборе, обработке и применении собранного большого количества данных [1] в связи с современными требованиями бизнеса в оперативной реакции на большие потоки разнообразной информации. Большое количество собранных данных стало носить название «большие данные» (big data) [2] и иметь отдельную ценность в зависимости от деятельности организации, собирающей, обрабатывающей и применяющей на практике эти данные [3]. На фоне этого устоявшиеся методы разработки информационных систем становятся неэффективны в рамках развития информационных систем и приводят к громоздким программным решениям.
Цель исследования – провести обзор, характеристику и сравнение традиционного (приложение-ориентированного) и датацентричного подхода при проектировании информационных систем, а также рассмотреть применение датацентризма в рамках распределённых систем и в сфере больших данных.
Материалы и методы исследования
Обзор и анализ открытых источников (в том числе на иностранном языке), сравнение представленных подходов проектирования информационных систем.
Результаты исследования и их обсуждение
На фоне этого одни и те же данные могут иметь разный вид и формат, быть продублированы в разных программных приложениях, выполняющих разные задачи по их обработке. Это приводит к сильному разделению информации по её разным характеристикам: по характеру выполняемых действий над ними, невзирая на их содержимое, по форме и месту их записи, по типу исходников. Это попутно усложняет ИТ-инфраструктуру организаций, повышая издержки на её обслуживание.
В итоге это приводит к пониженной эффективности систем хранения данных, систем и приложений, а также повышенной стоимости разработки и поддержки программных и аппаратных средств сбора и обработки информации из-за возникновения копий одних и тех же данных в разных формах и/или форматах, направленных на использование в различных программных системах.
Возникает это в первую очередь из-за «традиционного» подхода к проектированию информационных систем, где в центре внимания находится само программное приложение – «приложение центризм» (Application Centric) [4]. Другими словами, проектирование ведётся обособленно от уже имеющихся данных и других информационных систем, начиная с программного кода и заканчивая формированием формата и формы данных, а также организация их хранения для конкретной программы.
Также для работы программ в условиях высокой нагрузки применяются методы проектирования распределённых информационных систем [5], которые способствуют более простому и менее затратному её дальнейшему масштабированию в рамках выполняемых ими задач [6]. Но, когда возникает необходимость в создании дополнительной подсистемы или выполнении специфической работы над собранными данными, полученными исходной информационной системой, возникает необходимость в создании отдельных методов подготовки и переноса данных из существующей системы в новую (другими словами – организовать слой для конвертации данных из системы А в систему Б) посредством отдельного прикладного программного обеспечения, созданного исключительно для этих целей (рис. 1), что требует выделения отдельных ресурсов.
Помимо наличия издержек на расширение функционала за счёт промежуточного прикладного программного обеспечения может возникнуть ситуация, в которой может происходить снижение производительности исходной информационной системы. Это может происходить, если полученные в процессе конвертации данные физически будут находиться и управляться в системе управления базами данных исходной системы, создавая две копии одних и тех же данных, рассчитанные на обработку в разных системах – связано это в первую очередь с разделением аппаратных ресурсов базы данных на обслуживание данных нескольких систем.
Эту проблему можно решить посредством «стандартизации» данных, то есть приведения аккумулированной информации в единый для организации избыточный формат (или приспособленной для масштабирования схемы данных). Благодаря этому компоненты разных информационных систем смогут беспрепятственно оперировать одними и теми же наборами данных, сокращая расходы вычислительных ресурсов за счёт исключения и сокращения процессов копирования, конвертации и переноса (в случае разных хранилищ данных для разных систем) информации для её последующей передачи компонентам систем, а также потенциально даёт возможность сократить издержки, связанные с необходимостью дальнейшего расширения систем хранения данных.
Датацентризм – это архитектурный подход к построению информационных систем, где центральным и главным звеном являются данные, без которых невозможно обеспечить результативность программных систем и отдельных приложений [7]. На уровне архитектуры датацентризм выражается в наличии центральной системы хранения и управления данных в качестве главного компонента информационной системы.
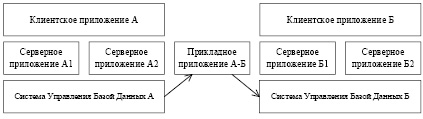
Рис. 1. Появление второстепенной информационной системы на базе собранных данных исходной системы