Как устроено компьютерное зрение?
Мы запускаем камеру на смартфоне, наводим на объект и видим маленькую иконку внизу. Смартфон понимает — что именно мы снимаем. Вы когда-нибудь задумывались, как это работает?
Беспилотные автомобили спокойно объезжают машины и тормозят перед пешеходами, камеры видеонаблюдения на улицах распознают наши лица, а пылесосы отмечают на карте, где лежат тапочки — всё это не чудеса. Это происходит прямо сейчас. И всё благодаря компьютерному зрению.
Поэтому сегодня разберем, как работает компьютерное зрение, чем оно отличается от человеческого и чем может быть полезно нам, людям?
Для того чтобы хорошо ориентироваться в пространстве человеку нужны глаза, чтобы видеть, мозг, чтобы эту информацию обрабатывать, и интеллект, чтобы понимать, что ты видишь. С компьютерным или, даже вернее сказать, машинным зрением, такая же история. Для того, чтобы компьютер понял, что он видит, нужно пройти 3 этапа:
- Нам нужно как-то получить изображение
- Нам нужно его обработать
- И уже только потом проанализировать
Пройдёмся по всем этапам и проверим, как они реализованы. Сегодня мы будем разбираться, как роботы видят этот мир, и поможет нам в этом робот-пылесос, который напичкан современными технологиями компьютерного зрения.
Этап 1. Получение изображения
В начале компьютеру надо что-то увидеть. Для этого нужны разного рода датчики. Насколько много датчиков и насколько они должны быть сложные зависит от задачи. Для простых задач типа детектора движения или распознавания объектов в кадре достаточно простой камеры или даже инфракрасного сенсора.
В нашем пылесосе есть целых две камеры, они находятся спереди. А вот, например, для ориентации в трехмерном пространстве понадобятся дополнительные сенсоры. В частности 3D-сенсор. Тут он тоже есть и расположен сверху. Но что это за сенсор?
LiDAR
Вообще с названиями 3D-сенсоров есть небольшая путаница, одно и тоже часто называют разными словами.
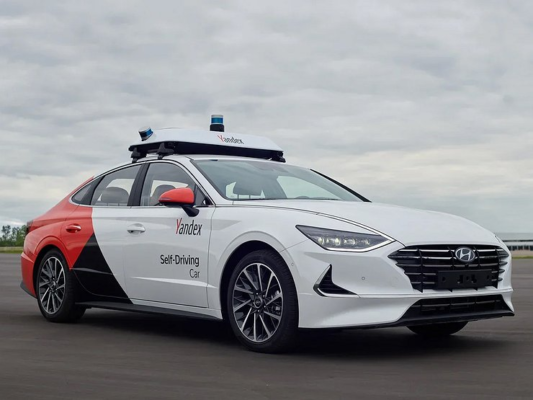
Эта штука сверху — называется LDS или лазерный датчик расстояния, по-английски — Laser Distance Sensor. Подобные датчики вы наверняка могли заметить на крышах беспилотных беспилотных автомобилей. Это не мигалка, это лазерный датчик расстояния, такой же как на роботе пылесосе.
Вот только в мире беспилотников такой сенсор принято называть лидаром — LIDAR — Light Detection and Ranging. Да-да, как в новых iPhone и iPad Pro.

А вот в Android-смартфонах вместо лидаров используется термин ToF-камера: ToF — Time-of-flight.
Но, как ни называй, все эти сенсоры работают по одному принципу. Они испускают свет и замеряет сколько ему понадобится времени, чтобы вернуться обратно. То есть прямо как радар, только вместо радиоволн используется свет.
Есть небольшие нюансы в типах таких сенсоров, но смысл технологии от этого не меняется. Поэтому мне, чисто из-за созвучия с радаром, больше всего нравится название LiDAR, так и будем называть этот сенсор.
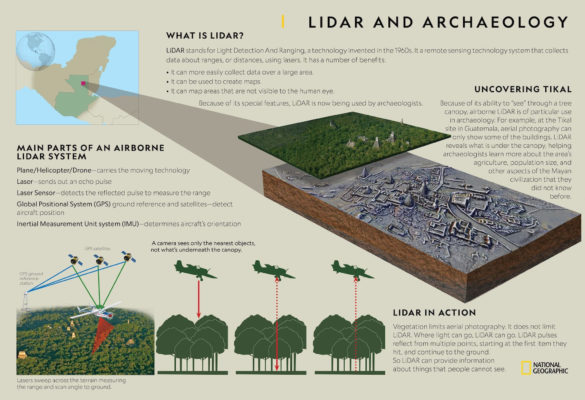
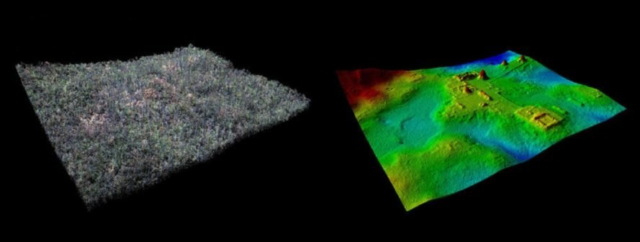
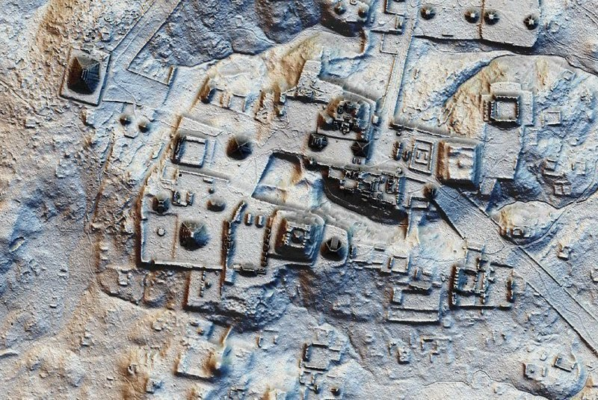
Кстати, лидары использует не только в задачах навигации. Благодаря лидарам сейчас происходит настоящая революция в археологии. Археологи сканируют территорию с самолета при помощи лидара, после чего очищают данные ландшафта от деревьев. И это позволяет находить древние города, скрытые от глаз человека!
Также помимо статических лидаров, направленных в одну сторону, бывают вращающиеся лидары, которые позволяют сканировать пространство вокруг себя на 360 градусов. Такие лидары используется в беспилотных автомобилях, ну и в этом роботе-пылесосе.
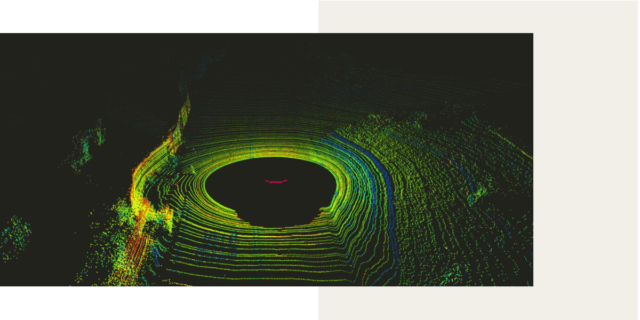
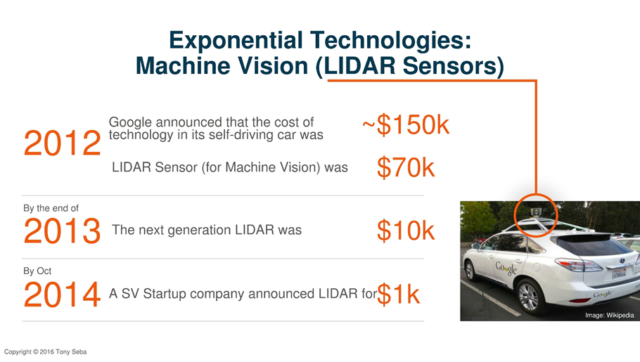
Еще 8 лет назад такие сенсоры стоили каких-то невероятных денег, под 100 тысяч долларов. А теперь у вас по дому может спокойно ездить маленький беспилотник.
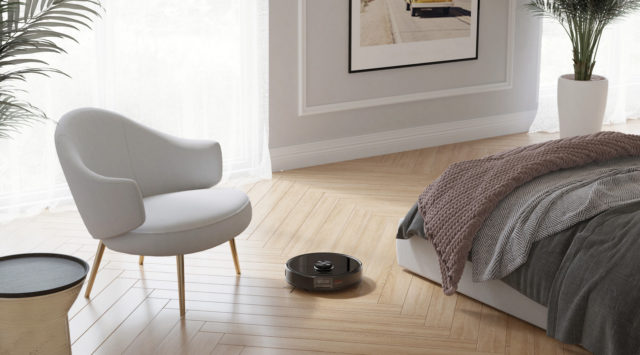
Лидар в пылесосе
Окей, тут лидар используется для построения карты помещения и это не новая история. Такую технологию мы видели еще года 3-4 назад.
Благодаря лидару и построенной карте, пылесос ездит не рандомно как скринсейвер в Windows, стукаясь об углы, а аккуратно проезжая всю площадь (модели без лидаров обычно катаются странно).
Но внутри пылесоса стоит, на секундочку, восьмиядерный Qualcomm Snapdragon 625 (Qualcomm APQ8053), поэтому у него хватает мозгов не только построить карту, но и ориентироваться по ней.
Более того пылесос может хранить в памяти до четырёх карт и распознаёт этажи. Это существенно ускоряет уборку. Потому при переносе с этажа на этаж пылесос это может понять и не тратит время, чтобы построить карту заново.
Также каждую из 4 карт можно поделить на 10 специальных зон. Для которых можно настроить свои параметры уборки: мощность всасывания (до 2500 Па), количество проходов и прочее. А куда-то можно вообще запретить ездить. Можно даже выбирать сухую и влажную уборку для разных зон. Правда для этого не нужно подключать/отключать отдельный резервуар с водой. И всё это стало возможно благодаря лидару.
Тем не менее у технологии есть некоторые недостатки — очень разреженные данные. Пространство сканируется линиями. В больших автомобильных радарах разрешение — от 64 до 128 линий. Плюс ко всему у лидар есть мертвая зона. Если лидар стоит на крыше — то он не видит, что творится в достаточно большом радиусе вокруг него.
Также в роботе-пылесосе лидар тут сканирует пространство всего одним лучом. Поэтому, всё что он видит — это тонкая линия на высоте где-то 9-10 сантиметров от пола. Это позволяет определять где стены и мебель, но он не видит того, что валяется на полу.
Две камеры
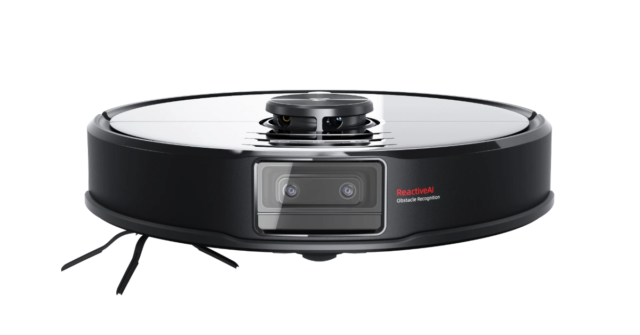
Поэтому, чтобы исправить этот недочет лидаров. как в автомобили, так и в пылесосы ставят дополнительные камеры. Тут камеры сразу две, и они обеспечивают стереоскопическое зрение. Да-да, у пылесоса всё как у людей — два глаза.
Две камеры, во-первых, позволяют убрать мертвую зону впереди пылесоса. А во вторых позволяют достаточно точно определять расстояние до валяющихся на полу предметов.
Это позволяет пылесосу обнаруживать предметы размером не менее 5 см в ширину и 3 см в высоту и объезжать их.
Этап 2. Обработка
Итак, мы получили достаточно данных с различных сенсоров. Поэтому переходим ко второму этапу компьютерного зрения — обработке.
Данные с лидара мы получаем в виде трехмерного облака точек, которые фактически не нуждаются в дополнительной обработке.
Как получить стерео с двух камер тоже понятно — высчитывается разница между изображениями снятыми чуть под разным углом и так строится карта глубины. Это несложно.
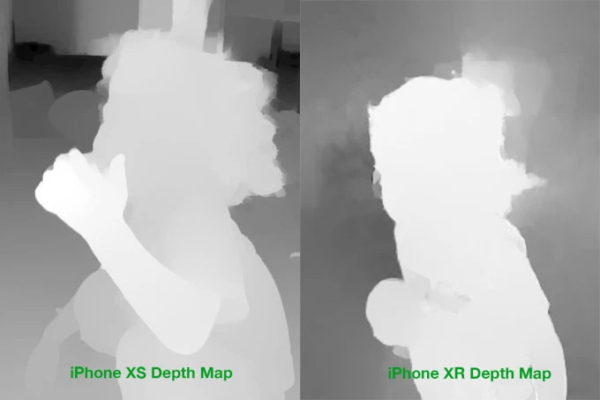
Но вот совместить данные с разных сенсоров — это нетривиальная задача.
Например, пылесос на полу обнаружил какой-то предмет. Дальше ему нужно понять где именно он находится на карте построенной при помощи лидара. А также нужно предположить какие у него габариты по проекции с одной стороны. То есть нам нужно поместить предмет в некий объёмный куб правильного размера.
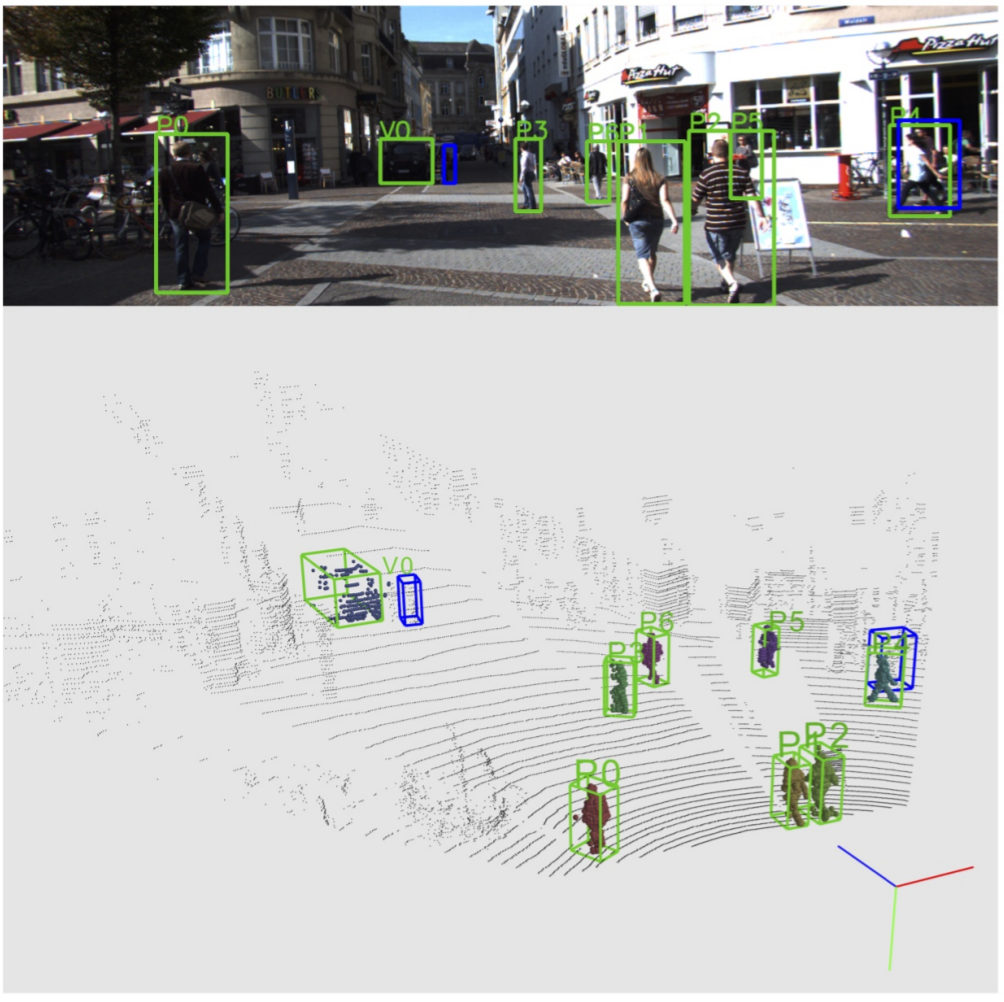

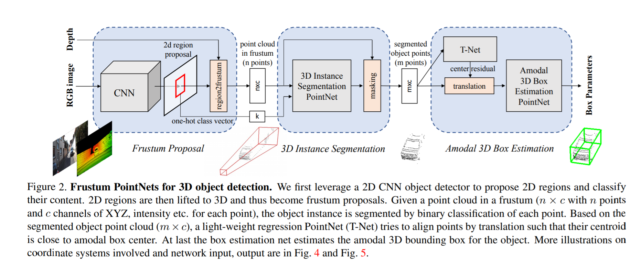
Эту задачу можно решить разными способами. Один из способов называется “усеченная пирамида”. Сначала на камере обнаруживаются предметы. Потом эти предметы помещаются в конус, а объем этого конуса вычисляется нейросетью.

Поэтому даже, казалось бы, такая тривиальная задача требует серьёзных вычислений и решается при помощи нейросетей.
А раз мы заговорили про нейросети, значит мы уже немного зашли на 3-й этап компьютерного зрения — анализ.
Этап 3. Анализ
За распознавание, сегментацию и классификацию объектов на изображении в современном мире в основном отвечают нейросети. Мы даже делали подробный ролик о том как это работает, посмотрите.
Если кратко, нейросеть — это такое большое количество уравнений, связанных между собой. Загружая в нейросеть любые данные — ты обязательно получишь какий-то ответ.
Но, например, если постоянно загружать в нейросеть фотографии кошечек, и указать ей, что ответ должен быть — кошка. В какой-то момент, нейросеть перестает ошибаться на обучающей выборке. И тогда ей начинают показывать новые незнакомые изображения и если на них она тоже безошибочно определяет кошек — нейросеть обучена.
Дальше нейросеть оптимизируется для того, чтобы она стала меньше, быстро работала и не жрала много ресурсов. После этого она готова к использованию.
Что-то похожее происходит с нейронными связями в человеческом мозге. Когда мы чему-то учимся или запоминаем, мы повторяем одно и то же действие несколько раз. Нейронные связи в мозге постепенно укрепляются и потом нам это легко даётся!
Например, в данном пылесосе за работу нейросети отвечает встроенный NPU-модуль. Всё-таки внутри Snapdragon, пылесос может себе такое позволить.
Нейронка предобучена определять различные предметы домашнего обихода: игрушки, тапочки, носки, всякие удлинители, зарядки и даже неожиданности от домашних животных.
Распознавание предметов происходит при помощи гугловской библиотеке Tensorflow. Алгоритм самообучается и умнеет от уборки к уборке.
Практика
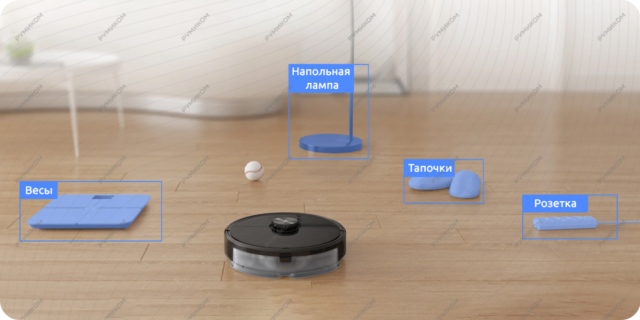
В нашем роботе-пылесосе технология распознавания называется Reactive AI. Мы протестировали насколько она хорошо работает на практике.
Кайфовая штука, что все найденные предметы пылесос отмечает не карте. Поэтому теперь, я не обещаю, но такое возможно, вы всё-таки обнаружите логово пропавших носков.
Проследить за тем, что видит пылесос всегда можно через фирменное приложение или Mi Home от Xiaomi. Можно даже просто кататься по дому управляя пылесосом слать на него голосовые сообщения. Управлять пылесосом можно также через Google Ассистента или Алису. Всё на русском языке.
С недавних пор бренд начал официально продаётся в России, поэтому устройства полностью локализованные.
Внутри кстати стоит батарейка на 5200 мАч, которая способна выдержать до 3 часов уборки.
Итоги
Ребят, ну вы сами всё видели. Правда, стоит обратить внимание, что пока корректное распознавание предметов работает только если запускать пылесос через специальное приложение. И это нюанс, поскольку оно пока недоступно в Play Market Россия. Но в течение нескольких месяцев оно появится.
Компьютерное зрение: технологии, компании, тренды
Компьютерное зрение (Computer Vision, CV), в том числе машинное зрение (Machine Vision, MV) – это автоматическая фиксация и обработка изображений неподвижных и движущихся объектов при помощи компьютерных средств.
С развитием облачных технологий, виртуализации вычислений и прикладных областей развитие компьютерного зрения получило новый импульс.
По данным маркетингового отчета американской исследовательской и консалтинговой компании Grand View Research 1 Computer Vision Market Size, Share & Trends Analysis Report By Component (Hardware, Software), By Product Type (Smart Camera-based, PC-based), By Application, By Vertical, By Region, And Segment Forecasts, 2020 – 2027. Опубликовано: сентябрь 2020 г. grandviewresearch.com/industry-analysis/computer-vision-market , в 2019 году размер мирового рынка компьютерного зрения оценивался в 10,6 млрд долларов США и будет расти со среднегодовым темпом роста в 7,6% с 2020 по 2027 год.
Наиболее часто используемой моделью глубокого обучения является модель искусственной нейронной сети, называемая сверточной нейронной сетью. Наиболее успешными моделями, используемыми для обнаружения, классификации и анализа изображений, являются AlexNet, ResNets, EfficientNets, YOLO, R-CNN, LambdaNetworks, VGG (описания приведены в Приложении 1).
Лидерами по развитию и использованию компьютерного зрения на международном уровне являются Google, Facebook, Microsoft, Amazon, NVIDIA и др. В России ключевые позиции на рынке занимают Яндекс, VisionLabs, Mail.ru Group, NtechLab, ABBYYи др. Информация о проектах в сфере компьютерного зрения указанных и ряда других компаний приведена в Приложении 1.
Одним из растущих трендов развития технологий компьютерного зрения является переход к периферийным вычислениям, которые выигрывают у облачных сервисов в скорости и безопасности. Все больше и больше компаний используют периферийные вычисления в сочетании с облачными сервисами для своих данных из-за их оптимизированного подхода.
Много усилий прикладывается со стороны научного сообщества для развития объяснимости решений ИИ, поскольку, несмотря на достаточно высокую точность детектирования и классификации в задачах компьютерного зрения, в ходе исследований было доказано, что верные решения системой могут быть приняты в ходе неверного распределения весов. Одним из известнейших случаев является задача определения «хаски-волк» 2 https://arxiv.org/pdf/1602.04938v1.pdf , в которой модель достигла высокой точности, однако, как оказалось при разборе, наибольший вес в расчетах отдавался такому признаку как наличие снега на фоне.
Исследователи возлагают большие надежды на автоматическую разметку данных для обучения нейросетей. Поскольку большой объем хорошо размеченных данных является фундаментом надежной модели, автоматическая разметка заметно сократила бы сроки обучения и ускорила создание конечного приложения компьютерного зрения. Ручная разметка одного изображения (например, из датасета COCO) может занять от 2 до 19 минут, время для разметки всего датасета может достигнуть 53 000 часов. В случае использования автоматической разметки специалисту зачастую необходимо только проверить точность контуров и внести необходимые изменения, что значительно сократит время подготовки датасета. Популярные решения для автоматической разметки изображений: Google’s Vision API, Cloud Annotation Tool (IBM), Computer Vision Annotation Tool (Intel).
Набирают популярность методы ускорения и упрощения моделей для их повсеместного внедрения. Модели становятся всё более универсальными, легко адаптируемыми для конкретных задач, одновременно становясь всё менее ресурсоёмкими. Многие исследователи и компании (в основном это крупные корпорации) выкладывают в общий доступ уже обученные модели, которые далее любая заинтересованная сторона может обучить на собственном датасете под свои конкретные задачи. Такой подход позволяет сэкономить вычислительные мощности, необходимые для обучения моделей.
Аналитики предсказывают наиболее активное развитие и применение технологий компьютерного зрения в автономных транспортных средствах, системах биометрического сканирования и распознавания лиц для повышения безопасности ценных активов, системах контроля качества продукции, автоматизации процессов производства в промышленности.
В прилагаемой аналитической справке кроме описания моделей, алгоритмов и конкретных проектов также приведены примеры и описания наиболее популярных библиотек и инструментов для создания приложений компьютерного зрения, датасеты, используемые для построения моделей компьютерного зрения, а также существующие механизмы поиска подходящего датасета.
Технологии компьютерного зрения могут быть использованы для выявления противоправного контента, однако на современном уровне развития модели требуют дополнительной обработки результатов специалистами в ручном режиме.
Компьютерное зрение: технологии, компании, тренды
Оглавление
Введение
Computer vision (CV) – совокупность технологий, методов и алгоритмов, с помощью которых компьютер может обрабатывать изображения и видеопоток. Использование компьютерного зрения позволяет определять, что изображено, классифицировать эти изображения и анализировать их.
Основные сферы применения: видеонаблюдение и безопасность, распознавание лиц, сельское хозяйство, зрение для роботов, контроль качества на производстве, системы обнаружения бокового трафика в автомобилестроении, автономные транспортные средства, обработка медицинских изображений для постановки диагноза, фильтрация нежелательного контента, выявление фейковых фотографий, актуализация и кастомизация рекламы, наложение фильтров на фото и видео.
Разработчики компьютерного зрения чаще всего используют языки Python или С++, а также специализированные библиотеки. Регулярно пополняются датасеты для обучения нейронных сетей, проводятся соревнования для поиска лучших решений.
Компьютерное зрение работает в три основных этапа:
- Получение изображения. Изображения, даже большие, можно получать в режиме реального времени с помощью видео, фотографий или 3D-технологий для анализа.
- Обработка изображения. Модели глубокого обучения автоматизируют большую часть этого процесса, но модели часто обучаются, сначала получая тысячи помеченных или предварительно идентифицированных изображений.
- Понимание изображения. Последний этап – это этап интерпретации, когда объект идентифицируется или классифицируется.
В части понимания изображения современные системы ИИ могут применяться следующим образом:
- Сегментация изображения: разбивает изображение на несколько областей или фрагментов для отдельного исследования.
- Обнаружение объекта: идентифицирует конкретный объект на изображении. Расширенное обнаружение объектов распознает множество объектов в одном изображении: футбольное поле, нападающий, защитник, мяч и так далее. Эти модели используют координаты X, Y, чтобы создать ограничивающую рамку и идентифицировать все внутри нее.
- Распознавание лиц: расширенный тип обнаружения объектов, который не только распознает человеческое лицо на изображении, но и идентифицирует конкретного человека.
- Обнаружение края: метод, используемый для определения внешнего края объекта или ландшафта, чтобы лучше определить, что находится на изображении.
- Распознавание образов: процесс распознавания повторяющихся форм, цветов и других визуальных индикаторов на изображениях.
- Классификация изображений: группирует изображения в разные категории.
- Сопоставление признаков: тип обнаружения шаблонов, который сопоставляет сходства в изображениях, чтобы помочь их классифицировать.
Простые приложения компьютерного зрения используют только один из этих методов, но более сложные, такие как компьютерное зрение для автомобилей с самостоятельным вождением, полагаются на различные методы для достижения своей цели.
Библиотеки и инструменты
Наиболее популярные библиотеки и инструменты для создания приложений компьютерного зрения:
Amazon Rekognition
Платформа, выделяющаяся на фоне аналогов возможностью глубокого анализа попавших в объектив камеры предметов, сооружений и людей. Данный сервис является частью системы с интегрированным механизмом полномасштабного самообучения. Ключевой особенностью сервиса значится «глубокий анализ» – способность не просто уведомить пользователя, что на картинке был обнаружен кот или собака, а с высокой точностью указать даже породу животного. А при использовании Amazon Rekognition для распознавания лица программное обеспечение без труда определит по внешним признакам текущее эмоциональное состояние исследуемой личности. Методика включает в себя сравнение двух изображений на основе миллионов признаков.
BoofCV
Библиотека Java с открытым исходным кодом для приложений робототехники и компьютерного зрения в реальном времени, которая распространяется под лицензией Apache 2.0 как для обучения, так и для бизнеса. Функциональность охватывает широкий круг вопросов, включая оптимизированные процедуры обработки изображений на низком уровне, выравнивание камеры, обнаружение/отслеживание функций, определение структуры по движению и распознавание.
CUDA
Продукт NVIDIA для параллельных вычислений, которые просты в программировании, очень эффективны и быстры. Используя мощность графических процессоров, обеспечивает высокую производительность. Набор инструментов включает библиотеку NVIDIA Performance Primitives, содержащую набор функций обработки изображений, сигналов и видео.
GPUImage
Структура, основанная на OpenGL ES 2.0, которая позволяет применять эффекты и каналы с ускорением на графическом процессоре (GPU) к живому движущемуся видео, изображениям и фильмам. Для запуска пользовательских каналов на GPU требуется много кода для настройки и поддержки.
Keras
Библиотека Python для глубокого обучения, которая объединяет элементы разных библиотек, например, Tensorflow, Theano и CNTK. Keras занимает выгодное положение по сравнению с конкурентами, например, Scikit-learn и PyTorch, поскольку работает поверх Tensorflow.
Также может работать на Microsoft Cognitive Toolkit, Theano или PlaidML. Предназначена для быстрых экспериментов с глубокими нейронными сетями, сосредоточена на удобстве, измеряемом качестве и расширяемости. Keras следует лучшим практикам для снижения когнитивной нагрузки: предлагает стабильные и базовые API-интерфейсы и ограничивает количество действий пользователя, необходимых для обычных случаев использования.
Matlab
Инструмент для создания приложений для обработки изображений, обычно используется в исследовательских целях, поскольку позволяет быстро создавать прототипы. Код Matlab очень лаконичен по сравнению с C ++, что упрощает детектирование и устранение неисправностей. Проводит предварительную проверку кода перед выполнением, предлагая несколько различных способов ускорить код.
OpenCV
Самая известная библиотека, многоплатформенная и простая в использовании. Охватывает все основные стратегии и алгоритмы для выполнения некоторых задач обработки изображений и видео, превосходно работает с C ++ и Python.
SimpleCV
Система для создания приложений компьютерного зрения. Предоставляет доступ к большому количеству инструментов компьютерного зрения, схожих с OpenCV, pygame и т. д. Не требует глубокого погружения в тему. Подходит для быстрого создания прототипов.
Tensorflow
Бесплатная библиотека с открытым исходным кодом для потоков данных и дифференциального программирования. Это символьная математическая библиотека, которая дополнительно используется для приложений машинного обучения, например, нейронных сетей. Известность быстро возросла и превзошла существующие библиотеки из-за простоты API.
Theano
Быстрая числовая библиотека Python, которая может работать на CPU или GPU. Она была создана группой LISA (в настоящее время MILA) в Монреальском университете в Канаде. Theano – это улучшенный компилятор для управления и оценки математических выражений, особенно матричных.
Датасеты
Механизмы поиска подходящего датасета
Датасет изображений или видео является основополагающим элементом для создания эффективно работающей модели компьютерного зрения. Как ответ потребностям сообщества разработчиков появились коллекции датасетов и инструменты поиска подходящего датасета. Ниже представлены некоторые из них:
Find Datasets|CMU Libraries
Коллекция датасетов, предоставленная университетом Карнеги Меллон.
Google Dataset Search
Позволяет осуществлять поиск по ключевому слову из 25 миллионов открытых датасетов. Наиболее популярным форматом данных являются таблицы – более 6 миллионов в Dataset Search.
Площадка для соревнований по машинному обучению с множеством интересных датасетов. В списке датасетов можно найти разные нишевые экземпляры.
NAS (Neural Architecture Search)
Алгоритм выбора архитектуры нейросети и оптимизации ее гиперпараметров под конкретный датасет и задачу (классификация, сегментация и др.). NAS является подмножеством AutoML. Алгоритм NAS находит архитектуру из всех возможных архитектур, следуя стратегии поиска, которая максимизирует производительность.
UCI Machine Learning Repository
Один из старейших источников датасетов в сети Интернет. Датасеты добавляются пользователями. Данные можно скачивать сразу, без регистрации
Датасеты для компьютерного зрения, разбитые по категориям. Доступен поиск.
Наиболее популярные датасеты для компьютерного зрения
AViD. Публичный датасет с анонимизированными видеозаписями из разных стран. Датасет предназначен для задачи распознавания действий. AViD состоит из видео, где человек выполняет одно действие (всего – 887).
CelebA-Spoof. Датасет для антиспуфинга, который состоит из 625 537 изображений 10 177 людей. Антиспуфинг лица – это методы борьбы с обманом систем по распознаванию лиц. Датасет включает в себя 43 атрибута: детали лица, освещение, среду и тип обмана. CelebA-Spoof создали на основе датасета CelebA. Изображения из CelebA модифицировали и аннотировали.
CIFAR-10 и CIFAR-100 (Canadian Institute For Advanced Research). Одни из наиболее популярных открытых датасетов, используемых исследователями для обучения алгоритмов машинного зрения. Состоят из 60 000 цветных изображений размером 32×32 (5 обучающих выборок, по 10 000 изображений в каждой и одна тестовая выборка, содержащая 10 000 изображений). При этом, в CIFAR-10 все изображения разделены на 10 классов (по 6000 изображений в каждом классе), а в CIFAR-100 – на 100 классов (по 600 изображений в каждом классе).
CINIC-10. Расширение CIFAR-10, содержит изображения из CIFAR-10 и набор изображений из базы данных ImageNet. Был скомпилирован как «мост» между CIFAR-10 и ImageNet для тестирования приложений машинного обучения. Изображения разделены на три группы: обучающая, проверочная и тестовая выборки (каждая из групп содержит 90 000 изображений).
COIL100. 100 разных объектов, изображённых под каждым углом в круговом обороте.
Google’s Open Images. Коллекция из 9 миллионов URL-адресов к изображениям, «которые были помечены метками, охватывающими более 6000 категорий» под лицензией Creative Commons.
Open Images V4. Одна из версий датасета Open Images. V4 содержит 14,6 миллиона границ объектов для объектов 600 классов.
Open Images V6. В последней версии датасета появились так называемые «локализованные нарративы» для 500 тысяч изображений. Это новый вид мультимодальной разметки, в которой синхронизированы текст аннотации, начитка и движения указателя мыши по описываемым предметам. Значительно расширены типы разметки визуальных взаимосвязей между объектами на изображениях (например, «человек катается на скейтборде», «собака ловит летящий диск»). Также добавлено 2,5 млн разметок человеческих действий («прыгает», «улыбается») и 23,5 млн меток изображений.
Hypersim. Датасет от Apple с фотореалистичными синтетическими изображениями интерьеров. Для каждого изображения доступны попиксельная разметка объектов и геометрия сцены. Датасет состоит из 77,4 тысяч изображений 461 сцены.
ImageNet. Датасет изображений для новых алгоритмов, организованный в соответствии с иерархией WordNet, в которой сотни и тысячи изображений представляют каждый узел иерархии. Состоит из более чем 15 миллионов размеченных высококачественных изображений, разделенных на 22 000 категорий.
ImageNet-A – это датасет с примерами изображений, которые нейросеть не может классифицировать верно. По результатам, модели предсказывали объекты из датасета с точностью в 3%, в то время как для стандартного ImageNet точность предсказаний составляла 97%. ImageNet-A был собран исследователями из University of Berkeley, University of Washington и University of Chicago.
Данные состоят из 7,5 тысяч изображений объектов, которые нейросети сложно классифицировать. Эти объекты – это «естественные состязательные примеры» для нейросетей. Особенность изображений в том, что они содержат естественные оптические иллюзии, которые нейросеть не может распознать.
Indoor Scene Recognition. Датасет для распознавания интерьера зданий. Содержит 15 620 изображений и 67 категорий.
Labelled Faces in the Wild. Набор из 13 000 размеченных изображений лиц людей для использования приложений, которые предполагают использование технологии распознавания лиц.
Labelme. Датасет состоит их 187 240 изображений, 62 197 изображений с аннотациями и 658 992 помеченных объекта. В LabelMe также есть инструмент для удобной аннотации изображения для создания датасетов.
LaSOT. Масштабный датасет для обучения и оценки моделей трекинга объектов. Датасет содержит 1,5 тысяч видеоклипов с объектами 85 разных классов. Всего в датасете более 3,87 миллионов кадров. Каждый клип содержит разметку для одного объекта. Границы объекта на кадрах размечали вручную.
LSUN. Датасет изображений, разбитых по сценам и категориям с частичной разметкой данных, содержит более 9 млн изображений.
MoGaze. Датасет с передвижениями тела и движениями взгляда. Датасет собирали для обучения моделей предсказания действия людей. Такие модели можно использовать в роботизированных системах, тесно взаимодействующих с людьми. Датасет включает в себя 180 минут данных движения с 1 627 действиями поднять-поставить.
MS COCO (Microsoft Common Objects in Context). Набор данных для обнаружения, сегментации, обнаружения ключевых точек и аннотаций. Набор данных состоит из 328 тысяч изображений с более чем 1,5 миллионов объектов на них. Все объекты находятся в их естественном окружении (контексте). Изображения, как правило, содержат объекты разных классов (только 10% имеют единственный класс). Все изображения сопровождаются аннотациями, хранящихся в json формате.
COCO-WholeBody. Первый датасет для оценки позы всего тела. COCO-WholeBody является расширением датасета COCO 2017 с теми же разбивками на тренировочную и валидационную выборки, как в COCO. Для каждого человека доступны 4 типа границ объектов: бокс человека, бокс лица, бокс левой руки и бокс правой руки. Кроме того, 133 ключевые точки: 17 для тела, 6 для ног, 68 для лица и 42 для рук. Датасет доступен исключительно для исследовательских целей. Коммерческое использование запрещено.
Visual Genome. Датасет с
100 тыс. изображений, каждое из которых имеет в среднем 35 объектов, 26 атрибутов и 21 парную связь между объектами.
xView. Один из самых больших общедоступных наборов воздушных снимков земли. Он содержит изображения различных сцен со всего мира, аннотированных с помощью ограничительных рамок. Состоит из более
1 миллиона экземпляров объектов 60 различных классов.
Алгоритмы и модели
Метод Виолы-Джонса (Viola–Jones object detection) – алгоритм, позволяющий обнаруживать объекты на изображениях в реальном времени. Его предложили Паул Виола и Майкл Джонс в 2001 году.
Основные принципы, на которых основан метод, таковы:
- используются изображения в интегральном представлении, что позволяет быстро вычислять необходимые объекты;
- используются признаки Хаара, с помощью которых происходит поиск нужного объекта (например, лица и его черт);
- используется бустинг (от англ. boost – улучшение, усиление) для выбора наиболее подходящих признаков для искомого объекта на данной части изображения;
- все признаки поступают на вход классификатора, который даёт результат «верно» либо «ложь»;
- используются каскады признаков для быстрого отбрасывания окон, где не найдено лицо.
Обучение классификаторов идет очень медленно, но результаты поиска лица очень быстры, именно поэтому данный метод часто используется для распознавания лиц на изображении.
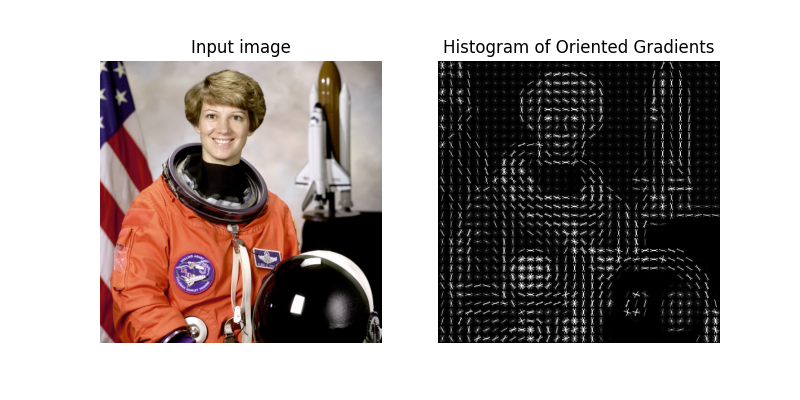
Гистограмма направленных градиентов (Histogram of Oriented Gradients, HOG) – дескрипторы особых точек, которые используются в компьютерном зрении и обработке изображений с целью распознавания объектов. Данная техника основана на подсчете количества направлений градиента в локальных областях изображения.
Основной идеей алгоритма является допущение, что внешний вид и форма объекта на участке изображения могут быть описаны распределением градиентов интенсивности или направлением краев. Реализация этих дескрипторов может быть произведена путём разделения изображения на маленькие связные области, именуемые ячейками, и расчетом для каждой ячейки гистограммы направлений градиентов или направлений краев для пикселей, находящихся внутри ячейки. Комбинация этих гистограмм и является дескриптором. Для увеличения точности локальные гистограммы подвергаются нормализации по контрасту. С этой целью вычисляется мера интенсивности на большем фрагменте изображения, который называется блоком, и полученное значение используется для нормализации. Нормализованные дескрипторы обладают лучшей инвариантностью по отношению к освещению.
Дескриптор HOG имеет несколько преимуществ над другими дескрипторами. Поскольку HOG работает локально, метод поддерживает инвариантность геометрических и фотометрических преобразований, за исключением ориентации объекта. Подобные изменения появятся только в больших фрагментах изображения. Более того, как обнаружили Далал и Триггс, грубое разбиение пространства, точное вычисление направлений и сильная локальная фотометрическая нормализация позволяют игнорировать движения пешеходов, если они поддерживают вертикальное положение тела. Дескриптор HOG, таким образом, является хорошим средством нахождения людей на изображениях.
Метод опорных векторов (SVM, support vector machine) – набор схожих алгоритмов обучения с учителем, использующихся для задач классификации и регрессионного анализа. Принадлежит семейству линейных классификаторов и может также рассматриваться как частный случай регуляризации по Тихонову. Особым свойством метода опорных векторов является непрерывное уменьшение эмпирической ошибки классификации и увеличение зазора, поэтому метод также известен как метод классификатора с максимальным зазором.
Основная идея метода – перевод исходных векторов в пространство более высокой размерности и поиск разделяющей гиперплоскости с максимальным зазором в этом пространстве. Две параллельных гиперплоскости строятся по обеим сторонам гиперплоскости, разделяющей классы. Разделяющей гиперплоскостью будет гиперплоскость, максимизирующая расстояние до двух параллельных гиперплоскостей. Алгоритм работает в предположении, что чем больше разница или расстояние между этими параллельными гиперплоскостями, тем меньше будет средняя ошибка классификатора.
AlexNet – первая глубокая сверточная нейронная сеть. Разработчики сети выиграли конкурс по классификации изображений LSVRC-2012 на наборе данных ImageNet.
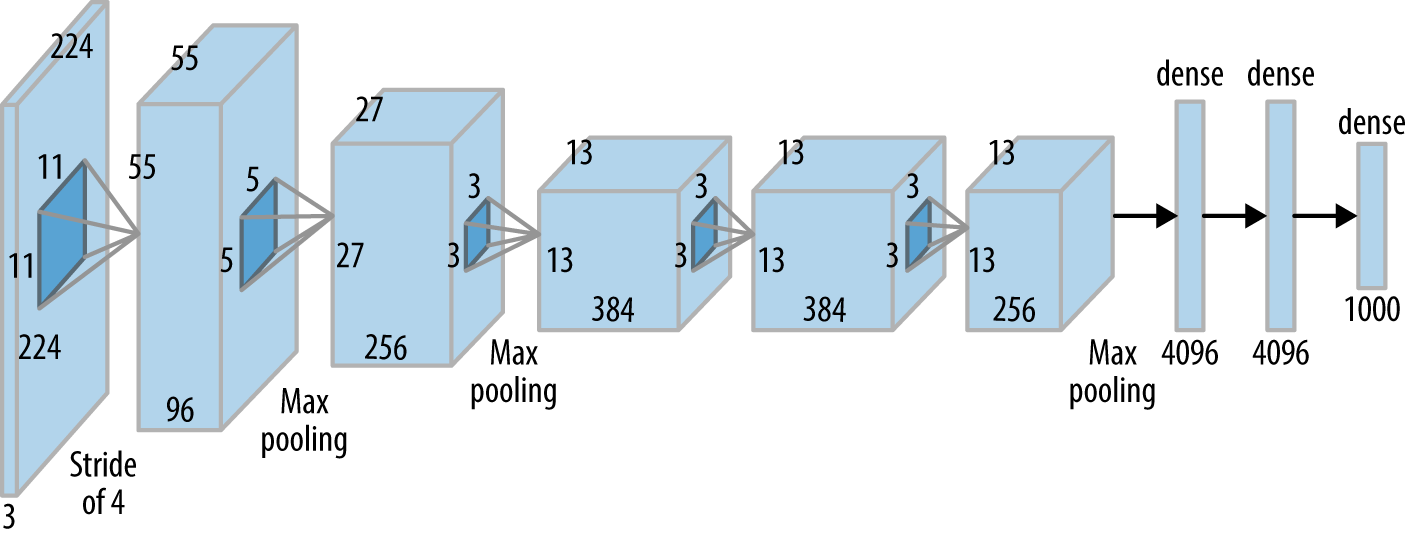
- Вход сети – трехканальное изображение 224х224 пикселя.
- В качестве функции активации используется «положительная срезка» (Rectified Linear Unit, ReLUФункция активации, определяемая как положительная часть ее аргумента). За счет этого при одинаковой точности метода скорость становится в 6 раз быстрее.
- Использование дропаута вместо регуляризации решает проблему переобучения. Однако время обучения удваивается с показателем дропаута 0,5.
- Использование слоев пространственного объединения с перекрытиями (overlapping pooling).
- Локальная нормализация выходов (Local Response Normalization, LRN) – нормализация выходных значений по размерности, соответствующей глубине выходной карты признаков.
- Сеть содержит 62,3 млн параметров.
- Прямой проход требует выполнения
- Высокая скорость обучения за счет использования функции активации ReLU.
- Увеличение количества данных (data augmentation) за счет применения операций сдвига и зеркального отражения.
- Обучение на двух видеокартах.
OverFeat – модель сверточной нейронной сети, которая предназначена для того, чтобы одновременно (т.е. одной сетью) решать три задачи: детектировать объект, классифицировать его и уточнять положение на снимке (detection, recognition, and localization).
Представляет собой многомасштабный алгоритм скользящего окна с использованием сверточных нейронных сетей.
Отличия от модели AlexNet:
- Отсутствие пространственного объединения с перекрытиями (замена размера ядра с 3×3 на 2×2).
- Отсутствие локальной нормализации выходов на первом и третьем слоях.
- Применение многомасштабной классификации изображения (multiscale classification).
- Объекты на изображении разного размера.
- Идея – классифицировать разные масштабы изображения и принимать интегральное решение.
- Используется 6 разных масштабов входного изображения, для которых строятся карты признаков (выход слоя 5).
Полученные карты признаков объединяются и передаются на вход классификатору, который формирует финальное решение о принадлежности изображения классу
VGG16 – модель сверточной нейронной сети, предложенная K. Simonyan и A. Zisserman из Оксфордского университета в статье «Very Deep Convolutional Networks for Large-Scale Image Recognition». Модель достигает точности 92.7% – топ-5, при тестировании на ImageNet в задаче распознавания объектов на изображении. Этот датасет состоит из более чем 14 миллионов изображений, принадлежащих к 1000 классам.
VGG16 – одна из самых знаменитых моделей, отправленных на соревнование ILSVRC-2014. Она является улучшенной версией AlexNet, в которой заменены большие фильтры (размера 11 и 5 в первом и втором сверточном слое, соответственно) на несколько фильтров размера 3х3, следующих один за другим. Сеть VGG16 обучалась на протяжении нескольких недель при использовании видеокарт NVIDIA TITAN BLACK.
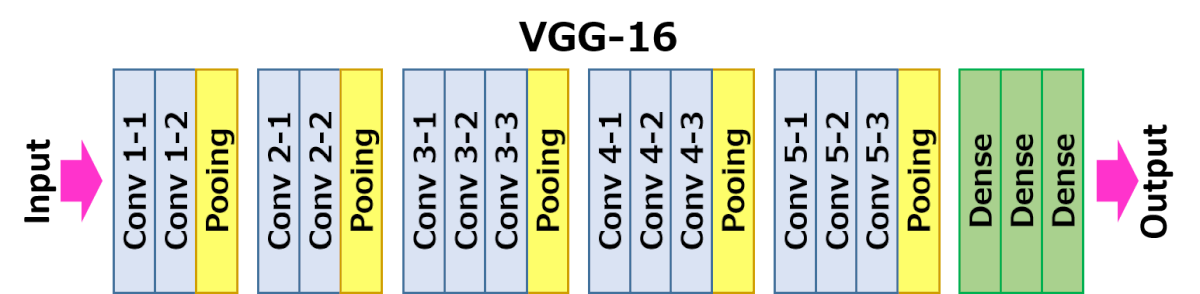
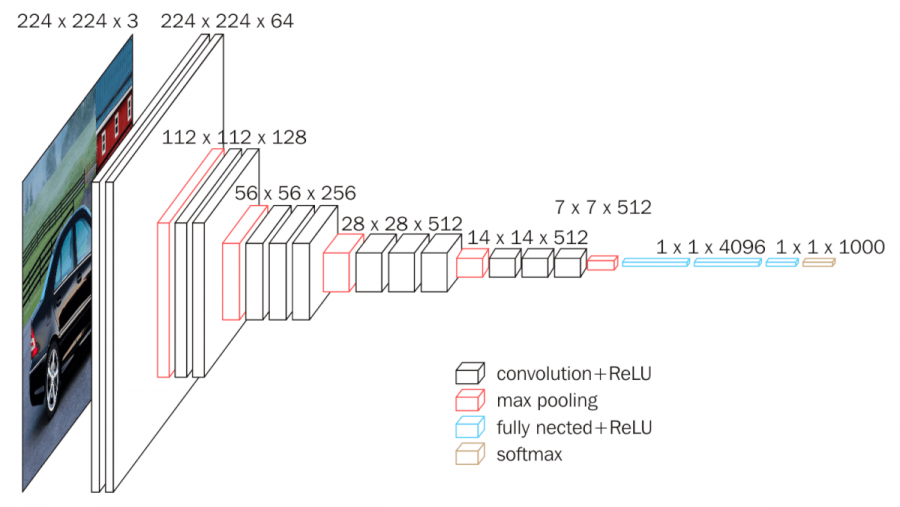
На вход слоя conv1 подаются RGB изображения размера 224х224. Далее изображения проходят через стек сверточных слоев, в которых используются фильтры с очень маленьким рецептивным полем размера 3х3 (который является наименьшим размером для получения представления о том, где находится право/лево, верх/низ, центр).
В одной из конфигураций используется сверточный фильтр размера 1х1, который может быть представлен как линейная трансформация входных каналов (с последующей нелинейностью). Сверточный шаг фиксируется на значении 1 пиксель. Пространственное дополнение входа сверточного слоя выбирается таким образом, чтобы пространственное разрешение сохранялось после свертки, то есть дополнение равно 1 для 3х3 сверточных слоев. Пространственный пулинг осуществляется при помощи пяти max-pooling слоев, которые следуют за одним из сверточных слоев (не все сверточные слои имеют последующие max-pooling). Операция max-pooling выполняется на окне размера 2х2 пикселей с шагом 2.
После стека сверточных слоев (который имеет разную глубину в разных архитектурах) идут три полносвязных слоя: первые два имеют по 4096 каналов, третий – 1000 каналов (так как в соревновании ILSVRC 3 Проект ILSVRC (ImageNet Large Scale Visual Recognition Challenge, Кампания по широкомасштабному распознаванию образов в ImageNet) различные программные продукты ежегодно соревнуются в классификации и распознавании объектов и сцен в базе данных ImageNet, ведётся c 2010 года. требуется классифицировать объекты по 1000 категорий; следовательно, классу соответствует один канал). Последним идет soft-max слой. Конфигурация полносвязных слоев одна и та же во всех нейросетях.
Все скрытые слои снабжены ReLU. Отметим также, что сети (за исключением одной) не содержат слоя нормализации (Local Response Normalisation), так как нормализация не улучшает результата на датасете ILSVRC, а ведет к увеличению потребления памяти и времени исполнения кода.
Сеть VGG имеет два серьезных недостатка:
- Очень медленная скорость обучения.
- Сама архитектура сети весит слишком много (что создает проблемы с диском и пропускной способностью).
Из-за глубины и количества полносвязных узлов VGG16 весит более 533 МБ. Это осложняет процесс развертывания VGG. Хотя VGG16 и используется для решения многих проблем классификации при помощи нейронных сетей, меньшие архитектуры более предпочтительны (SqueezeNet, GoogLeNet и другие). Несмотря на недостатки, данная архитектура удобна для обучения, так как её легко реализовать.
SEER – это самообучающаяся нейросеть с миллиардом параметров от FAIR для задач компьютерного зрения. Предобученную на снимках из Instagram модель можно дообучать на своих задачах. Разработчики опубликовали библиотеку VISSL для обучения SEER модели.
SEER объединяет в себе архитектуру RegNet и формат онлайн самостоятельного обучения. В качестве алгоритма для онлайн обучения использовали SwAV. RegNet, в свою очередь, – это масштабируемая сверточная нейросеть, которая позволяет обходить ограничения по времени обучения и памяти. Такая комбинация позволяет SEER масштабироваться до миллиардов параметров и обучающих изображений.
После предобучения на миллиарде случайных, неразмеченных изображений из Instagram SEER обошла большинство наиболее прогрессивных самообучаемых моделей. По результатам экспериментов, максимальная точность предсказаний нейросети составила 84,2% на датасете ImageNet.
SEER также обошла наиболее успешные на данный момент подходы обучения с учителем на таких задачах, как low-shot (изучение концепций через малое количество примеров), детектирование объектов, сегментация и классификация изображений.
Если использовать для обучения 10% изображений из ImageNet, максимальная точность SEER составляет 77,9% для всего ImageNet. Если обучать нейросеть на 1% размеченных изображений из ImageNet, точность составит 60,5%.
Результаты SEER показывают, что формат самостоятельного обучения подходит и для задач компьютерного зрения.
NBDT (Neural-Backed Decision Trees, NBDTs) – это нейросетевая архитектура деревьев решений для задач классификации. Модель объединяет в себе интерпретируемость классического алгоритма дерева решений с качеством предсказаний современных нейросетей. Разработчики тестировали модель на задаче классификации изображений.
NBDTs заменяют последний слой нейросети дифференцируемой последовательностью решений с особой функцией потерь. Это позволяет модели выучивать высокоуровневые концепты и снижает нестабильность предсказаний. В отличие от стандартной нейросети, NBDT выдает последовательные решения, которые привели к предсказанию.
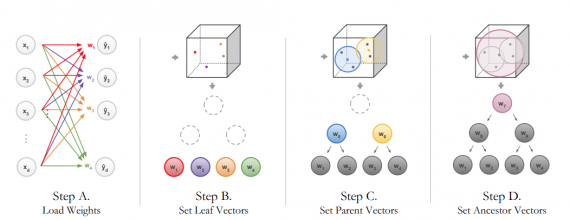
Процесс обучения итогового слоя модели
Модель находится в препринте, публикация планируется в мае 2021, но согласно сравнению разработчиков, результаты работы модели близки к наиболее успешным в настоящий момент подходам на датасетах CIFAR и ImageNet.
YOLO (You Only Look Once) – это семейство моделей, которые стали популярны благодаря легковесности и качеству предсказаний. Такие характеристики позволяю использовать YOLO для задач распознавания объектов в реальном времени и на портативных устройствах.
YOLO – это система обнаружения объектов в реальном времени, созданная Джозефом Редмоном и Али Фархади из Вашингтонского университета. Их алгоритм применяет нейронную сеть ко всему изображению, а нейронная сеть разделяет изображение на сетку и запечатлевает районы с обнаруженными элементами.
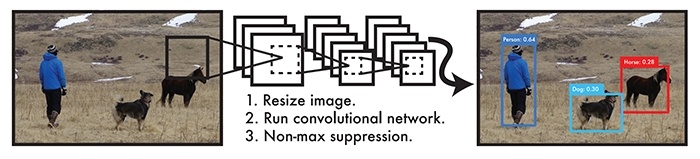
Scaled YOLO v4 на датасете Microsoft COCO достигает точности 55,8%, что делает ее одной из самых точных нейронных сетей для обнаружения объектов. Scaled YOLO v4 превосходит по точности нейронные сети: Google; Amazon; Microsoft; Facebook.
Faster R-CNN разработан на основе R-CNN и следующей ее версии Fast R-CNN, где для локализации объекта вместо избирательного поиска используется Region Proposal Networks (сеть позволяет генерировать предлагаемые регионы нахождения объектов на основе последней сверточной карты признаков). Архитектура Faster R-CNN образована следующим образом:
Изображение подается на вход сверточной нейронной сети. Так, формируется карта признаков. Карта признаков обрабатывается слоем RPN. Здесь скользящее окно проходится по карте признаков. Центр скользящего окна связан с центром якорей. Якоря – это области, имеющие разные соотношения сторон и разные размеры. Авторы используют 3 соотношения сторон и 3 размера. На основе метрики IoF (intersection-over-union), степени пересечения якорей и истинных размеченных прямоугольников, выносится решение о текущем регионе – есть объект или нет. Далее используется алгоритм FastCNN: карта признаков с полученными объектами передаются слою RoI с последующей обработкой полносвязных слоев и классификацией, а также с определением смещения регионов потенциальных объектов.
Модель Faster R-CNN справляется немного хуже с локализацией, но работает быстрее Fast R-CNN.
На TensorFlow 4 Открытая программная библиотека для машинного обучения, поддерживаемая Google. tensorflow.org есть ряд предобученных моделей, использующих данный метод.
ResNet (Residual Network, «остаточная сеть») – модель глубокой нейронной сети для классификации изображений. Создана Microsoft, чтобы преодолеть проблему снижения точности предсказаний с увеличением количества слоев в нейронных сетях.
Microsoft ввела глубокую «остаточную» структуру обучения. Вместо того, чтобы надеяться на то, что каждые несколько упорядоченных слоев непосредственно соответствуют желаемому основному представлению, они явно позволяют этим слоям соответствовать «остаточному». Формулировка F(x) + x может быть реализована с помощью нейронных сетей с соединениями для быстрого доступа.

Идентификационные быстрые соединения F (x
- Быстрое соединение выполняет сопоставление идентификаторов с дополнительными нулями, добавленными для увеличения размерности. Эта опция не вводит никаких дополнительных параметров.
- Проекция быстрого соединения в F (x
+ x) используется для сопоставления размерностей (выполнено с помощью 1×1 сверток).
Соединения быстрого доступа (shortcut connections) пропускают один или несколько слоев и выполняют сопоставление идентификаторов. Их выходы добавляются к выходам упорядоченных слоев. Используя ResNet, можно решить множество проблем, таких как:
- ResNet относительно легко оптимизировать: «простые» сети (которые просто складывают слои) показывают большую ошибку обучения, когда глубина увеличивается.
- ResNet позволяет относительно легко увеличить точность благодаря увеличению глубины, чего с другими сетями добиться сложнее.
EfficientNets – класс моделей, цель разработки которых сохранить высокое качество решения задачи и повысить эффективность модели (уменьшить количество параметров и снизить вычислительную сложность)
При правильном конструировании моделей масштабирование по любому размеру сети (глубина, разрешение входного изображения, ширина – количество каналов в картах признаков) приводит к повышению качества решения задачи
Важно сбалансировать все размеры сети (глубину, разрешение и ширину) во время масштабирования сети для получения высокой точности и эффективности.
Авторы предлагают метод составного масштабирования модели (compound scaling method). Вводится составной коэффициент ? для равномерного масштабирования глубины, ширины и разрешения
EfficientNet-B0 – базовая нейронная сеть, построенная с использованием инвертированных остаточных блоков, которые введены в MobileNetV2.
EfficientNet-B1,…,B7 получены в результате поиска оптимального соотношения параметров глубины, ширины и разрешения с использованием предложенного метода масштабирования.
Meta Pseudo Labels (EfficientNet-L2). Для обучения модели EfficientNet использовался полу-контролируемый метод Meta Pseudo Labels (MPL). Одна сеть EfficientNet-L2 используется в таком случае в качестве учителя, а вторая – ученика. Учителем генерируются псевдо-метки на неразмеченных изображениях из датасета, которые затем смешиваются с правильно размеченными данными для формирования обучающей выборки.
В процессе обучения учитель получает сигналы о том, насколько хорошо ученик выполняет мини-пакет, взятый из помеченного набора данных. После чего может изменять метки с целью лучшего обучения.
Полученная сеть достигает максимальной точности 90,2% по проверочному набору ImageNet ILSVRC 2012, став лучшей сетью для классификации изображений на данном датасете.
U-Net считается одной из стандартных архитектур сверточных нейронных сетей для задач сегментации изображений, когда нужно не только определить класс изображения целиком, но и сегментировать его области по классу, т. е. создать маску, которая будет разделять изображение на несколько классов. Архитектура состоит из стягивающего пути для захвата контекста и симметричного расширяющегося пути, который позволяет осуществить точную локализацию. Сегментация изображения 512×512 занимает менее секунды на современном графическом процессоре.
Для U-Net характерно:
- достижение высоких результатов в различных реальных задачах, особенно для биомедицинских приложений;
- использование небольшого количества данных для достижения хороших результатов.
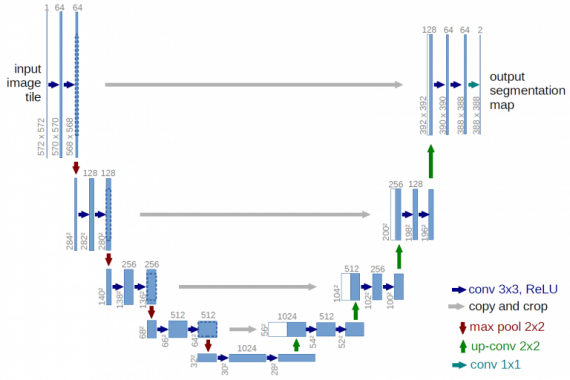
Архитектура U-Net (пример изображения с разрешением 32×32 пикселя – самым низким). Каждый синий квадрат соответствует многоканальной карте свойств. Количество каналов приведено в верхней части квадрата. Размер x-y приведен в нижнем левом краю квадрата. Белые квадраты представляют собой копии карты свойств. Стрелки обозначают различные операции.
Архитектура сети приведена на рисунке. Она состоит из сужающегося пути (слева) и расширяющегося пути (справа). Сужающийся путь – типичная архитектура сверточной нейронной сети. Он состоит из повторного применения двух сверток 3×3, за которыми следуют инит ReLU и операция максимального объединения (2×2 степени 2) для понижения разрешения.
На каждом этапе понижающей дискретизации каналы свойств удваиваются. Каждый шаг в расширяющемся пути состоит из операции повышающей дискретизации карты свойств, за которой следуют:
- свертка 2×2, которая уменьшает количество каналов свойств;
- объединение с соответствующим образом обрезанной картой свойств из стягивающегося пути;
- две 3×3 свертки, за которыми следует ReLU.
Обрезка необходима из-за потери граничных пикселей при каждой свертке.
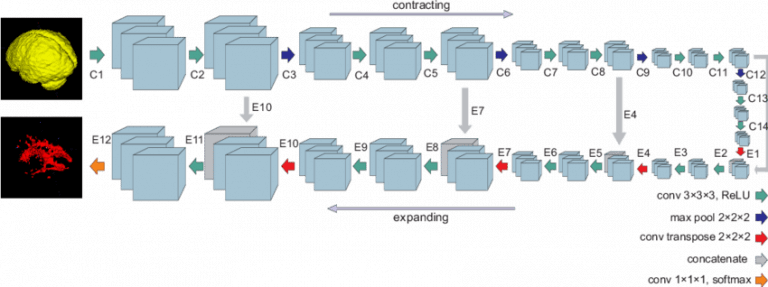
На последнем слое используется свертка 1×1 для сопоставления каждого 64-компонентного вектора свойств с желаемым количеством классов. Всего сеть содержит 23 сверточных слоя.
Архитектура U-Net достигает выдающейся производительности и точности в самых разных приложениях биомедицинской сегментации. Метод требует лишь нескольких помеченных изображений для тренировки и имеет приемлемое время обучения: всего лишь 10 часов на графическом процессоре NVidia Titan (6 ГБ).
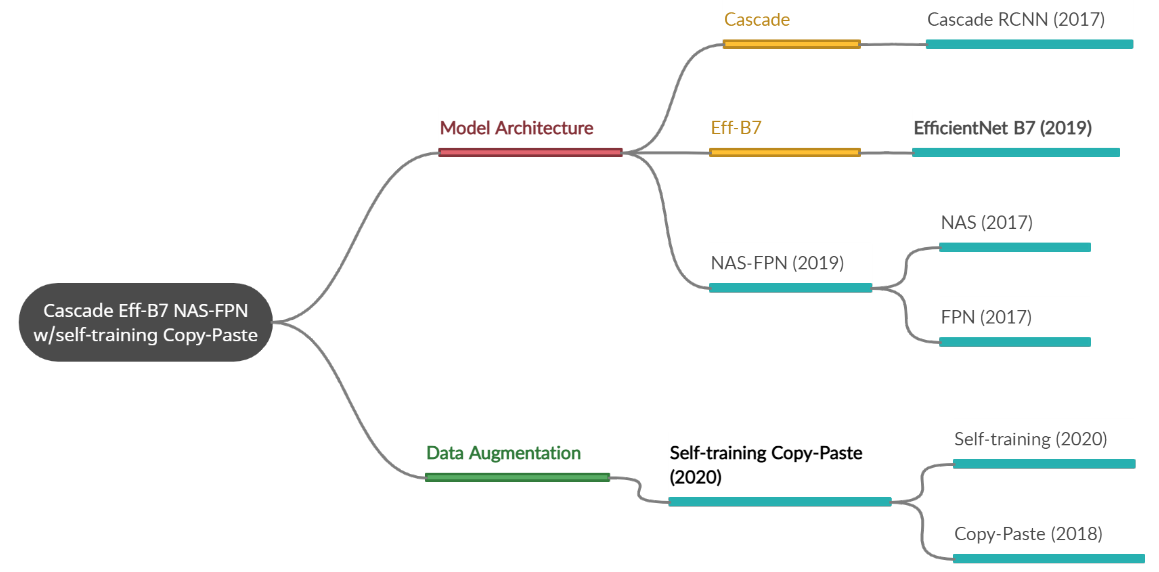
Cascade Eff-B7 NAS-FPN with Self-training and Copy-Paste – модель обнаружения объектов, основанная на нескольких методах сразу. Так, с помощью случайно вставки изображений в исходные данные была улучшена работа базовых моделей нейронных сетей, а использование в дополнение к данному методу псведо-маркировки для обучения модели позволило значительно улучшить выходные предсказания.
Данная модель на датасете Microsoft COCO достигает точности 57%, что делает ее самой точной нейронной сетью для обнаружения объектов (данные – март 2021).
Все использованные методы для создания модели были представлены автором на рисунке и условно разделены на две части: изменения данных и архитектурная модель.
LambdaNetworks – это нейросетевая архитектура, которая способна захватывать длительные зависимости между входными данными и контекстуальной информацией. Например, пиксель, окруженный другими пикселями. Итоговая архитектура LambdaNetwork требует меньше вычислительных ресурсов и является простой в имплементации в сравнении с альтернативными подходами.
Ключевая особенность структуры сети – это лямбда слой, который учитывает такие зависимости с помощью трансформации доступных контекстов в линейные функции (лямбды). Затем лямбды применяются к каждому входному объекту по отдельности. Лямбда слои могут быть имплементированы в модели для глобальных, локальных и маскированных контекстов.
Линейные функции противопоставляются картам внимания, которые повсеместно используются в наиболее прогрессивных нейросетевых архитектурах. Карты внимания являются дорогими для вычисления.
Исследователи проводили эксперименты на трех задачах: классификации изображений на данных ImageNet и распознавание объектов и сегментация сущностей на данных COCO. LambdaNetworks обходят сверточные архитектуры и архитектуры с механизмом внимания. При этом предложенные модели более вычислительно эффективны.
LambdaResNets – это семейство LambdaNetworks моделей, которые адаптированы под задачу классификации изображений. LambdaResNets выдают предсказания, сравнимые с наиболее успешных в настоящее время моделями на ImageNet, при том, что обучаются в 4,5 раза быстрее EfficientNets.
Компании и проекты
Иностранные компании
Facial Detection – распознавание лиц.
Landmark Detection – распознавание геолокации по фото.
Logo Detection – детектирование символов.
Image Properties – детекция отдельных атрибутов изображения.
Perception – технология понимания сенсорных данных, внедряемая во все продукты компании, включающая распознавание изображений в Google Фото, улучшение качества фото с камеры Pixel Phone, интерфейсы рукописного ввода Android, оптическое распознавание символов в Google Drive, понимание видео YouTube, Google Cloud, Google Фото и Nest, а также компьютерное зрение для мобильных приложений, таких как Motion Stills, PhotoScan и Allo.
ResNeXt – простая высокомодульная сетевая архитектура для классификации изображений.
Алгоритмы машинного зрения используются в Facebook для фильтрации нежелательного контента, в том числе видеоконтента, выявления фейковых фотографий, актуализации и кастомизации рекламы.
Многие возможности Instagram (фильтры, маски, быстрое редактирование фотографий и сториз) обусловлены алгоритмами машинного зрения.
Bing image recognition – в поисковике Bing от Microsoft используются алгоритмы компьютерного зрения.
NVIDIA DeepStream – платформа для быстрого анализа видеопотоков в реальном времени.
Amazon 13 Go – магазины Amazon, в которых покупатели сканируют на входе свои смартфоны, берут с полок товары и выходят из магазина. Покупка оплачивается автоматически, а чек формируется на основе информации, полученной с камер магазина и обработанной алгоритмами компьютерного зрения.
Дроны Amazon, предназначенные для доставки товаров.
Системы умного дома Amazon – комплексные решения, включающие дверные звонки с камерами.
Megvii Technology Limited
Brain++ – платформа для тренировки моделей, основанных на глубоком обучении.
- Системы для автономных автомобилей (обнаружение пешеходов, автотранспортных средств и неавтомобилей).
- Системы для анализа видеоконтента.
- Анализ медицинских изображений
SensePosture – технология оценки поз (pose estimation). Осуществляет высокоскоростной трекинг движений человека по 17 3D-координатам. Применяется в дополненной и виртуальной реальности.
Анализ медицинских снимков.
Автономный транспорт – компания активно разрабатывает данное направление, планируя использовать беспилотные автомобили для доставки продукции. Тестирование беспилотных транспортных средств проводятся в городе Ханчжоу, средняя скорость движения составляет на данный момент 30-40 км/ч, грузоподъемность – до нескольких тонн.
PaddleDetection – высокопроизводительный инструментарий обнаружения объектов.
Умные камеры – камеры, соединенные с серверами обработки визуальной информации, используемые для автоматического мониторинга охраняемых объектов.
Роботы-аватары – роботизированные системы с портативной камерой и экраном, применяющиеся для дистанционной коммуникации.
Система распознавания лиц DeepGlint широко используется полицией Китая. Также совместно с Hyundai внедряется в автомобили для биометрического распознавания водителей и анализа моделей поведения в процессе вождения.
Российские компании
Сервис Yandex Vision включает в себя технологии OCR (Optical Character Recognition), автоматическую модерацию контента и определение присутствия человека
Поиск по изображению – по многим оценкам, поиск Яндекса по картинке является лучшим в мире, обходя по качеству поиски Google, Bing и Baidu.
LUNA PLATFORM – система управления биометрическими данными, которая может решать разнообразные задачи с помощью функции распознавания лиц – например, распознавание клиента банка, идентификация сотрудников офиса при входе в здание и т.д.
Архитектура сервиса позволяет подключать практически неограниченное количество видеокамер и серверов.
VOCORD Tahion – ПО для создания систем видеонаблюдения и видеоаналитики любого масштаба.
- распознавание клиентов с применением биометрии лица;
- анализ аудитории – пол, возраст, эмоции;
- мерчендайзинг – определение товаров, определение пустот, определение нарушений;
- мониторинг очередей.
- открытие дверей с применением биометрии лица;
- открытие шлагбаумов с применением OCR номеров;
- создание черных, белых списков;
- поиск сотрудника/посетителя по фотографии, контуру;
- мониторинг учета рабочего времени.
- распознавание типов документов (паспорт, ИНН, СНИЛС и другое);
- распознавание текста.
- распознавание сотрудника с применением лицевой биометрии;
- распознавание наличия средств индивидуальной защиты;
- оповещение при несоблюдении требований индивидуальной защиты;
- мониторинг учета рабочего времени;
- мониторинг износа оборудования;
- распознавание производственных дефектов.
Основное направление – распознавание лиц. Чаще всего лицензируется в форме SDK, иногда в виде веб-системы, реже – в виде кастомизированного решения на основе SDK.
ABBYY Mobile Capture – универсальный инструмент для разработчика, который позволяет встраивать в мобильные приложения и клиенты функции автоматического захвата изображений документов и распознавания текста.
ABBYY FlexiCapture – универсальная платформа для интеллектуальной обработки информации.
ABBYY FineReader Server – корпоративное серверное решение для распознавания, хранения и преобразования файлов в PDF и другие электронные редактируемые форматы.
Face SDK – ПО для распознавания лиц.
Seemetrix – видеоаналитика для рекламных дисплеев.
Мультибиометрическая платформа НейроАМБИС, с элементами искусственного интеллекта.
Что такое компьютерное зрение и где его применяют

Об эксперте: Роман Коновалов, президент группы компаний «СиДиСи».
Компьютерное зрение (Computer Vision, CV) — это область искусственного интеллекта, связанная с анализом изображений и видео. Она включает в себя набор методов, которые наделяют компьютер способностью «видеть» и извлекать информацию из увиденного.
Системы состоят из фото- или видеокамеры и специализированного программного обеспечения, которое идентифицирует и классифицирует объекты. Они способны анализировать образы (фотографии, картинки, видео, штрих-коды), а также лица и эмоции.
Чтобы научить компьютер «видеть», используются технологии машинного обучения. Собирается множество данных, которые позволяют выделить признаки и комбинации признаков для дальнейшей идентификации похожих объектов.
По данным исследования TAdviser, с 2018 по 2023 год объем отечественного рынка решений в этой сфере увеличится в пять раз до 38 млрд рублей. Наибольшую долю в нем занимают решения в области видеонаблюдения и безопасности — 32%, промышленности — 17%, медицины — 14%, торговли — 10%.
Для чего бизнесу компьютерное зрение?
- Безопасность. Практически во всех сферах применимы системы контроля доступа на основе распознавания лиц: от бизнес-центров и офисов компаний до банков и ресторанов.
- Сервис. За счет быстрой идентификации по лицу можно сократить время обслуживания клиента и предложить персональные услуги.
- Усиление человеческих возможностей. Компьютерное зрение позволяет увидеть то, что человек может не заметить. Особенно актуально это в медицине (анализ рентгеновских и других снимков) и промышленности (обнаружение брака).
- Сокращение времени на рутинные задачи. Распознавание, как правило, занимает несколько секунд.Человек будет рассматривать полку в магазине на предмет правильности выкладки товаров намного дольше.
- Автономность. Без компьютерного зрения невозможно развитие беспилотного транспорта и роботов.
В чем проблема?
Для дальнейшего распространения систем компьютерного зрения в бизнес-среде разработчики решают проблему быстродействия и стабильности систем.
Сейчас камеры передают данные на сервер, где с помощью специального ПО происходит распознавание. Системе нужен постоянный доступ к высокоскоростному интернету. Передача данных на сервер замедляет процесс. Проблемы с Сетью вообще останавливают его.
Поэтому появляются автономные решения. Например, резидент «Сколково», компания «ИРЦЭ», совместно с ГК «СиДиСи» разработали «ядро», способное распознавать образы прямо в мобильном устройстве без обмена информацией с серверами. При этом точность распознавания доведена до 98%. На основе этого «движка» может быть создано решение для разных отраслей и целей.
Главные тренды последних лет в компьютерном зрении
На конференции OpenTalks AI, посвященной искусственному интеллекту, эксперты обозначили главные тренды в CV:
- На первый план выходят генеративно-состязательные модели нейросетей. Такие, как GAN — это генеративно-состязательная нейросеть, которая состоит из генератора и дискриминатора. Ян Лекун, директор Facebook по исследованиям искусственного интеллекта, назвал ее «самой интересной идеей в машинном обучении за последние десять лет». Генераторы в GAN генерирует входные данные, а дискриминаторы оценивают их подлинность и классифицируют по категориям, используя определенный набор признаков.
- Развитие генеративно-состязательных сетей позволило совершить качественный скачок в распознавании и генерации человеческих лиц. Те же GAN создают максимально реалистичные изображения, которые неотличимы от реальных фото или живописи. Правда, с изображениями животных дела пока обстоят намного хуже.
- Помимо статичных изображений все большее распространение получают нейроаватары — движущиеся изображения на основе 1-32 фото, таймплампсы на основе фото пейзажа и моделирование 3D-сцен на основе панорамных фотографий. Следующий шаг — анимирование фотографий с помощью специальных алгоритмов.
Что такое моделирование 3D сцен?
Еще в 2009 году Дэвид Маккиннон из Технологического университета в Квинсленде (Австралия) разработал программу 3DSee, которая генерирует 3D-модели на основе 5-15 фотографий. Важное условие: все фотографии должны пересекаться как минимум на 80-90%. На разработку у Маккиннона ушло восемь лет. Следующий шаг — автоматическая генерация 3D-моделей в высоком разрешении, как в сцене с пулями из «Матрицы».
Создание 3D-сцен востребовано в строительстве, дизайне интерьера, военном деле, анимации. В Голливуде уже используют эту технологию, чтобы с точностью воспроизвести освещение, расположение актеров и декораций — для экономии средств на технически сложных съемках. Производители обучают на таких 3D-моделях роботов, которым нужно передвигаться в пространстве по определенному маршруту и преодолевать препятствия. 3D-сканеры подходят для аутентификации личности, виртуальной примерки одежды и многих других вещей. Уже сейчас с помощью смартфона можно отснять человека с разных ракурсов и получить 3D-аватар.
Виктор Лемпицкий, глава Samsung AI Center, профессор Skoltech, в своем докладе на OpenTalks AI отметил, что именно моделирование 3D-сцен было в центре внимания специалистов по CV в 2020 году. Пока что нейросетям сложно в деталях воспроизводить некоторые текстуры — такие, как листва деревьев или прическа — и создавать полноценные модели в 360°. Но в ближайшем будущем они заменят 3D-дизайнеров и аниматоров: смогут сами создавать рендеры зданий и интерьеров, анимированные презентации и VR-симуляции объектов. К примеру, технология NeRF от Google уже генерирует реалистичные объемные изображения, которые используют для создания AR и VR-среды.
Поиск плагиата при помощи компьютерного зрения
С помощью алгоритма Eora Mage можно за пять секунд найти похожий логотип. Это удобно, если вы только выбираете изображение и не хотите: чтобы кто-то из конкурентов подал на вас в суд.
Технологию использует в своей работе патентное бюро «Интэлс», которое регистрирует логотипы и товарные знаки. На этапе регистрации специалистам нужно убедиться, что такой товарный знак еще не регистрировали, и у клиента не будет юридических проблем. Раньше патентовед почти месяц вручную перебирал всю базу и готовил отчет, куда включал до 100 похожих изображений. Теперь на это уходят секунды, а точность алгоритма — от 80%.

Компьютерное зрение в ретейле: умные весы и оплата улыбкой
Поставщики товаров в крупные торговые сети начали снабжать мерчендайзеров планшетами со специальным ПО для распознавания фотографий. Вместо того чтобы проверять наличие товаров, его расстановку и актуальность ценников вручную, торговый представитель просто фотографирует полку. Система сравнивает ее с планограммой и выдает рекомендации: какого товара не хватает, что стоит не на своем месте, где перепутаны ценники или не указана текущая акция. Анализируя полки конкурентов, система мониторит долю полки в динамике.
Например, корпорация Mars реализовала пилотный проект внедрения такой системы в своем подразделении в Казахстане. По итогам пилота принято решение о масштабировании проекта еще в десяти странах присутствия компании.
Запущены пилотные проекты в России, когда системы распознавания и видеоаналитики используются для анализа посещаемости торговых точек, перемещения покупателей, среднего времени пребывания в очереди. Это позволяет оптимизировать рабочий график персонала и сделать пребывание в магазине более комфортным, а обслуживание — быстрым.
В апреле этого года X5 Retail Group объявила о разработке «умных весов», которые с помощью технологии компьютерного зрения идентифицируют товар при взвешивании на кассе. Ритейлер планирует установить 500 таких весов в 100 магазинах сети «Пятерочка». Инновация должна ускорить обслуживание покупателей на кассах.
Платить за покупку улыбкой, выявлять недовольных обслуживанием клиентов, таргетировать рекламу в торговом зале исходя из возраста и пола человека, примерять вещи в виртуальной примерочной — такие проекты уже есть. Пока единичные, но в перспективе пяти-десяти лет они станут повсеместными.
Например, платежная система Alipay начала тестировать систему оплаты на основе компьютерного зрения в 2017 году, реализовав пилотный проект в одном из китайских ресторанов KFC. И теперь в Китае оплата «улыбкой» не является чем-то сверхъестественным, а в борьбу за этот рынок вступила платежная система WeChat Pay. Оплатить покупки, просто улыбнувшись в камеру у кассы, можно в супермаркетах CP Lotus в Пекине и сотнях других магазинов по всей стране.
Международная сеть WalMart тестировала систему, которая при обнаружении покупателя с несчастным лицом оповещала об этом сотрудников магазина. Два года назад эксперимент с распознаванием эмоций покупателей провели в «ДоДо-Пицца». Это позволило компании оценить качество работы сотрудников, мотивировать их «собирать улыбки».
Компьютерное зрение в промышленности: надень каску!
Кроме систем контроля доступа технологии распознавания используются для обеспечения безопасности работников. Например, системы видеоаналитики следят за ношением средств индивидуальной защиты на опасных производствах: если на человеке нет каски, маски, перчаток, яркого жилета, он получает уведомление. Сигнал отправляется и его руководству.
На пультах центрального управления, где важно соблюдать высокий уровень концентрации и не отвлекаться, системы распознавания лиц следят за состоянием специалистов. Если у человека снижается внимание или он засыпает, пользуется телефоном или отходит от своего поста, он и вся команда получают предупреждение.
CV-технологии начинают применяться для контроля качества производимых изделий: видят дефекты, помогая на ранней стадии отсеять брак, проверяют размеры, определяют верные расстояния, считывают маркировку компонентов при сборке на конвейере. Экономия достигается за счет минимизации ошибок и брака.

Компьютерное зрение в финансах: получить кредит лицом
Благодаря компьютерному зрению лицо становится новым ID человека. В том числе для получения финансовых услуг. Пока бумажный паспорт никто не отменял, но идентификация по лицу позволяет обеспечить 100% защиты от мошенников, предъявляющих чужой документ.
Развивается технология подтверждения лицом операций в мобильном приложении. Системами распознавания скоро будут оборудованы и банкоматы.
Компьютерное зрение в медицине: окровавленные губки
Компьютерное зрение становится виртуальным помощником врача. Технологии анализируют медицинские изображения — рентгеновские снимки, МРТ и УЗИ, помогая повысить точность диагностики заболеваний. Например, проект Microsoft InnerEye помогает быстро и точно найти опухоли на снимках МРТ. Компания из Калифорнии Gauss Surgical разработала систему, позволяющую принимать решения о необходимости переливания крови: она анализируют ее потерю по наполняемости хирургических губок во время операции или во время родов. Разработка также ведет учет губок для того, чтобы врач случайно не забыл их внутри (такое происходит в одной из 5,5 тыс. операций, по данным компании).
Без компьютерного зрения не смогут «работать» и роботы-хирурги, которые скоро выйдут во многие операционные. Эпидемия коронавируса уже стала толчком для развития телемедицины. Здесь системы распознавания помогут провести первичную диагностику некоторых заболеваний по фотографии.
Нейросетевые алгоритмы также помогают улучшить качество снимков рентгена и КТ, убрав лишние шумы и искажения. Это позволяет пациентам меньше времени находиться в аппарате и снизить дозу облучения до 25% от обычной. В будущем компьютеры на базе ИИ смогут полностью заменить КТ и рентген-аппараты, чтобы сразу получать высококачественные снимки с минимальной дозой облучения. Для так называемого НДКТ-скрининга достаточно и 10% данных от КТ. Такие технологии применяют в Philips и компании «Третье Мнение» при разработке ИИ-решений для медицины.
Компьютерное зрение в смартфонах
В современных моделях смартфонов используют технологии, которые помогают обрабатывать изображение еще в процессе съемки. Среди них — LiDAR в iPhone, суперзум в Huawei или Pixel в Google. Специальные алгоритмы делают несколько снимков, сопоставляют их и выводят идеальное по цвету и качеству изображение. При этом они рассчитывают световые потоки, строят объемные модели и производят другие вычисления на базе компьютерного зрения. С помощью камеры смартфона можно даже создать 3D-модель пространства, предмета или человека.
Однако это не единственное, на что способно CV. В Google создали приложение для смартфона Project Guideline, позволяющее слепым заниматься бегом. Оно работает на Android и iOS, озвучивает подсказки, текст и изображения, а также поддерживает голосовой ввод. Так приложение помогает бегуну понять, что за объекты его окружают и как ему строить свой маршрут. Оно даже распознает эмоции на лицах людей, которые встречаются на пути.
Computer Vision: A Study On Different CNN Architectures and their Applications

Humans are heavily dependent on five senses to interpret the ongoing activities in the world around us. Though each of our senses is important, vision (see) is by default the most used for the daily tasks we do. Eyes, through which we see and perceive a lot of things, help us see the path we walk on, the road we drive on, and keep checks for any possible collision. Vision is so important that it came naturally to researcher scientists and engineers to recreate it in the machines. The aim is to train machines to visualize and act accordingly while minimizing human error and intervention.
What is ‘Computer Vision’?
Computer Vision is an interdisciplinary field of science that aims to make computers process, analyze images and videos and extract details in the same way a human mind does.
Earlier Computer Vision was meant only to mimic human visual systems until we realized how AI can augment its applications and vice versa. We may also not realize this every day but we are being assisted by the applications of Computer Vision in automotive, retail, banking and financial services, healthcare, etc.
Deep Neural Networks (DNN) have greater capabilities for image pattern recognition and are widely used in Computer Vision algorithms. And, Convolutional Neural Network (CNN, or ConvNet) is a class of DNN which is most commonly applied to analyzing visual imagery. It is used not only in Computer Vision but also for text classification in Natural Language Processing (NLP).
How CNNs Work?
Most of the Computer Vision tasks are surrounded around CNN architectures, as the basis of most of the problems is to classify an image into known labels. Algorithms for object detection like SSD(single shot multi-box detection) and YOLO(You Only Look Once) are also built around CNN.
Artificial neural networks were great for the task which wasn’t possible for Conventional Machine learning algorithms, but in case of processing images with fully connected hidden layers, ANN takes a very long time to be trained. Due to this, CNN was used to first reduces the size of images using convolutional layers and pooling layers and then feed the reduced data to fully connected layers.
Now, let’s talk about layers of CNN. Below we’ve described the architecture of CNNs in detail:
Convolution layer
To perform convolution operation, a filter (A smaller matrix)is used whose size can be specified. This filter moves all over the image matrix and its task is to multiply its values by the original pixel values. All these multiplications are summed up to one number at the end. The filter moves further and further to its right by n units(can vary) performing a similar operation. After passing across all the positions, a matrix is obtained which is much smaller in size than the input matrix.
Nonlinear layer
This layer is added after each of the convolution layers. It uses an activation function to bring non-linearity to data. Non-linearity means that the change of the output is not proportional to the change of the input. We require this nonlinearity because if the network was linear, there would be no point in adding multiple layers (multiple linear layers are equivalent to a single layer). By increasing the nonlinearity, a complex network is created to find new patterns in the images. The activation function here can be Rectified Linear Unit (ReLU), Tanh or any other nonlinear activation function. Read more about activation functions here.
Pooling Layer
Pooling layer is used to further downsize the matrix. The most common form of a pooling layer is with filters of size 2×2; applied with a stride of two downsamples at every depth slice in the input along both width and height, discarding 75 per cent of the activations. Pooling layer is generally used to select the most important pixels by using Max pooling function which only selects the highest value pixel present in the filter. This reduces the amount of computation required for training, hence reducing the time taken for training the neural network significantly.
Pooling can be done in various ways:
- Max pooling: The largest element in the matrix is selected.
- Min pooling: The smallest element in the matrix is selected.
- Mean pooling: The mean of the elements of the matrix is selected.
- Average pooling: The Average of the elements of the matrix is selected.
Fully Connected (FC)Layers
In Fully Connected layers, every neuron from one layer is connected to every neuron in another layer. Principally, FC acts similar to as the traditional neural network, Multi-Layer Perceptron (MLP). However, the only difference is that the inputs would be in the shape and form created by the previous stages of a CNN.
Deep Learning for Computer Vision
CNN Based Architectures
Many CNN based architectures have been used to maximize performance in image classification. These architectures are of the famous architecture are discussed below :
AlexNet (2012)
AlexNet, designed by the SuperVision group, including Alex Krizhevsky, Geoffrey Hinton, and Ilya Sutskever from the University of Toronto, was the winner of the 2012 ImageNet LSVRC-2012 competition. ImageNet is a yearly competition focused on image classification, with an error rate of 15.3 per cent. AlexNet uses ReLu activation function instead of tanh to add non-linearity, which accelerated the speed of training (by 6 times) and increased the accuracy. It also uses dropout regularisation (a technique prevents complex co-adaptations on training data to reduce overfitting). Another feature of AlexNet is that it overlaps pooling to reduce the size of the network. It reduces the top-1 and top-5 error rates by 0.4 per cent and 0.3 per cent, respectively.
AlexNet has five convolution layers and three fully connected layers. ReLu function is applied after every Convolutional layer and fully connected layer. Dropout is applied only before the first and the second fully connected layer.
AlexNet architecture has 62.3 million parameters and needs 1.1 billion computation units in a forward pass. In the paper for AlexNet, it is specified that the network takes 90 epochs in five or six days to train on two GTX 580 GPUs. Also, Stochastic Gradient Descent (SGD)with learning rate 0.01, momentum 0.9 and weight decay 0.0005 is used. Learning rate is divided by 10 once the accuracy plateaus. The learning rate decreases to three times during the training process.
GoogLeNet/Inception(2014)
GoogLeNet is the winner of the ILSVRC 2014; it achieved a top-5 error rate of 6.67 per cent. The network uses a CNN inspired by LeNet. Its architecture contains 1×1 Convolution at the middle of the network and global average pooling is used at the end of the network instead of using fully connected layers. It also makes use of the Inception module, to have different sizes/types of convolutions for the same input and stacking all the outputs. It also uses batch normalization, image distortions, and RMSprop.
In GoogLenet, 1×1 convolution is uses as a dimension reduction module to reduce computation. By reducing the computation bottleneck, depth and width can be increased. GoogLenet’s architecture consists of a 22 layer deep CNN but reduces the number of parameters from 60 million (AlexNet) to 4 million.
VGGNet (2014)
VGGNet was invented by VGG (Visual Geometry Group) from the University of Oxford. Though VGGNet is the 1st runner-up, not the winner of the ILSVRC 2014 in the classification task, it still showed a significant improvement to the previous Networks. VGGNet consists of 16 convolutional layers and is very appealing because of its very uniform architecture. Similar to AlexNet (3×3 convolutions) but lots of filters. It is mostly used for extracting features from images. VGG-16 is used as a base for object detection algorithm SSD, without fully connected layers.
ResNet(2015)
Residual Neural Network (ResNet) by Kaiming He et al, won the ILSVRC 2015. It achieved a top-5 error rate of 3.57 per cent that beats human-level performance on this dataset. It introduces an architecture which consists of 152 layers with skip connections(gated units or gated recurrent units) and features heavy batch normalization. The whole idea of ResNet is to counter the problem of vanishing gradients. By preserving the gradients, Vanishing gradients is the problem that occurs in networks with high number of layers as the weights of the first layers cannot be updated correctly through the backpropagation of the error gradient (the chain rule multiplies error gradient values lower than one and then, when the gradient error comes to the first layers, its value goes to zero).
Applications of Computer Vision
In modern days, Computer Vision has found many areas where it can be utilized. It automates processes in a way that not only reduces human effort but also provides us with solutions to the task that could never have been solved by the limitations of the human vision.
Healthcare
Computer Vision is widely used in the diagnosis of diseases by processing the X-rays, MRIs and other medical images. It has been proved to be as effective as regular human doctors when it comes to the matter of precision. Health problems like pneumonia, brain tumour, diabetes, Parkinson’s diseases, breast cancer, and many others are being diagnosed successfully day-to-day with the help of Computer Vision.
With the help of the state-of-the-art image processing techniques and Computer Vision, early-diagnosis of any plausible diseases will be possible. Thus allowing treatment in a premature stage of the disease or even squashing the chance of them ever occurring.
Computer Vision not only helps in diagnosis but also plays a key role in surgery by analyzing damages to the tissues and monitoring the blood loss of the patient. Computer vision has also helped researchers monitor a patient’s adherence to their prescribed treatments, reducing attrition in Clinical Trials.
Automobiles
With the increased hype of the self-driving cars, automobile industries are heavily dependent on Computer Vision since it is meant for understanding the driving environment, including detecting obstacles, pedestrians, lanes, and possible collision paths.
Computer Vision is now also used as driver assistants which helps the driver notifying it of certain situations. It also monitors the driver for negligence driving by analysing its correct behaviour and driving pattern, hence reducing the chances of any misfortune. It checks if he is driving rashly, or under influence of alcohol or drugs, and if he is drowsy.
Computer Vision is also embedded in the (process of) automated productions of cars where it rejects the defective components on the assembly line.
Security and Surveillance
These days houses, metro stations, roads, schools, hospitals or in fact, every building demands constant surveillance for theft, damage and security. So, we equip them with a network of closed-circuit cameras. However, we can only use these cameras are used as evidence against a certain crime rather than being a tool in averting that crime. This is where Computer Vision pitches in.
Security system with Computer Vision capabilities not only detect crime like violence, theft, trespassing but also use its face recognition ability to find or locate criminals in crowded areas like airports and train stations.
Astronomy
All our knowledge about the universe is derived from the measurements of photons which are mostly images. This opens the possibility of application of Computer Vision in astronomy as our universe is so vast and its only natural that the data collected will also be large.
Studying this data manually won’t be possible for the astronomer, or any human. Using Computer Vision, we can analyse all the data at a much faster rate. Presently, Computer vision is already being used for discovering new planets and heavenly bodies, this includes application like exoplanet imaging, star and galaxy classification, etc.
Agriculture
In agriculture, Computer Vision is used to determine the health of seeds to be sown. Using hyperspectral or multispectral sensors, the health of the crops can also be determined. The technology can also help in identifying the areas with fertile soil, presences of water bodies, hence identifying areas suitability for agriculture.
Computer Vision is also enabling robots to carry out processes such as harvesting, planting, weeding. The autonomous tractors use machine vision to do all the heavy and time-consuming tasks on a field, which reduces the stress on the farmers. With this tech, one can track its livestock and even monitor their growth over the course of a lifetime to obtain important information on them for usability.
Industrial
In Industries, Computer Vision is used on the assembly lines for counting batch, detecting damaged components, for the inspection of the finished goods. Here, Machine Vision tools aid in finding microscopic level defects in products that simply cannot be identified through human vision. In manufacturing tasks, reading barcodes or QR code are essential as they provide a unique identification to a product. Reading thousands of barcodes in a day is not an easy task for humans, but, it can be done easily in minutes through Computer Vision.
Satellite Imagery
Computer Vision is applied to satellite images to detect natural hazards like floods, tsunamis, hurricanes, and landslides. Satellite images are also used to analyze pollution and air quality index of areas of focus.
Manual mining just for checking the presence of ore can be costly and it may lead to a huge waste of money. Recently, the use of Computer Vision in mining industries has started to detect areas with the high possibility of having crude oil or minerals.
Challenges for Computer Vision
Computer Vision is heavily dependent on the quality of images, the factors like which camera was used, what time of the day was the image/video taken, and if the camera was stable.
Applications like facial recognition and video analysis usually face huge problems because of the low-quality CCTV used to distinguish people. In the case of object detection, the size of the objects and the model’s accuracy plays an important role. Small objects aren’t easily detected. Even if they are detected, the detection is unstable. It is also affected by deformation of the objects, background of the image and the extent of occlusion.
Another factor that causes hindrance to Computer Vision is the Knowledge of the model. If an object or image which wasn’t present in the training set, the model will only show incorrect results. This can be a problem, for example, a weapons detection system is deployed at a railway station which is only trained for guns and knives, and the terrorists bring in bombs which can go undetected through the system, hence putting lives in danger.
Despite challenges, which we are already overcoming with, Computer Vision offers wonderful research and innovation opportunity to every tech enthusiast. The is a boon to both AI/ML developers (who identify patterns for them) and users (who are the receiving end of the tailored user-friendly product).