Sorry, you have been blocked
This website is using a security service to protect itself from online attacks. The action you just performed triggered the security solution. There are several actions that could trigger this block including submitting a certain word or phrase, a SQL command or malformed data.
What can I do to resolve this?
You can email the site owner to let them know you were blocked. Please include what you were doing when this page came up and the Cloudflare Ray ID found at the bottom of this page.
Cloudflare Ray ID: 7e921ec7dc810f9a • Your IP: Click to reveal 138.199.34.5 • Performance & security by Cloudflare
Как работает FPGA?
Давайте начнём с самого начала. Что такое FPGA? FPGA расшифровывается как F ield P rogrammable G ate Array (программируемая пользователем вентильная матрица).
FPGA относятся к классу устройств программируемой логики, иногда называемых программируемым оборудованием. По сути, сама по себе FPGA ничего не делает, но может быть сконфигурирована так, чтобы превратиться практически в любую нужную цифровую цепь. Магия заключается в том, что физически при этом ничего не меняется. Достаточно просто загрузить конфигурацию в FPGA, и она начнёт вести себя так, как нужная вам цепь. Не нужны ни пайка, ни перемычки, ни возня с другими соединениями. FPGA можно переконфигурировать так, чтобы она вела себя, как другая цепь, и делать это множество раз. Конфигурация хранится в ОЗУ, то есть, по сути, устройство можно переконфигурировать бесконечно.
 |
 |
| На плате Alchitry Cu выделена FPGA Lattice iCE40 HX | На плате Alchitry Au выделена FPGA Xilinx Artix 7 |
Хотя мы говорили об использовании FPGA для создания цифровых цепей, обычно для разработки их архитектуры не рисуют схемы. Если бы нам пришлось чертить схему, то размер и сложность цепей, которые могут содержать FPGA, стали бы очень громоздкими. Вместо этого мы можем описать поведение нужной нам цепи, а инструменты используют это описание для создания цепи, соответствующей этому поведению.
В каком-то смысле это похоже на программирование, ведь мы просто вводим текст. Однако фундаментальная реализация существенно отличается, так как мы создаём оборудование.
Если создание оборудования при помощи текста кажется вам магией, не волнуйтесь. Концепция его работы на самом деле довольно проста, и в этом туториале мы подробно о ней расскажем.
▍ Рекомендуемое чтение
В этом туториале мы узнаем, что такое FPGA и как она работает. Будем предполагать, что вы разбираетесь в электричестве (напряжение, ток и так далее) и двоичных значениях. Всё остальное легко понять из основ. Статья задумывалась как обзор FPGA и её фундаментальной архитектуры, а не руководство по проектированию собственного устройства.
Если вы незнакомы со следующими концепциями, то прежде чем читать дальше, рекомендую изучить данные туториалы:
Напряжение, ток, сопротивление и закон Ома. Узнайте о законе Ома — одном из самых фундаментальных уравнений во всей электромеханике.
Что такое электричество?. Работу электричества мы можем наблюдать в своих компьютерах, осветительных приборах и молниях, но что же это такое? Это непростой вопрос, и данный туториал прольёт на него немного света!
Аналоговое и цифровое. В этом туториале излагается концепция аналоговых и цифровых сигналов, и их связь с электроникой.
Транзисторы. Краткое введение в биполярные транзисторы. Узнайте, как работают транзисторы и в каких цепях мы их используем.
Цифровые цепи и логические вентили
▍ Цифровые цепи
Недостаток FPGA заключается в том, что они могут создавать только цифровые цепи. В некоторых новых FPGA есть встроенные аналогово-цифровые преобразователи, но даже они сразу же преобразуют аналоговый входной сигнал в цифровой. Но что же такое цифровая цепь?
В электронике цифровыми называются цепи, абстрагирующие непрерывные значения напряжения в дискретные единицы и нули. Для высокоуровневой архитектуры истинные напряжения и пороговые значения не так важны, но внутри FPGA часто бывает так, что 0 В обозначается как 0, а 1,2 В — как 1. Если истинное напряжение, допустим, равно 0,8 В, это достаточно близко к 1,2 В, чтобы считаться 1, а всё остальное работает так же.
Цифровые цепи преобразуют напряжения в крайние значения, что делает их невероятно устойчивыми к шуму и другим воздействиям реального мира. Также концепция цифрового устройства позволяет нам моделировать в цепи сложное поведение без необходимости работы над низкоуровневой архитектурой. Мы можем работать в идеальном мире. Все тонкости спрятаны внутри архитектуры простых строительных блоков, которые мы будем использовать.
Такими строительными блоками являются логические вентили.
▍ Логические вентили
Существует несколько логических вентилей, самые распространённые из которых — это AND (И) , OR (ИЛИ) , XOR (исключающее ИЛИ) и NOT (НЕТ) . Каждый из них получает на входе цифровые сигналы, выполняет свою логическую функцию и подаёт на выход цифровое значение.
Вентиль AND получает два входных значения и выводит 1, только если первое и второе входные значения равны 1. Если хотя бы одно из входных значений равно 0, то на выходе будет 0. Символ вентиля AND выглядит так:

Вентиль OR получает два входных значения и выводит 1, если первое или второе значение равно 1. Выходное значение равно 0, только когда оба входных значения равны 0. Вот символ вентиля OR:

Вентиль XOR схож с вентилем OR, но подаёт на выход 1, только когда или первое, или второе входное значение равно 1, но не когда оба равны 1. Можно ещё сказать, что он выводит 1, когда входные значения различаются. X в XOR расшифровывается как exclusive («исключающее»). Вот символ вентиля:

Вентиль NOT — самый простой. У него только один вход и он просто выводит противоположное значение. То есть 1 превращается в 0, а 0 превращается в 1.

Существуют вариации этих базовых вентилей, называющиеся NAND, NOR и XNOR. Это просто версии стандартных вентилей, но с инвертированными выходами.
Вентиль AND, как и все другие логические вентили, можно изготовить из транзисторов. На изображении ниже показано, как можно реализовать вентиль AND. В этой схеме использованы МОП-транзисторы NMOS и PMOS. Такой тип архитектуры называется CMOS (complementary metal-oxide semiconductor, КМОП, комплементарная структура металл-оксид-полупроводник), она используется в большинстве современных цепей.

Обратите внимание, что показанная выше схема на самом деле является вентилем NAND, за которым идёт вентиль NOT. Так получилось потому, что КМОП-цепи инвертируют выходное значение.
Мультиплексоры
Теперь, когда у нас есть базовые строительные блоки, от транзисторов до логических вентилей, мы можем создать из них что-то более полезное. При помощи одних только логических вентилей можно описать любую цифровую цепь. Однако существует множество часто используемых и обозначаемых собственными символами высокоуровневых функций, например, в двоичной математике (сумматоры, умножители и так далее).
Мы рассмотрим один из фундаментальных строительных блоков FPGA — мультиплексор.
Мультиплексор выбирает единственное входное значение из множества на основании значения входа выбора. Вот его символ:

Символ / на линии sel обозначает, что он имеет ширину 6 битов.
Количество входов может варьироваться, но выход у мультиплексора всегда только один.
Способ кодирования входа выбора тоже варьируется. Обычно он представлен как двоичное число, но в более простых цепях используется унитарное кодирование. Унитарный код — это просто двоичное значение, в котором всегда ровно одна 1. Важно в нём положение этой 1.
Декодер получает двоичное значение и превращает его в унитарный сигнал. Кодировщик превращает унитарное значение в двоичное число. Их можно использовать для того, чтобы мультиплексор принимал двоичные значения.
Взгляните, как можно реализовать мультиплексор с унитарным кодированием всего из нескольких вентилей AND и OR.

Если мы присвоим sel значение 000010, то есть только sel[1] будет равно 1, то для каждого вентиля AND, за исключением того, который имеет вход b, одно из входных значений будет равно 0. Это значит, что каждый из них будет подавать на выход 0, вне зависимости от того, какие входные значения на a, c, d, e и f. Единственный имеющий значение вход — это b. Если b равен 1, то он подвергается AND с 1 и на выходе вентиля AND будет 1. Когда b равен 0, то он подвергается AND с 1 и на выходе вентиля AND будет 0.
Иными словами, на выходе вентиля AND просто будет b.

Результат вентилей AND, когда sel[1] присвоено значение 1
Вентиль OR на этой схеме показан с более чем двумя входами. Это можно реализовать, создав дерево из двух входных вентилей OR, в которых два входа подвергаются OR, после чего выходы тоже подвергаются OR, и так снова и снова, пока мы не получим один выход. Вентиль OR со множественными входами будет иметь на выходе 1, если хотя бы один из входов равен 1.
Однако в этой цепи каждый вход вентиля OR гарантировано будет иметь значение 0, за исключением входа от вентиля AND, выходом которого является b. Это значит, что вентиль OR будет выводить 1, когда b равен 1, и выводить 0, когда b равен 0.
Иными словами, выходом вентиля OR будет просто b.

Результатом вентиля OR будет b
Эту логику можно повторить для любого входа, если вход будет с унитарным кодированием, то вход, соответствующий заданной 1, будет передан на выход.
Можно представить большую матрицу мультиплексоров с программируемыми входными данными sel. Это позволит направлять сигналы так, как нужно в архитектуре. Именно так FPGA передают сигналы туда, где они должны быть; это называется general routing matrix (главной трассировочной матрицей).
Очевидно, подробности маршрутизации тысяч и тысяч сигналов становятся запутанными, но в конечном итоге всё это просто множество мультиплексоров, входы выбора которых подключены к программируемой памяти.
Таблицы поиска
Итак, научившись динамически маршрутизировать сигналы туда, где они должны быть, мы должны найти способ выполнения произвольной логики. Для этого мы снова используем мультиплексоры, а точнее, их потомков, называемых LUT, или look-up table (таблицами поиска).
Представьте, что у нас есть мультиплексор с четырьмя входами и 2-битным двоичным выбором (вместо унитарного). Вместо того, чтобы открывать основные входы миру, подключим их к некой программируемой памяти. Это значит, что мы сможем запрограммировать каждый вход на некое постоянное значение. Объединим всё это в один блок и получим две входные LUT.

Два входа в LUT — это входы выбора мультиплексора. Программируя входы мультиплексора любыми нужными нам значениями, мы можем использовать эту LUT для реализации ЛЮБОЙ двоичной функции «2-к-1».
Например, можно заставить его работать как простой вентиль AND, задав в памяти следующее содержимое.
| Адрес (In[1:0]) | Значение (Out) |
|---|---|
| 00 | 0 |
| 01 | 0 |
| 10 | 0 |
| 11 | 1 |
Это простой пример — обычно LUT больше, чем просто два входа; FPGA на Alchitry Au основана на LUT с пятью входами.
Xilinx объединяет LUT с пятью входами с ещё одним мультиплексором для создания или LUT с шестью входами, или LUT с пятью входами и двух независимых выходов.

Если вы хотите подробнее узнать о том, что такое LUT и как выглядят ресурсы в FPGA, то прочитайте этот документ Xilinx по Artix 7. Учтите, что этот документ очень труден для понимания. Стоит взглянуть на страницу 20. На ней показана упрощённая схема SLICEL. Слайсы находятся на один строительный блок выше LUT. Четыре прямоугольника слева — это LUT, похожие на показанные выше.
Для контекста: в FPGA на Alchitry Au содержится 20800 двойных LUT. Это большое число, но оно и близко несравнимо с самыми крупными FPGA, в которых на момент написания статьи содержится примерно в 260 раз больше таблиц. Как можно понять, даже маршрутизировать все эти сигналы невероятно сложно. К счастью для нас, чтобы работать с FPGA, всё это нам делать не нужно. Инструменты выполняют всю низкоуровневую маршрутизацию и программирование LUT. Нам просто достаточно описать нужные цепи.
Зачем использовать FPGA?
Надеюсь, этот туториал дал вам примерное понимание того, как работают FPGA, но зачем их вообще использовать?
Обычно такой вопрос возникает в контексте выбора между использованием процессора или создания собственной архитектуры на FPGA. Многие люди знают, как писать код, но гораздо меньшее количество понимает, как создавать архитектуры для FPGA. Писать код часто проще при создании сложных поведений и для существенного изменения способа реализации.
Однако FPGA могут быть гораздо более эффективными с точки зрения времени обработки, а также обеспечения хороших таймингов. Чтобы проиллюстрировать это, рассмотрим тривиальный пример со включением светодиода при нажатии на кнопку. Если написать код для этого на чём-то вроде Arduino, то процессор будет выполнять небольшой цикл кода, считывающий состояние контакта, а затем обновляющий состояние другого контакта на основании этого значения.
Если вы оптимизируете этот код, то сможете добиться скорости обновления в миллионы раз в секунду. Кажется, это замечательно, но давайте посмотрим, как это будет выглядеть в случае FPGA. Если мы просто подключаем кнопку к светодиоду при помощи FPGA, то мы просто связываем кнопку и светодиод. Значение от кнопки передаётся через какой-то входной буфер, подаётся через матрицу трассировки, а затем выводится через выходной буфер. Этот процесс непрерывно повторяется всё время. Единственная задержка возникает из-за задержек коммутации транзисторов в чипе, которые невероятно малы.
Давайте расширим нашу конструкцию и добавим в неё микрофон. Мы можем брать сэмплы с микрофона и выполнять их обработку, чтобы определять частоты перехваченного аудио. По собственному опыту знаю, что это довольно сложно делать на маленьком микроконтроллере в реальном времени с приличной частотой сэмплирования. Процессору необходимо жонглировать считыванием сэмплов с микрофона, сохранением их в некий буфер, выполнением математических действий и выводом значений, например, на дисплей из светодиодов. Каждый из этих этапов требует времени, а процессор может выполнять только по одному этапу за раз.
При использовании FPGA можно выделить небольшой фрагмент архитектуры для считывания сэмплов с микрофона. Затем можно передавать сэмплы в буфер, а при его заполнении отправлять их в цепь, которая будет выполнять вычисления. Далее эта цепь может передавать результаты другой цепи, которая будет отображать светодиодами.
Каждый из этих этапов будет работать совершенно независимо друг от другого, потому что они просто существуют в оборудовании. Это не строки кода, конкурирующие за процессорное время.
А теперь представьте, что нам всё ещё нужно, чтобы кнопка была привязана к светодиоду. Раньше мы получали потрясающее время ответа в миллионы доли секунды, которое теперь превратилось в ужасающую пятую часть секунды, потому что мы не можем выделить достаточно процессорного времени, чтобы считывать кнопку так часто. Однако в FPGA кнопка и светодиод просто соединены вместе и реагируют почти мгновенно, как и раньше.
Такая независимость делает FPGA потрясающим кандидатом для управления всем тем, что требует быстрых таймингов. Например, светодиод WS2812B (он же NeoPixel) требует точного тайминга потока импульсов, чтобы записывать в них данные. При использовании микроконтроллера обычно необходимо писать встроенный ассемблер только для того, чтобы тайминг импульсов был достаточно точным. Также нужно отключить прерывания, потому что любые простои будут мешать сигналу.
При работе с FPGA достаточно просто создать последовательность чётко контролируемых импульсов для управления этими светодиодами; при этом не нужно беспокоиться о том, что какой-то другой элемент архитектуры конфликтует с таймингом.
Когда стоит использовать FPGA
Учитывая все плюсы применения FPGA, можно задаться вопросом: «Почему бы их не использовать для всего?». Отличный вопрос!
В описании работы FPGA можно было заметить, что для динамической реализации даже простейшей цепи нужно множество всего дополнительного. И это имеет свою цену, как в долларах, так и в ресурсах на проектирование.
FPGA обычно дороги. Самые крупные легко могут стоить тысячи долларов за чип. Это связано с большим количеством микросхем для их производства, затратами на исследования и разработки для проектирования чипов и инструментов, а также с относительно небольшими тиражами по сравнению, например, с крошечными процессорами, которые используются в телефонах.
Ещё один аспект затрат — это энергопотребление. В LUT используется множество транзисторов по сравнению с количеством, необходимым для непосредственной реализации цепи. Всем этим транзисторам требуется питание. Из-за этого FPGA оказываются плохими кандидатами для работы в устройствах на аккумуляторах. Разумеется, можно спроектировать цепи так, чтобы они были экономичными, но даже когда абсолютно ничего не делает, FPGA на Alchitry Au потребляет чуть больше 100 мА. Если начать использовать чип, то запросто можно получить больше 1000 мА. Для сравнения: чип ATmega32U4, используемый в Arduino Leonardo, на полной мощности потребляет 27 мА при 5 В. Хотя нужно учесть, что Alchitry Au гораздо более функциональный.
Так зачем же вообще использовать FPGA? При создании собственной цифровой цепи у вас есть два основных варианта. Во-первых, её можно создать самостоятельно из дискретной логики. Для этого понадобится существенное количество времени, гораздо больше затрат, а если понадобится что-то поменять, то гибкость окажется гораздо ниже.
Вторая, более реалистичная альтернатива заключается в проектировании цепи непосредственно в кремнии. При этом вы создадите очень быструю и эффективную цепь, но ценой нулевой гибкости и кучи денежных затрат. Огромные предварительные затраты на собственные микросхемы связаны с инструментарием и подготовкой. Однако инкрементные затраты на чип будут меньше, чем за отдельные FPGA. Впрочем, если вы не изготавливаете десятки тысяч чипов, это всё равно будет более затратным. Но даже при больших партиях иногда не имеет смысла замыкать свою архитектуру в кремний. При использовании FPGA можно изменять её в любой момент и без дополнительных затрат.
Благодаря своей гибкости и низкой стоимости по сравнению с альтернативами, FPGA открывает возможности добавления собственных цифровых цепей практически в любую архитектуру. Но нужна ли вам собственная цепь на самом деле?
Важно помнить, что FPGA — это просто один из инструментов. Молоток отлично подходит для забивания гвоздей, но ужасно справляется со вкручиванием шурупов. И забивать гвоздь отвёрткой тоже будет очень неудобно.
Создание собственных цепей может быть сложной задачей, и иногда стоит задаться вопросом, нет ли решения получше. Существует множество очень функциональных процессоров с кучей периферии, способных справляться с большинством ваших задач. Выполнение некоторых задач, например, получение и отправка данных через WiFi, может быть пугающим процессом при работе с FPGA, но легко выполнимым с микроконтроллером за несколько долларов, например, с ESP8266.
Я часто сравниваю FPGA со сборочной линией. Каждый участок сборочной линии не зависит от другого и чрезвычайно эффективно выполняет свою цель. Однако первоначальная подготовка линии может быть сложной работой, а иногда при внесении серьёзных изменений проще начать всё с нуля.
С другой стороны, процессоры похожи на людей. Если дать человеку время и обучить его, то он может выполнить практически любую задачу. Человеку легко выполнять сложные последовательные работы.
Действительно ли вам нужно организовывать целый завод по производству сэндвичей, если вы хотите просто сделать сэндвич на обед?
FPGA потрясающи и часто становятся незаменимыми в подходящих для них задачах, но это всего лишь один из инструментов. Очень мощный и стоящий изучения, но всё-таки ещё один инструмент.
Ресурсы и дальнейшее изучение
Мы изложили основы работы FPGA и их составляющих. На веб-сайте Alchitry есть множество других отличных ресурсов, в том числе туториалы, проекты и форум Alchitry.
FPGA. Разбираемся, как устроены программируемые логические схемы и чем они хороши
Может быть, ты умеешь взламывать устройства на другом конце света или кодить крутые веб-приложения, но понимаешь ли ты, как работает твой компьютер? И речь не о том, что делает операционка, как функционирует garbage collector в Java или как устроен компилятор C++. Я говорю о самом низком, аппаратном уровне, ниже ассемблера: как работает железо.
Что происходит в микросхеме сетевой карты, когда приходит пакет Ethernet? Как этот пакет передается дальше в оперативную память компьютера через шину PCI Express? Как работают самые быстрые системы распознавания изображений на аппаратном уровне?
Для ответа на эти вопросы надо немного разбираться в цифровой логике работы микросхем ASIC, но начинать с них очень сложно и дорого, и вместо этого лучше начать с FPGA.
FPGA расшифровывается как field-programmable gate array, по-русски — программируемые пользователем вентильные матрицы, ППВМ. В более общем случае они называются ПЛИС — программируемые логические интегральные схемы.
С помощью FPGA можно в буквальном смысле проектировать цифровые микросхемы, сидя у себя дома с доступной отладочной платой на столе и софтом разработчика за пару килобаксов. Впрочем, есть и бесплатные варианты. Заметь: именно проектировать, а не программировать, потому что на выходе получается физическая цифровая схема, выполняющая определенный алгоритм на аппаратном уровне, а не программа для процессора.
Работает это примерно так. Есть готовая печатная плата с набором интерфейсов, которые подключены к установленной на плате микросхеме FPGA, вроде крутой платы для дата-центра или отладочной платы для обучения.
Пока мы не сконфигурируем FPGA, внутри микросхемы просто нет логики для обработки данных с интерфейсов, и потому работать ничего, очевидно, не будет. Но в результате проектирования будет создана прошивка, которая после загрузки в FPGA создаст нужную нам цифровую схему. Например, так можно создать контроллер 100G Ethernet, который будет принимать и обрабатывать сетевые пакеты.
Важная особенность FPGA — возможность реконфигурации. Сегодня нам нужен контроллер 100G Ethernet, а завтра эта же плата может быть использована для реализации независимых четырех интерфейсов 25G Ethernet.
Существуют два крупных производителя FPGA-чипов: Xilinx и Intel, которые контролируют 58 и 42% рынка соответственно. Основатели Xilinx изобрели первый чип FPGA в далеком 1985 году. Intel пришла на рынок недавно — в 2015 году, поглотив компанию Altera, которая была основана в то же время, что и Xilinx. Технологии Xilinx и Altera во многом схожи, как и среды разработки. Чаще я работал с продуктами компании Xilinx, поэтому не удивляйся ее постоянному упоминанию.
FPGA широко применяются в разных устройствах: потребительской электронике, оборудовании телекома, платах-ускорителях для применения в дата-центрах, различной робототехнике, а также при прототипировании микросхем ASIC. Пару примеров я разберу чуть ниже.
Также рассмотрим технологию, которая обеспечивает аппаратную реконфигурацию, познакомимся с процессом проектирования и разберем простой пример реализации аппаратного счетчика на языке Verilog. Если у тебя есть любая отладочная плата FPGA, ты сможешь повторить это самостоятельно. Если платы нет, то все равно сможешь познакомиться с Verilog, смоделировав работу схемы на своем компе.
Принцип работы
Микросхема FPGA — это та же заказная микросхема ASIC, состоящая из таких же транзисторов, из которых собираются триггеры, регистры, мультиплексоры и другие логические элементы для обычных схем. Изменить порядок соединения этих транзисторов, конечно, нельзя. Но архитектурно микросхема построена таким хитрым образом, что можно изменять коммутацию сигналов между более крупными блоками: их называют CLB — программируемые логические блоки.
Также можно изменять логическую функцию, которую выполняет CLB. Достигается это за счет того, что вся микросхема пронизана ячейками конфигурационной памяти Static RAM. Каждый бит этой памяти либо управляет каким-то ключом коммутации сигналов, либо является частью таблицы истинности логической функции, которую реализует CLB.
Так как конфигурационная память построена по технологии Static RAM, то, во-первых, при включении питания FPGA микросхему обязательно надо сконфигурировать, а во-вторых, микросхему можно реконфигурировать практически бесконечное количество раз.

Очень упрощенная 2D-структура микросхемы без конфигурационной памяти
Другие статьи в выпуске: 
Xakep #236. FPGA
Блоки CLB находятся в коммутационной матрице, которая задает соединения входов и выходов блоков CLB.
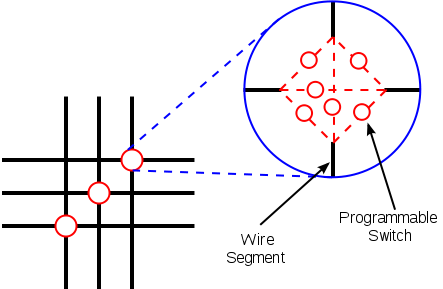
Схема коммутационной матрицы
На каждом пересечении проводников находится шесть переключающих ключей, управляемых своими ячейками конфигурационной памяти. Открывая одни и закрывая другие, можно обеспечить разную коммутацию сигналов между CLB.
CLB очень упрощенно состоит из блока, задающего булеву функцию от нескольких аргументов (она называется таблицей соответствия — Look Up Table, LUT) и триггера (flip-flop, FF). В современных FPGA LUT имеет шесть входов, но на рисунке для простоты показаны три. Выход LUT подается на выход CLB либо асинхронно (напрямую), либо синхронно (через триггер FF, работающий на системной тактовой частоте).
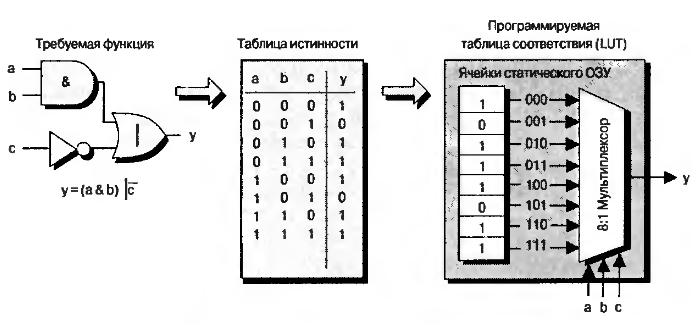
Принцип реализации LUT
Интересно посмотреть на принцип реализации LUT. Пусть у нас есть некоторая булева функция y = (a & b) |
c . Ее схемотехническое представление и таблица истинности показаны на рисунке. У функции три аргумента, поэтому она принимает 2^3 = 8 значений. Каждое из них соответствует своей комбинации входных сигналов. Эти значения вычисляются программой для разработки прошивки ПЛИС и записываются в специальные ячейки конфигурационной памяти.
Значение каждой из ячеек подается на свой вход выходного мультиплексора LUT, а входные аргументы булевой функции используются для выбора того или иного значения функции. CLB — важнейший аппаратный ресурс FPGA. Количество CLB в современных кристаллах FPGA может быть разным и зависит от типа и емкости кристалла. У Xilinx есть кристаллы с количеством CLB в пределах примерно от четырех тысяч до трех миллионов.
Помимо CLB, внутри FPGA есть еще ряд важных аппаратных ресурсов. Например, аппаратные блоки умножения с накоплением или блоки DSP. Каждый из них может делать операции умножения и сложения 18-битных чисел каждый такт. В топовых кристаллах количество блоков DSP может превышать 6000.
Другой ресурс — это блоки внутренней памяти (Block RAM, BRAM). Каждый блок может хранить 2 Кбайт. Полная емкость такой памяти в зависимости от кристалла может достигать от 20 Кбайт до 20 Мбайт. Как и CLB, BRAM и DSP-блоки связаны коммутационной матрицей и пронизывают весь кристалл. Связывая блоки CLB, DSP и BRAM, можно получать весьма эффективные схемы обработки данных.
Применение и преимущества FPGA
Первый чип FPGA, созданный Xilinx в 1985 году, содержал всего 64 CLB. В то время интеграция транзисторов на микросхемах была намного ниже, чем сейчас, и в цифровых устройствах часто использовались микросхемы «рассыпной логики». Были отдельно микросхемы регистров, счетчиков, мультиплексоров, умножителей. Под конкретное устройство создавалась своя печатная плата, на которой устанавливались эти микросхемы низкой интеграции.
Использование FPGA позволило отказаться от такого подхода. Даже FPGA на 64 CLB значительно экономит место на печатной плате, а доступность реконфигурации добавила возможность обновлять функциональность устройств уже после изготовления во время эксплуатации, как говорят «in the field» (отсюда и название — field-programmable gate array).
За счет того, что внутри FPGA можно создать любую аппаратную цифровую схему (главное, чтобы хватило ресурсов), одно из важных применений ПЛИС — это прототипирование микросхем ASIC.
Разработка ASIC очень сложна и затратна, цена ошибки очень высока, и вопрос тестирования логики критичен. Поэтому одним из этапов разработки еще до начала работы над физической топологией схемы стало ее прототипирование на одном или нескольких кристаллах FPGA.
Для разработки ASIC выпускают специальные платы, содержащие много FPGA, соединенных между собой. Прототип микросхемы работает на значительно меньших частотах (может быть, десятки мегагерц), но позволяет сэкономить на выявлении проблем и багов.
Однако, на мой взгляд, существуют более интересные применения ПЛИС. Гибкая структура FPGA позволяет реализовывать аппаратные схемы для высокоскоростной и параллельной обработки данных с возможностью изменить алгоритм.
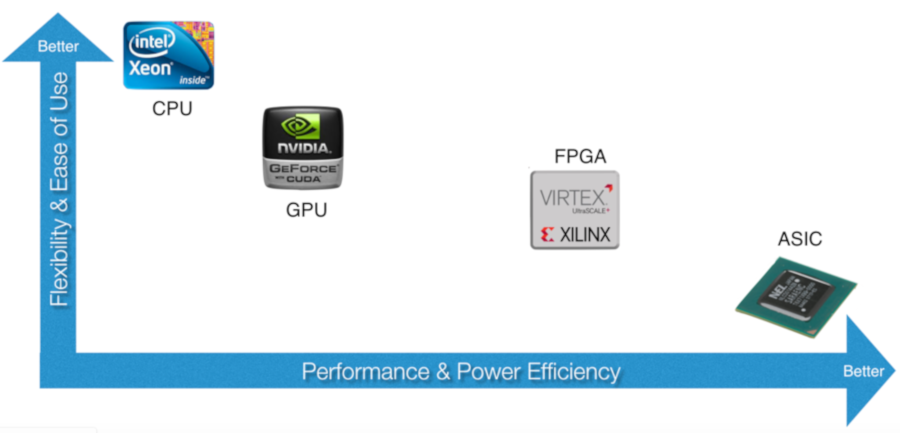
Сравнение аппаратных платформ
Давай подумаем, чем принципиально отличаются CPU, GPU, FPGA и ASIC. CPU универсален, на нем можно запустить любой алгоритм, он наиболее гибок, и использовать его легче всего благодаря огромному количеству языков программирования и сред разработки.
При этом из-за универсальности и последовательного выполнения инструкций CPU снижается производительность и повышается энергопотребление схемы. Происходит это потому, что на каждую полезную арифметическую операцию CPU совершает много дополнительных операций, связанных с чтением инструкций, перемещением данных между регистрами и кешем, и другие телодвижения.
На другой стороне находится ASIC. На этой платформе требуемый алгоритм реализуется аппаратно за счет прямого соединения транзисторов, все операции связаны только с выполнением алгоритма и нет никакой возможности изменить его. Отсюда максимальная производительность и наименьшее энергопотребление платформы. А вот перепрограммировать ASIC невозможно.
Справа от CPU находится GPU. Изначально эти микросхемы были разработаны для обработки графики, но сейчас используются и для майнинга вычислений общего назначения. Они состоят из тысяч небольших вычислительных ядер и выполняют параллельные операции над массивом данных.
Если алгоритм можно распараллелить, то на GPU получится добиться значительного ускорения по сравнению с CPU. С другой стороны, последовательные алгоритмы будут реализовываться хуже, поэтому платформа оказывается менее гибкой, чем CPU. Также для разработки под GPU надо иметь специальные навыки, знать OpenCL или CUDA.
Наконец, FPGA. Эта платформа сочетает эффективность ASIC с возможностью менять программу. ПЛИС не универсальны, но существует класс алгоритмов и задач, которые на них будут показывать лучшую производительность, чем на CPU и даже GPU. Сложность разработки под FPGA выше, однако новые средства разработки делают этот разрыв меньше.
Решающее же преимущество FPGA — это способность обрабатывать данные в темпе их поступления с минимальной задержкой реакции. В качестве примера можешь вообразить умный сетевой маршрутизатор с большим количеством портов: при поступлении пакета Ethernet на один из его портов необходимо проверить множество правил, прежде чем выбрать выходной порт. Возможно, потребуется изменение некоторых полей пакета или добавление новых.
Использование FPGA позволяет решать эту задачу мгновенно: байты пакета еще только начали поступать в микросхему из сетевого интерфейса, а его заголовок уже анализируется. Использование процессоров тут может существенно замедлить скорость обработки сетевого трафика. Ясно, что для маршрутизаторов можно сделать заказную микросхему ASIC, которая будет работать наиболее эффективно, но что, если правила обработки пакетов должны меняться? Достичь требуемой гибкости в сочетании с высокой производительностью поможет только FPGA.
Таким образом, FPGA используются там, где нужна высокая производительность обработки данных, наименьшее время реакции, а также низкое энергопотребление.
FPGA in the cloud
В облачных вычислениях FPGA применяются для быстрого счета, ускорения сетевого трафика и осуществления доступа к массивам данных. Сюда же можно отнести использование FPGA для высокочастотной торговли на биржах. В серверы вставляются платы FPGA с PCI Express и оптическим сетевым интерфейсом производства Intel (Altera) или Xilinx.
На FPGA отлично ложатся криптографические алгоритмы, сравнение последовательностей ДНК и научные задачи вроде молекулярной динамики. В Microsoft давно используют FPGA для ускорения поискового сервиса Bing, а также для организации Software Defined Networking внутри облака Azure.
Бум машинного обучения тоже не обошел стороной FPGA. Компании Xilinx и Intel предлагают средства на основе FPGA для работы с глубокими нейросетями. Они позволяют получать прошивки FPGA, которые реализуют ту или иную сеть напрямую из фреймворков вроде Caffe и TensorFlow.
Причем это все можно попробовать, не выходя из дома и используя облачные сервисы. Например, в Amazon можно арендовать виртуальную машину с доступом к плате FPGA и любым средствам разработки, в том числе и machine learning.
FPGA on the edge
Что еще интересное делают на FPGA? Да чего только не делают! Робототехника, беспилотные автомобили, дроны, научные приборы, медицинская техника, пользовательские мобильные устройства, умные камеры видеонаблюдения и так далее.
Традиционно FPGA применялись для цифровой обработки одномерных сигналов (и конкурировали с процессорами DSP) в устройствах радиолокации, приемопередатчиках радиосигналов. С ростом интеграции микросхем и увеличением производительности платформы FPGA стали все больше применяться для высокопроизводительных вычислений, например для обработки двумерных сигналов «на краю облака» (edge computing).
Эту концепцию легче всего понять на примере видеокамеры для анализа автомобильного трафика с функцией распознавания номеров машин. Можно взять камеру с возможностью передачи видео через Ethernet и обрабатывать поток на удаленном сервере. С ростом числа камер будет расти и нагрузка на сеть, что может привести к сбоям системы.
Вместо этого лучше реализовать распознавание номеров на вычислителе, установленном прямо в корпус видеокамеры, и передавать в облако номера машин в формате текста. Для этого даже можно взять сравнительно недорогие FPGA с низким энергопотреблением, чтобы обойтись аккумулятором. При этом остается возможность изменять логику работы FPGA, например, при изменении стандарта автомобильных номеров.
Что до робототехники и дронов, то в этой сфере как раз особенно важно выполнять два условия — высокая производительность и низкое энергопотребление. Платформа FPGA подходит как нельзя лучше и может использоваться, в частности, для создания полетных контроллеров для беспилотников. Уже сейчас делают БПЛА, которые могут принимать решения на лету.
Как разрабатывать проект на FPGA?
Существуют разные уровни проектирования: низкий, блочный и высокий. Низкий уровень предполагает использование языков типа Verilog или VHDL, на которых ты управляешь разработкой на уровне регистровых передач (RTL — register transfer level). В этом случае ты формируешь регистры, как в процессоре, и определяешь логические функции, изменяющие данные между ними.
Схемы FPGA всегда работают на определенных тактовых частотах (обычно 100–300 МГц), и на уровне RTL ты определяешь поведение схемы с точностью до такта системной частоты. Эта кропотливая работа приводит к созданию максимально эффективных схем с точки зрения производительности, потребления ресурсов кристалла FPGA и энергопотребления. Но тут требуются серьезные скиллы в схемотехнике, да и с ними процесс небыстрый.
На блочном уровне ты занимаешься в основном соединением уже готовых крупных блоков, которые выполняют определенные функции, для получения нужной тебе функциональности системы на кристалле (system-on-chip).
На высоком уровне проектирования ты уже не будешь контролировать данные на каждом такте, вместо этого сконцентрируешься на алгоритме. Существуют компиляторы или трансляторы с языков C и C++ на уровень RTL, например Vivado HLS. Он довольно умный и позволяет транслировать на аппаратный уровень широкий класс алгоритмов.
Главное преимущество такого подхода перед языками RTL — ускорение разработки и особенно тестирования алгоритма: код на C++ можно запустить и верифицировать на компьютере, и это будет намного быстрее, чем тестировать изменения алгоритма на уровне RTL. За удобство, конечно, придется заплатить — схема может получиться не такой быстрой и займет больше аппаратных ресурсов.
Часто мы готовы платить эту цену: если грамотно использовать транслятор, то эффективность не сильно пострадает, а ресурсов в современных FPGA достаточно. В нашем мире с критичным показателем time to market это оказывается оправданным.
Часто в одном дизайне нужно совместить все три стиля разработки. Допустим, нам нужно сделать устройство, которое мы могли бы встроить в робота и наделить его способностью распознавать объекты в видеопотоке — например, дорожные знаки. Возьмем микросхему видеосенсора и подключим ее напрямую к FPGA. Для отладки можем использовать монитор HDMI, тоже подключенный к FPGA.
Кадры с камеры будут передаваться в FPGA по интерфейсу, который заведомо определен производителем сенсора (USB тут не катит), обрабатываться и выводиться на монитор. Для обработки кадров понадобится фреймбуфер, который обычно находится во внешней памяти DDR, установленной на печатной плате рядом с микросхемой FPGA.
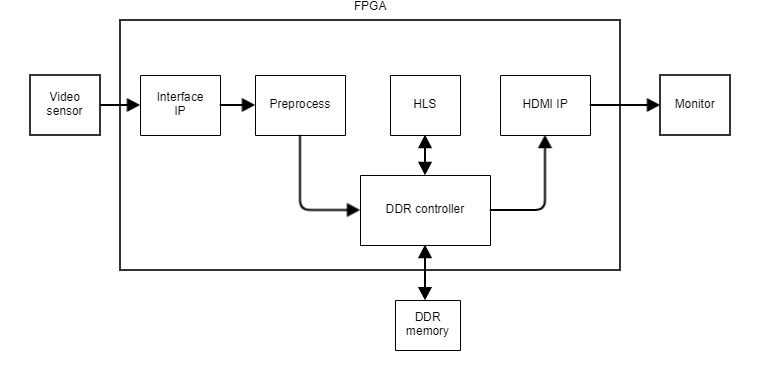
Типичная блок-схема проекта FPGA
Если производитель видеосенсора не предоставляет Interface IP для нашей микросхемы FPGA, то нам придется писать его самостоятельно на языке RTL, считая такты, биты и байты в соответствии со спецификацией протокола передачи данных. Блоки Preprocess, DDR Controller и HDMI IP мы, скорее всего, возьмем готовые и просто соединим их интерфейсы. А блок HLS, который выполняет поиск и обработку поступающих данных, мы можем написать на C++ и транслировать при помощи Vivado HLS.
Скорее всего, нам еще потребуется какая-то готовая библиотека детектора и классификатора дорожных знаков, адаптированная для использования в FPGA. В этом примере я, конечно, привожу сильно упрощенную блок-схему дизайна, но логику работы она отражает корректно.
Рассмотрим путь проектирования от написания кода RTL до получения конфигурационного файла для загрузки в FPGA.
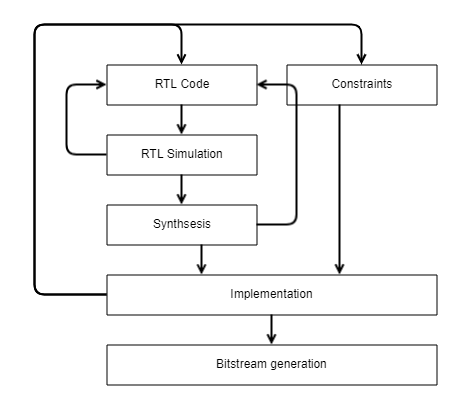
Путь проектирования
Итак, ты пишешь код RTL, который реализует нужную тебе схему. Прежде чем его проверять на реальном железе, надо убедиться, что он верный и корректно решает требуемую задачу. Для этого используется RTL-моделирование в симуляторе на компьютере.
Ты берешь свою схему, представленную пока только в коде RTL, и помещаешь ее на виртуальный стенд, где подаешь последовательности цифровых сигналов на входы схемы, регистрируешь выходные диаграммы, зависимости от времени выходных сигналов и сравниваешь с ожидаемыми результатами. Обычно ты находишь ошибки и возвращаешься к написанию RTL.
Далее логически верифицированный код подается на вход программе-синтезатору. Она преобразует текстовое описание схемы в связанный список цифровых элементов из библиотеки, доступной для данного кристалла FPGA. В этом списке будут отображены такие элементы, как LUT, триггеры, и связи между ними. На этой стадии элементы пока никак не привязаны к конкретным аппаратным ресурсам. Чтобы это сделать, требуется наложить на схему ограничения (Constraints) — в частности, указать, с какими физическими контактами ввода-вывода микросхемы FPGA связаны логические входы и выходы твоей схемы.
В этих ограничениях также требуется указать, на каких тактовых частотах должна работать схема. Выход синтезатора и файл ограничений отдаются процессору Implementation, который, помимо прочего, занимается размещением и трассировкой (Place and Route).
Процесс Place каждый пока еще обезличенный элемент из netlist привязывает к конкретному элементу внутри микросхемы FPGA. Далее начинает работу процесс Route, который пытается найти оптимальное соединение этих элементов для соответствующей конфигурации коммутационной матрицы ПЛИС.
Place и Route действуют, исходя из ограничений, наложенных нами на схему: контактами ввода-вывода и тактовой частотой. Период тактовой частоты очень сильно влияет на Implementation: он не должен быть меньше, чем временная задержка на логических элементах в критической цепи между двумя последовательными триггерами.
Часто сразу удовлетворить это требование не удается, и тогда надо вернуться на начальный этап и изменить код RTL: например, попытаться сократить логику в критической цепи. После успешного завершения Implementation нам известно, какие элементы где находятся и как они связаны.
Только после этого запускается процесс создания бинарного файла прошивки FPGA. Остается его загрузить в реальное железо и проверить, работает ли оно так, как ожидалось. Если на этом этапе возникают проблемы, значит, моделирование было неполным и на этом этапе не были устранены все ошибки и недочеты.
Можно вернуться на стадию симуляции и смоделировать нештатную ситуацию, а если и это не сработает, на крайний случай предусмотрен механизм отладки непосредственно в работающем железе. Ты можешь указать, какие сигналы хочешь отслеживать во времени, и среда разработки сгенерирует дополнительную схему логического анализатора, которая размещается на кристалле рядом с твоей разрабатываемой схемой, подключается к интересующим тебя сигналам и сохраняет их значения во времени. Сохраненные временные диаграммы нужных сигналов можно выгрузить на компьютер и проанализировать.
Существуют и высокоуровневые средства разработки (HLS, High-level synthesis), и даже готовые фреймворки для создания нейросетей в ПЛИС. Эти средства на выходе генерят код RTL на языках VHDL или Verilog, который дальше спускается по цепочке Synthesis → Implementation → Bitstream generation. Ими вполне можно пользоваться, но, чтобы использовать их эффективно, надо иметь хотя бы минимальное представление о языках уровня RTL.
Продолжение следует
Надеюсь, теория тебя не слишком загрузила! В следующей статье я расскажу о практике: мы посмотрим, что конкретно нужно делать, чтобы запрограммировать FPGA.
What is FPGA?

Field Programmable Gate Arrays (FPGAs) are semiconductor devices that are based around a matrix of configurable logic blocks (CLBs) connected via programmable interconnects. FPGAs can be reprogrammed to desired application or functionality requirements after manufacturing.
The acceleration methods for neural network are mainly divided into two types:
- Software design optimization.
- Hardware design improvement.
Acceleration methods
Software design optimization goal is to reduce the computation or bandwidth requirements of the neural network. Again, there are three different ways:
- Optimization of Algorithm Procedure.
- Data quantification.
- weight reduction.
The optimization of algorithm is a kind of procedure for different neural network models and the calculation processes is transformed without any affect in the result.
Data Quantification is used to reduce the bandwidth and storage requirements in neural network computing.
Weight reduction is to use a low rank matrix so that the actual weight is reduced by reducing the total calculation of the model.
Designing Accelerators
Utilizing FPGA design accelerators for specific problems is currently the most extensive area of FPGA accelerator applications. Designing an accelerator specifically for a specific problem, it not only fits the problem well but also has a relatively small design difficulty. Designing accelerators for specific problems often speed up the reasoning process of deeplearning algorithms rather than the learning process.
Advantages and Disadvantages:
Some of the advantages of FPGA based accelerator are its high performance even with low energy. Also, high parallelism is the main property of choosing FPGA platform.
FPGA can be applied to complex engineering situation due to the reconfiguability.
On the other hand the cost of reconfiguration is one of its dimerit.
Also, it requires hardware programming generally using hardware programming languages that would cost programmers much time to master.
Without a doubtAccelerating deep learning algorithms is a study that has increased many attentions in recent years. Although FPGA/ASIC also has such a good acceleration capability, it is only popularized in the research field due to programming complexity and other issues